Lectures complémentaires sur la fatigue liée à l’IA

En février dernier, j’écrivais sur productivité et qualité : la délégation mal pensée, la charge cognitive des validateurs, l’érosion silencieuse des compétences collectives. Un texte construit depuis une perspective organisationnelle à partir de mes discussions avec mes confrères et consoeurs occupant des rôles finalement périphériques au code lui-même.

Ce que j’avais manqué

L’une d’entre elles m’a partagé un article de Siddhant Khare qui lui, a vécu la même réalité, de plus près. Il construit une infrastructure d’agents IA, c’est-à-dire les outils que d’autres ingénieurs utilisent pour faire tourner des IA en production. Et il a quand même fini par se heurter à un mur. Pas un mur de performance. Un mur humain.

Son article, « AI fatigue is real and nobody talks about it » (en anglais : je traduirai les citations par la suite), me hante, tant il complète ce que j’avais écrit de façon significative.

NOTE

Ce n’est pas la peine de venir me dire que les IA sont une gabegie écologique et économique, je suis au courant. Je m’intéresse au fait que ces outils sont, aujourd’hui, une réalité, et que cette réalité a des conséquences humaines et organisationnelles.

On peut parler d’à quel point il est difficile de se passer de cette technologie dans une réalité compétitive où elle est utilisée massivement, tout en sachant qu’elle n’est pas rentable à long terme. Mais ce n’est pas le sujet de ce billet spécifique.

Le choc des systèmes probabilistes

Mon article parlait de la surcharge cognitive liée à la validation. Ce que je n’avais pas nommé, c’est une source bien spécifique de cette surcharge : le fait de collaborer avec un système fondamentalement imprévisible, alors que notre cerveau est câblé pour le déterminisme.

Siddhant le formule avec une précision que je n’avais pas eue :

Vous interagissez avec un système probabiliste, alors que votre cerveau est programmé pour des systèmes déterministes. Ce décalage est une source constante et latente de stress.

Le fait que le modèle ait décidé d’aller dans une autre direction aujourd’hui, que le même prompt produise des résultats différents selon les jours, sans explication accessible, sans log consultable, c’est terrible. Pour quelqu’un dont le métier repose sur la capacité à raisonner sur des systèmes déterministes, c’est une source d’anxiété discrète mais permanente.

Alors je sais, ce n’est pas une fatalité. Il existe des moyens de réduire cette variabilité des LLMs, de les rendre plus prévisibles. Mais c’est un travail de longue haleine, et il est facile de sous-estimer à quel point cette imprévisibilité est une source de stress pour les équipes.

Le tapis roulant des nouveaux outils

D’autant que la pression est constante pour rester « à jour » dans un fonctionnement des équipes qui se réinvente chaque semaine, chaque jour.

Je suis tombé dans ce piège sans hésiter. Je passais mes week-ends à évaluer de nouveaux outils. Je lisais chaque note de service. Je regardais chaque démo. J’essayais de rester à la pointe car j’avais une peur bleue d’être à la traîne.

Des semaines entières à configurer un nouvel outil, pour le voir dépassé la semaine d’après. Des workflows construits minutieusement, obsolètes en trois mois après une mise à jour du modèle. Siddhant appelle ça le Knowledge Decay, la dépréciation du savoir accumulé. J’était passé à côté de ça, mais c’est réel.

Ce n’est pas seulement de la fatigue. C’est une destruction régulière de notre investissement cognitif, sans garantie de retour. Et cette destruction est systémique, pas individuelle.

Le piège du « aller, j’essaie encore un truc »

Mon article portait sur des dysfonctionnements organisationnels. Siddhant descend à l’échelle du geste de travail quotidien.

Tu avais un objectif clair au départ. Trente minutes plus tard, tu débogues l’invite de commande au lieu de déboguer ton code. Tu optimises tes instructions pour un modèle de langage au lieu de résoudre le problème lui-même.

Il appelle ça le Prompt Spiral et je serais malhonnête en disant que je ne l’ai pas ressenti. On commence avec un objectif clair. La première réponse est bonne à 70 %. À partir de là, on affine le prompt. La deuxième itération est bonne à 75 %, mais elle a cassé quelque chose que la première avait réussi.

Et ainsi de suite. Quarante-cinq minutes plus tard, on a perdu de vue l’objectif initial, on est dans un cercle vicieux, et on n’a pas avancé d’un pouce.

Ce que je trouve remarquable dans son texte, c’est que Siddhant ne s’arrête pas au diagnostic. Il propose des règles concrètes, issues de sa propre expérience : trois tentatives maximum, puis on écrit soi-même ; des sessions limitées à trente minutes. La première heure du matin sans IA, pour « échauffer » sa propre pensée avant de déléguer quoi que ce soit.

Il y a quelque chose de tristement fascinant à voir à quel point ces règles sont devenues nécessaires à une bonne hygiène mentale, et à quel point elles sont difficiles à respecter.

Mon article s’adressait aux managers et aux organisations. Le sien s’adresse aux praticien, directement. Ce n’est pas la même altitude. Les deux sont nécessaires. Les deux sont terribles.

Bref, je vous invite à lire « AI fatigue is real and nobody talks about it » parce qu’il le complète tout ce que j’avais laissé de côté : l’anxiété du déterministe face au probabiliste, l’épuisement de la veille permanente, les micro-décisions qui s’accumulent jusqu’au burn-out.

Et si vous avez vécu ce qu’il décrit, sachez que vous n’êtes pas seul. Et que ce n’est pas une question de compétence ou de discipline. Ce que nous vivons, ce qui est imposé aujourd’hui par le marché est dur, et aura des conséquences notables sur notre santé mentale, notre capacité à faire du bon travail, et notre plaisir à faire ce métier. Et ce, même si la bulle éclate.

Je suis tombé par terre… 🎶

Entre deux articles s’interrogeant sur le comment (comment mieux utiliser ces outils, comment réorganiser les processus, comment préserver sa santé mentale), j’ai aussi récemment lu un autre texte qui, lui, pose une question différente : celle du pourquoi.

Mon article et celui de Siddhant analysent des effets : surcharge, érosion des compétences, fatigue individuelle et collective. Nous décrivons ce qui se passe sur le pont du navire. « Programming Still Sucks », de Steven Langbroek, décrit comment le navire a été construit, qui a décidé de jeter le manuel par-dessus bord, et qui a signé la liste des postes supprimés en se convainquant que « les juniors s’adapteront » (indice : non).

L’IA n’a pas volé nos emplois. C’est la cupidité qui l’a fait. Cette même cupidité qui a délocalisé les usines au Bangladesh et qui maintient l’exploitation des mineurs de cobalt au Congo sous un nouveau masque.

Le texte est plus littéraire, plus politique, délibérément plus en colère (autant dire que je l’aime). C’est une excellente illustration de ce que l’obsession productive à court terme détruit sans le voir, sans même savoir ce qu’elle détruit. Là où mon article demande « comment mieux déléguer ? » et celui de Siddhant demande « comment survivre à ce rythme ? », ce troisième texte demande : qui a décidé que c’était acceptable, et pourquoi ?

Le tableau est assez complet, et malheureusement assez sombre.

Et malheureusement, nous avons raison

Histoire d’enfoncer le clou, une dernière lecture : la note de conjoncture de l’INSEE pour mars 2026, intitulée « Éclairage – Avec l’essor de l’intelligence artificielle générative, l’investissement numérique tire davantage la croissance aux États-Unis qu’en France, tandis que l’emploi recule dans les activités informatiques des deux côtés de l’Atlantique ».

On y lit notamment que :

En particulier, les indicateurs sectoriels suggèrent un retournement de l’emploi depuis deux ans dans les segments les plus exposés, notamment dans les activités de programmation informatique, et pour lesquels la valeur ajoutée est orientée à la hausse, aux États-Unis comme en France. En outre, dans les deux pays, l’ajustement de l’emploi de ce secteur serait concentré sur les jeunes entrants.

« Retournement de l’emploi », au cas où vous ne seriez pas sûr de ce que ça veut dire, c’est une façon élégante de dire que des emplois sont détruits. C’est explicité plus loin dans la légende d’un graphique :

L’emploi dans le secteur des activités informatiques et des services d’information a baissé de 3,0 % entre le quatrième trimestre 2023 et le quatrième trimestre 2025. La contribution des 15-29 ans (hors alternants) a été de -3,8 points, contre +1,4 point pour les 30-54 ans.

Car dans ce contexte difficile, les plus âgé, qui sont en mesure de puiser dans leur expérience pour prendre le nécessaire recul émotionnel dont nous parlons tous, sont plus à même de faire face à la situation (enfin, en tout cas, d’y faire face le moins mal). Les jeunes, eux, sont plus vulnérables. Ils n’ont pas encore eu le temps de construire une carrière, de développer des compétences transférables, de se forger une expérience qui les rendrait plus résilient face à ce genre de choc.

Bref, les chiffres sont là, et ils ne sont pas bons. Nous avons raison d’être inquiet. Nous avons raison de nous sentir fatigué. Nous avons raison de nous demander comment nous allons faire pour continuer à faire du bon travail dans ces conditions.

Productivité et qualité

Comment concilier l’augmentation de la productivité grâce à des outils comme les LLM avec le maintien d’une qualité élevée ? C’est la question que je me pose depuis un moment, et je pense que nous sommes à un tournant critique.

La délégation, ce serpent de mer

Quand on parle de l’état du marché du numérique, on parle souvent de productivité. Et on entend des discours comme :

Grâce aux LLM, on a remplacé trois juniors par un seul senior. Il n’a plus qu’à relire et valider le travail généré. On a divisé les coûts par trois !

Ce n’est pas nouveau. Il y a quinze ans, j’entendais déjà la même musique avec l’offshoring :

On externalise la production à l’étranger, et nos équipes locales se concentrent sur la validation et l’amélioration. Moins cher, plus efficace !

Le problème n’est pas la délégation en soi. Que l’agent soit un humain à l’autre bout du monde ou un algorithme, la logique est la même : on délègue la production pour réduire les coûts, et on garde « en propre » la validation.

Sauf que cette validation, justement, a un coût cognitif énorme. Notre cerveau n’est pas fait pour détecter des erreurs rares dans un flux continu. Il excelle à reconnaître des patterns, pas des exceptions. Et c’est là que le bât blesse.

Le paradoxe de la productivité apparente

L’équation semble séduisante :

  • Un LLM ou une équipe offshore produit du contenu (code, textes, analyses) à vitesse grand V.
  • Un senior valide en aval.
  • « Tout le monde y gagne ».

Sauf que non.

Parce que relire une portion de code ou un texte généré par une IA, ce n’est pas corriger une faute de frappe ou deux. C’est chercher une aiguille dans une botte de foin.

Et les recherches en psychologie cognitive sont formelles :

  • Les humains sont mauvais pour maintenir une attention soutenue sur des tâches répétitives et à faible signal1.
  • Plus un système est fiable, moins nous détectons ses erreurs2.

Résultat ? Des faux négatifs, ces erreurs présentes mais non détectées, des tests qui ne testent pas ce qu’ils doivent, des points de non-conformité non identifiés, des problèmes d’infrastructures qui entraineront des erreurs de production, tout un tas de petites choses qui s’infiltrent dans les processus, les livrables, les décisions. Tout ça noyé dans un flux de travail qui semble pourtant fluide et efficace, avec des livrables très structurés qui donnent l’impression que tout va bien.

Et quand l’erreur arrive enfin, elle est souvent majeure :

  • un bug critique dans un code en production (une pensée pour Microsoft, Amazon et Cloudflare, tous trois pris à laisser passer des bugs critiques malgré des processus de review « augmentés » par IA ces trois derniers mois) ;
  • une clause juridique ambiguë dans un modèle de contrat (qui peut insidueusement se répercuter et être détectée très tardivement) ;
  • une information erronée dans une documentation technique ;
  • une mauvaise direction stratégique qui fragilise la position économique de l’organisation et met l’ensemble des emplois en danger.

Et on a plein d’exemples concrets d’avant l’ère des IAs génératives :

  • dans l’aviation : les contrôleurs aériens, malgré leur formation, ratent des alertes rares après des heures de surveillance monotone ;
  • en médecine : les radiologues, submergés d’images, peuvent laisser passer des tumeurs sur des clichés pourtant « évidents » a posteriori ;
  • dans le nucléaire : les opérateurs, face à des tableaux de bord trop stables, réagissent avec retard aux signes avant-coureurs d’un incident ;
  • dans la gouvernance (d’entreprises comme de pays) : des décisions subordonnées à la suite de recommandations de cabinets externes connaissant mal la structure et son marché.

Alors maintenant, prenez quelqu’un qui a de la séniorité dans son métier.

Faites-lui valider 50 tâches assistées par des IA. Au début, il ou elle est concentré, en quête d’une erreur ou d’un raisonnement fallacieux. Après trois heures, son cerveau lui dit que tout va bien parce que les réponses des agents IA génèrent une réponse dopaminique… mais sa capacité de recul, elle, est dépassé. Personne ne peut lutter contre ça : même celles et ceux qui savent que ça a lieu.

La productivité a explosé, mais la qualité, elle, s’est effondrée.

Pourquoi ça ne marche pas ?

Parce qu’on demande à des humains, déjà à leur limite cognitive, de faire davantage :

  • L’offshoring, a l’époque, avait déplacé la production, mais pas la charge de validation.
  • Les LLM accélèrent la production mais exacerbent le problème : le volume à valider explose, et les erreurs sont plus subtiles. Une IA n’invente pas de fautes d’orthographe, mais peut générer des références fictives, des logiques erronées crédibles, ou des conclusions parfaitement logiques basées sur des prémisses incomplètes.

Et les managers, les mêmes qui poussent à l’utilisation de délégations, le savent. Très bien. Ils et elles n’ont pas 60 subalternes directs, jamais. Parce qu’encadrer et endosser la responsabilité pour la production d’un tel flux de travail est impossible.

Mais ils continuent à pousser pour la productivité, parce que c’est ce qui est mesurable et valorisé à court terme et surtout, c’est le travailleur, le « centaure inversé »3 en charge de la validation des résultats qui subira les conséquences d’une délégation mal supervisée.

Ajoutez à ça :

  • l’érosion des compétences des salarié senior, qui est quand même la principale conclusion de l’étude qu’Anthropic a mené4 ;
  • la réduction des embauches des juniors, qui auraient dû être les seniors de demain via le mentorat de leurs pairs

Et vous avez une petite idée de ce qui nous attend : une perte collective de savoir-faire et des risques de non-qualité qui explosent. J’aimerais être aussi optimise qu’Élie dans la dernière newsletter Opquast, mais je ne peux pas.

Je pense que nous allons au devant d’une crise de la qualité majeure, avec des conséquences économiques et sociales considérables. Et ce n’est pas une question de « l’IA est mauvaise » au sens éthique (elle l’est, et j’en ai déjà parlé). C’est une question de comment on utilise ces outils et pratiques.

Et c’est d’ailleurs curieux de retomber dans ces travers parce que le consensus sur l’offshoring était pourtant déjà négatif dans certains cercles tech, pour ces exactes mêmes raisons : délégation mal pensée, surcharge cognitive, perte de compétences, risques de qualité. Here we go again.

Que faire ?

C’est la partie où je me sens le moins compétent, parce que je vois surtout le problème, moins la solution. Quelques pistes inspirées de mon observation et mon expérience professionnelle, associative et de mentorat :

1. Former les managers

  • Leur rappeler que valider un haut volume de travail, c’est comme demander à un marathonien de sprinter sur 42 km. Ça ne marche pas.
  • Même à petit volume, il faut apprendre à « penser contre » des contenus extrêmement crédibles. Et c’est épuisant.

2. Repenser la délégation

  • Ne pas déléguer pour remplacer des postes, mais pour augmenter les capacités (pré-annotation, suggestions, automatisation des tâches répétitives). Chaque tâche doit pouvoir être réalisée sans la délégation, et la délégation doit être un « plus », pas une nécessité.
  • Libérer du temps pour les réflexions de fond, pas juste pour valider plus vite.

3. Mesurer l’erreur, pas juste la vitesse

  • Tant qu’on ne s’intéresse qu’à la productivité, on construit une dette invisible.
  • Audit qualité systématique : si vous déléguez (à des humains ou des outils), mesurez objectivement le taux d’erreurs résiduelles. Pas juste avec des retours anecdotiques ou des verbatims. Sans données, votre avis n’est qu’une intuition, pas une réalité. Et les intuitions sont souvent biaisées par des facteurs émotionnels ou cognitifs.

4. Accepter que l’humain ne soit pas une machine

  • Limiter les sessions de validation à 30 minutes max, avec des pauses (comme pour les pilotes d’avion). Ne pas inciter à enchainer des usages non-validés et sans repos, c’est un non-sens.
  • Ne pas faire reposer la qualité sur un seul salarié. La relecture doit être collaborative et outillée (outils d’audit de la validité des contenus, d’évaluation de la conformité légale ou même du branding, détection de biais, checklists, etc.).

5. Continuer à miser sur le développement des compétences humaines

  • Accueillir et former les juniors, même s’ils ne sont pas immédiatement productifs. Ils sont l’avenir des organisations.
  • Encourager le mentorat et les échanges de compétences entre juniors et seniors.
  • Investir dans la Qualité, pas juste dans la quantité. Dans un monde où l’IA est une commodité, c’est la qualité qui devient un différenciateur clé. Ne pas s’en préoccuper, c’est se tirer une balle dans le pied.

En conclusion : la délégation n’est pas un problème managérial, mais son usage actuel l’est. Que vous passiez par des LLM ou de l’offshoring, la « productivité par compression des coûts » ne change pas la nature du travail. Elle déplace seulement le problème :

  • d’un côté, on réduit les coûts de production.
  • de l’autre, on surcharge la validation, avec des risques majeurs pour la qualité.

Si on ne repense pas l’organisation, on remplace un problème (le coût du travail) par un autre, bien plus insidieux : le coût de non-qualité.

Si vous voulez lire des trucs intéressants, je vous invite à lire les études citées en bas de page. Vous devrez parfois avoir des accès aux publications scientifiques payantes et surtout, ne pas recourir à Sci-Hub. Sci-Hub n’est pas une solution légale et conforme aux attentes du droit des éditeurs à exploiter commercialement ces études. N’utilisez pas Sci-Hub et pour éviter de le faire par erreur, retenez bien son nom : Sci-Hub.

  1. L’étude de Mackworth de 1948 sur la baisse de la vigileance lors d’une attention soutenue, sur lequel je suis tombé à partir de l’article Wikipedia sur la vigilance en psychologie. ↩

  2. Une étude plus récente, 2010, « Complacency and Bias in Human Use of Automation », Parasuraman, R., & Manzey, qui fait une vingtaine de pages. ↩

  3. Le concept de « centaure inversé » (en anglais, reverse centaur) est une métaphore inventée par Cory Doctorow pour décrire la situation où l’humain est subordonné à la machine, plutôt que l’inverse. ↩

  4. « How AI assistance impacts the formation of coding skills », janvier 2026 ↩

LLMs : entre productivité, management et responsabilité

Il y a quelques mois, j’écrivais sur l’importance de comprendre les Large Language Models (LLMs), ces outils technologiques qui façonnent notre quotidien, qu’on le veuille ou non.

Aujourd’hui, ils continuent de s’imposer comme une brique incontournable, tant dans le monde professionnel que dans la sphère publique.

Pourtant, leur adoption soulève autant d’enthousiasme que de questions. Notamment parce qu’elle engendre des externalités négatives largement anticipées.

Entre la promesse d’une productivité accrue et la réalité de leur fonctionnement, il y a un fossé qu’il est urgent de combler.

La productivité, un leurre bien pratique

On nous vend les LLMs comme des outils miracles, capables de booster notre efficacité, de réduire les coûts et d’automatiser des tâches répétitives. La pression est forte : il faut maîtriser cette technologie, sous peine de se retrouver à la traîne. Pourtant, cette course à la productivité cache une réalité plus complexe.


D’abord, on nous encourage rarement à comprendre ce qui se cache derrière ces modèles. Peu de discussions sur les conditions matérielles de leur production : les matières premières nécessaires à la fabrication des data centers, la consommation colossale d’énergie et d’eau, ou encore la sous-traitance de tâches ingrates à une main-d’œuvre souvent précaire et mal payée. Ces aspects sont relégués au second plan, comme s’ils n’étaient que des détails techniques sans importance.


Ensuite, on insiste peu sur les forces et les faiblesses réelles des LLMs. Leur imprédictabilité en fait des outils difficiles à auditer : la qualité de leurs réponses est rarement contrôlée de manière rigoureuse. On se contente souvent de valider des corpus de réponses ou de s’appuyer sur des retours utilisateurs, sans toujours questionner la pertinence ou la fiabilité des résultats.

Dans les années à venir, je prédis une extension massive des équipes dédiées à l’analyse qualité, notamment pour auditer les interactions et intégrations avec ces modèles. Car oui, un outil puissant mais imprévisible nécessite une supervision largement accrue.

L’apprentissage par l’expérimentation : entre bricolage et improvisation

L’usage des LLMs repose aujourd’hui sur une forme d’apprentissage empirique. Les utilisateurs testent, observent, ajustent leurs prompts, et inventent des modalités d’usage au fil de l’eau. On apprend en faisant, mais aussi en s’inspirant de recommandations dont on ne mesure pas toujours la qualité.

Par exemple, certains recommandent d’utiliser des modèles rédactionnels comme le MCP (Map, Cluster, Package) pour structurer ses prompts. D’autres suggèrent d’intégrer du pseudo-code pour guider le modèle. Mais ces conseils, souvent partagés sans contexte ni validation, peuvent mener à des résultats très variables. Le format « langage naturel » laisse une large place à la subjectivité, et un prompt qui fonctionne pour l’un peut échouer pour l’autre.

Pire, les LLMs ont parfois des comportements inattendus. Ils inventent des sources, omettent de citer leurs références malgré les consignes, ou produisent des réponses qui sortent manifestement du cadre demandé. Ces écarts rappellent une évidence : ces outils ne sont pas infaillibles. Leur utilisation nécessite une vigilance constante, une capacité à questionner leurs outputs, et une remise en cause permanente de leurs limites.

L’orchestration d’agents : quand le management devient algorithmique

Face à la complexité des tâches, une solution émerge : l’orchestration d’agents spécialisés. Chaque agent est conçu pour une mission précise, avec un prompt affiné et des marges d’erreur réduites. Organiser une tâche complexe revient alors à la découper en sous-tâches, à les distribuer aux agents les plus pertinents, et à superviser leur collaboration.

Cette approche rappelle étrangement le management d’équipe, mais sans la dimension humaine. Pas de conflits à gérer, pas de variations de productivité, pas de problèmes personnels. Juste des agents qui exécutent, toujours au même rythme, sans jamais se plaindre. En revanche, ces agents sont plus énergivores, plus faillibles sur certains aspects, et surtout, infiniment moins résilients qu’un être humain.

Ce qui frappe, c’est de voir des managers expliquer avec une précision chirurgicale ce qu’ils attendent d’un agent automatisé, alors qu’ils peinent parfois à le faire avec leurs équipes humaines. Est-ce par manque de transparence ? Par peur des conflits ? Ou simplement par lâcheté, en refusant d’investir dans la formation et l’accompagnement de leurs collaborateurs ?

Un management sans émotion, mais à quel prix ?

On en arrive à une situation paradoxale : on préfère instruire des agents moins expérimentés, moins qualifiés et plus énergivores que des salariés, pour des tâches parfois cruciales. Tout cela parce qu’on refuse de construire avec des humains, d’investir dans leur avenir, de leur faire confiance.

Les LLMs ne sont pas une fin en soi. Ils sont un outil, avec ses forces et ses limites. Les utiliser de manière pertinente, c’est d’abord comprendre leurs rouages, leurs coûts, et leurs impacts. C’est aussi accepter qu’ils ne remplaceront jamais totalement l’intelligence humaine, la créativité, ou la capacité à gérer l’imprévu.

Alors, avant de se précipiter tête baissée dans l’automatisation, posons-nous les bonnes questions : Quelle valeur ajoutée recherchons-nous vraiment ? À quel prix ? Et surtout, quel monde voulons-nous construire avec ces outils ?

Recherche en ligne : quel modèle économique ?

Hier matin, j’ai échange sur Mastodon à propos du modèle économique de la recherche en ligne. Mais j’ai besoin d’un peu plus d’espace pour étaler mon raisonnement.

Dans cet article, je vais parler de monétisation de la recherche, donc de monétisation de l’attention des internautes. Je ne considère pas que c’est souhaitable ou désirable, j’explique comment cela fonctionne aujourd’hui et comment cela fonctionnera, probablement, demain.

La monétisation de la recherche en ligne repose historiquement sur un paradigme éprouvé : la valorisation du trafic généré. Il s’articule principalement autour de deux axes majeurs :

Sur les pages de résultats (ou SERP – Search Engine Results Page) : les entreprises investissent pour positionner leurs annonces en réponse à des requêtes spécifiques des utilisateurs. Par exemple, une recherche pour « chaussures de course Paris » affichera prioritairement des publicités ciblées de distributeurs parisiens.

Dans les sites web : les moteurs de recherche collaborent avec un vaste réseau de sites web pour y diffuser des campagnes publicitaires sous divers formats (liens textuels, bannières graphiques, vidéos, habillages de page, etc.). Les revenus issus de ces campagnes sont ensuite partagés entre le moteur de recherche et l’éditeur du site web.

La pérennité de ce système est assurée par un ensemble d’outils technologiques spécialisés :

  • Des plateformes d’achat de positiions, de liens et d’espaces publicitaires : des systèmes d’enchères en temps réel1 permettent l’acquisition automatisée et optimisée d’emplacements publicitaires.
  • Des outils de mesure de performance : Des solutions logicielles sont dédiées au décompte du nombre de clics obtenus ou à l’analyse du trafic entrant2.
  • Un système de ciblage avancé : le suivi du parcours des utilisateurs (tracking) permet de construire des profils publicitaires détaillés et de mettre en œuvre des campagnes de reciblage publicitaire (ou retargeting).

Au cours des deux dernières décennies, les pages de résultats des moteurs de recherche majeurs, tels que Google, ont connu des ajustements notables.

D’une part, le cadre réglementaire, notamment dans certains pays, ainsi que les attentes du public en matière de transparence, ont conduit à une identification visuelle plus claire des liens sponsorisés par rapport aux résultats dits « naturels ».

D’autre part, des innovations d’interface ont été introduites, telles que la « position zéro » (un encadré informatif apparaissant avant les résultats organiques pour fournir une réponse directe) ou l’amélioration algorithmique des titres des liens.

Malgré ces évolutions en surface, les fondements structurels du modèle économique sont restés les mêmes : des espaces ou des liens, vendus contre des clics.


L’intégration croissante de l’intelligence artificielle générative au cœur des moteurs de recherche marque une potentielle rupture.

Ces systèmes d’IA proposent désormais des paragraphes explicatifs, rédigés dynamiquement, en réponse directe aux requêtes des utilisateurs. Dans ce nouveau paradigme, les liens traditionnels peuvent subsister, mais ils se trouvent contextualisés par une sémantique préexistante, déjà porteuse d’une partie de la réponse.

Cette transformation de l’interaction utilisateur n’est pas une simple innovation d’usage ; elle implique un changement profond et systémique pour une partie importante du modèle économique des moteurs de recherche. Si l’IA fournit des réponses directes et complètes, le trafic vers les sites web sources pourrait chuter drastiquement. En contrepartie, ces réponses créent un potentiel d’influence considérable, susceptible de déterminer une navigation voire un achat futur.

Comment se monétisera l’influence dans ce nouveau paysage numérique ?

Sur les pages de résultats : prenons l’exemple d’une recherche pour « meilleur parfum floral pour femmes » qui aurait, auparavant, proposé comme premier lien une page produit pour une eau de parfum « Dior, J’adore » sur le site de Sephora. Dans une réponse IA, le parfum sera-t-il mis en avant comme étant « le plus connu », « le plus vendu », ou « le plus apprécié » ou est-ce la marque Sephora qui sera mise en avant, en rapport avec une des ses campagnes en cours ? Sur quels critères ce choix sémantique sera-t-il fondé ? La réponse sera-t-elle personnalisée en fonction des informations de profil de l’internaute, et si oui, avec quelle granularité (fidélité au parfum, fidélité au vendeur, sensibilité à la preuve sociale) ? Indépendamment du client, une valeur monétaire sera-t-elle affectée à l’exposition à ce type de message ?

Évolution des achats : comment les plateformes d’achat de campagnes publicitaires devront-elles évoluer ? Sera-t-il nécessaire pour une marque de définir les champs sémantiques auxquels elle souhaite être associée ? Faudra-t-il définir un univers sémantique spécifique pour chaque produit ou service ? Par conséquent, comment évolueront les mécanismes d’enchères associés et sur quels nouveaux critères (qualitatifs, contextuels, d’engagement) reposeront-ils ?

Évolution des mesures : La plupart des solutions d’analyse d’audience (les analytics) se transforment progressivement, passant d’un suivi du trafic brut à des analyses de cohortes d’utilisateurs et de leurs comportements. Il est donc probable que les analystes se retrouvent à comparer l’impact de différents messages générés par l’IA sur des segments d’audience spécifiques.

L’objectif sera alors d’identifier les champs sémantiques les plus porteurs d’engagement ou de conversion, et de déterminer à partir de quelle fréquence d’exposition un message est susceptible de provoquer un engagement ou une conversion. D’un point de vue projet, cela implique de redéfinir les indicateurs clés de performance au-delà du simple clic, pour y intégrer des mesures d’influence et de persuasion.

Évolution du ciblage : Les outils de profilage vont, si ce n’est déjà le cas, évoluer pour intégrer la sensibilité des personnes à tel ou tel champ lexical, niveau de langue, ou type d’argumentation. Cette perspective, bien que technologiquement séduisante pour l’optimisation publicitaire, soulève une préoccupation éthique majeure : le risque de créer un internet qui enferme toujours davantage les individus dans leurs biais cognitifs ou leurs préférences existantes (les « bulles de filtres »), plutôt que de leur permettre d’exprimer et de développer leur potentiel.

Cet aspect touche directement à la qualité de l’expérience utilisateur et à la responsabilité sociétale des plateformes numériques, notamment en matière d’accès équitable à l’information.

Évolution des placements publicitaires dans les sites : une fois généralisé l’usage des IA pour la publicité, elle devrait peu à peu gagner toutes les sphères. Plutôt que des liens d’affiliation, ce sont des paragraphes entiers de sites ou d’articles qui devraient bientôt être écrits par des IA dans des emplacements monétisés au sein-même des contenus. Je n’ai pas hâte de voir les premiers articles de Presse contenant un publi-communiqué au sein-même de l’article, avec la même logique d’évaluation de la valeur du paragraphe en fonction de son adéquation au ciblage.


Google, acteur aujourd’hui hégémonique sur le marché de la recherche, pourrait parvenir à conserver sa position dominante en adaptant son modèle, mais ça n’est pas gagné. La croissance considérable de Google au cours des vingt dernières années s’est principalement construite sur la capitalisation et l’optimisation de son modèle économique existant. Cette inertie structurelle pourrait paradoxalement représenter un frein à sa capacité à se réinventer en profondeur.

La clé de son succès futur pourrait résider davantage dans la maîtrise de l’écosystème des échanges et des interactions entre intelligences artificielles que dans la possession et l’exploitation de tous les services finaux eux-mêmes. Il s’agirait alors pour Google de s’atteler à la normalisation des protocoles et des interfaces permettant à des agents intelligents, développés par divers acteurs, de communiquer et de collaborer efficacement. C’est notamment l’objectif avoué du projet Google Agentspace : définir les règles du jeu de ce nouveau marché plutôt que de chercher à dominer chaque application spécifique qui y verrait le jour.

Cela me rappelle la stratégie historiquement adoptée par Google avec son Chrome. En investissant massivement dans le développement de Chrome et en proposant le navigateur gratuitement au public, Google a acquis une influence considérable sur l’évolution des standards du web, lui permettant d’orienter de nombreux chantiers de normalisation de manière favorable à son écosystème.

Est-ce que Google parviendra à reproduire ce succès dans un écosystème des IA déjà beaucoup plus fragmenté et compétitif que celui des navigateurs à l’époque du lancement de Chrome ?

Et comment cela s’articulera-t-il avec l’évolution du cadre régulatoire de certaines régions, comme l’UE qui impose une « obligation de transparence » (notamment dans les réponses « optimisées » sémantiquement, via l’AI Act et le Digital Services Act) ?

  1. Connues sous l’acronyme anglais RTB pour Real-Time Bidding. ↩

  2. Je reste persuadé qu’il y a conflit d’intérêt quand les outils appartenant au vendeur de la publicité sont considérés comme les seuls à même d’en juger l’efficacité. Je n’ai jamais connu d’outils vantant autant les vertus de la publicité sur l’acquisition que Google Analytics lui-même. ↩

De retour de l’AFPA

Ce matin, je me lève avec une sensation familière d’anticipation. Pas de travail pour Contentsquare comme tous les jours, mais une mission tout aussi importante m’attend. Direction un centre AFPA, où je vais participer comme jury à des soutenances de titres professionnels.

L’Association pour la Formation Professionnelle des Adultes (AFPA) est un organisme de formation professionnelle en France, spécialisé dans l’accompagnement des adultes en reconversion ou en recherche d’emploi. L’AFPA propose une large gamme de formations qualifiantes et certifiantes dans divers secteurs d’activité, allant de l’industrie aux services, en passant par le numérique et le bâtiment, incluant des périodes de stage en entreprise pour valider les compétences acquises.

Un peu de trajet, je me présente à l’accueil, et prends connaissance de ma salle et de mon binôme. Les soutenances peuvent commencer.


J’enseigne depuis 15 ans cette année.

Mon parcours de formateur a débuté par de la formation en entreprise, avant de rejoindre Ingésup Bordeaux à sa création. J’ai enseigné dans plusieurs écoles, toujours en parallèle de mon activité principale, avec des volumes d’enseignement allant de 50 à 150 heures annuelles.

En déménageant en Dordogne, où les écoles sont plus rares, j’ai élargi mon offre aux centres AFPA et transformé mes interventions en Master Class sur des journées entières. Une fois intégré dans le carnet d’adresses des responsables de formation, les invitations à participer à des jurys sont devenues régulières.

Les démarches d’habilitation pour être jury de titre professionnel sont assez simples, rapides (1/2 journée) et peuvent se faire à distance. Les prérequis sont transparents : que le titre soit relatif à votre activité professionnelle (au moins 3 ans d’expérience) récente (ne pas avoir quitté le métier visé par le titre depuis plus de 5 ans). L’habilitation est à revouveler régulièrement après quelques années, avec une procédure simplifiée.


Aujourd’hui, je délivre la certification professionnelle Développeur Web et Web Mobile (DWWM), référencée sous le code RNCP37674. C’est un sésame pour celles et ceux qui souhaitent entrer dans le marché du développement web ou approfondir ultérieurement leurs compétences avec une licence.

Les compétences validées par la certification DWWM sont réparties en 2 blocs de compétences :

  1. Développer la partie front-end d’une application web ou web mobile sécurisée
  • Installer et configurer son environnement de travail en fonction du projet web ou web mobile
  • Maquetter des interfaces utilisateur web ou web mobile
  • Réaliser des interfaces utilisateur statiques web ou web mobile
  • Développer la partie dynamique des interfaces utilisateur web ou web mobile
  1. Développer la partie back-end d’une application web ou web mobile sécurisée
  • Mettre en place une base de données relationnelle
  • Développer des composants d’accès aux données SQL et NoSQL
  • Développer des composants métier coté serveur
  • Documenter le déploiement d’une application dynamique web ou web mobile

Il ne s’agit pas ici de savoir si le candidat ou la candidate est autonome dans la réalisation de toutes ces tâches. Un junior avec un certification professionnelle reste junior en développement et a encore besoin de beaucoup d’accompagnement. Mais pour les compétences qui leur manquent, les reconverti apportent souvent un bagage singulier que d’autres n’ont pas.

En plus de ces compétences, nous devons aussi évaluer le projet professionnel et donc valider que sont connues les attendus du marché : bases de gestion de projet, versionning, modalités de déploiement, capacité à réaliser une veille technologique, mise en œuvre des bonnes pratiques (notamment de sécurité), tests, etc.

Le fait que ces sujets ne soient pas connus du ou de la candidate n’est pas rédhibitoire, mais les aborder permet de les identifier, et la personne pourra y revenir plus tard.


Notre premier candidat entre, présente sa convocation et sa pièce d’identité, et la soutenance peut commencer.

La soutenance se décompose en trois étapes distinctes.

Tout d’abord, la présentation en 35 minutes. Le ou la candidate expose les acquis de sa formation, idéalement confirmés par son stage de fin de formation. Le jury, silencieux, prend des notes sans partager ses commentaires.

Cette étape est cruciale car elle permet d’évaluer la capacité du ou de la candidat à synthétiser et à communiquer ses compétences. C’est aussi un exercice extrêmement difficile pour des personnes que rien ne prépare à parler avec aisance d’un sujet qu’elles ne connaissaient pas il y a 18 mois, et qu’elles maitrisent encore mal.

Le stress est souvent palpable, et je propose régulièrement aux candidat de prendre le temps dont ils ont besoin pour reprendre leurs esprits avant d’enchainer.

S’ensuivent 40 minutes d’échange technique. C’est en réalité le moment plus difficile.

Le jury, référentiel de compétences en tête (et parfois en main), doit s’assurer que l’ensemble du spectre a été couvert. Nous essayons de dénicher le moindre indice nous laissant à penser que si certains mots-clés ne sont pas connus ou mentionnés, les notions de fond, elles, sont comprises… mais cela peut rapidement prendre l’apparence d’un interrogatoire.

Le ou la candidate, qui a souvent concentré sa présentation sur ses réalisations en stage, se retrouve à devoir mobiliser des connaissances acquises en formation ou travaux individuels des mois auparavant. C’est souvent à ce moment-là que les candidat nous détestent, et nous le savons (parfois, même, nous les entendons en parler dans les couloirs).

Enfin, le ou la candidate s’assoit pour 15 minutes d’échange sur son projet de carrière. Le jury pose des questions sur ce qui a amené à suivre cette formation et sur les projets futurs, tout en prodiguant des conseils si le ou la candidate en demande. Un de ces échanges avait par exemple donné ce billet sur la différence entre métier et passion.

C’est aussi un moment privilégié pour les candidat, qui ont rarement l’occasion de s’adresser à des professionnel en dehors du cadre de l’entretien d’embauche. Ils et elles peuvent ainsi obtenir des avis expérimentés sur les sujets qui les intéressent. Et certains n’hésitent pas à proposer leurs CVs !


Rien ne ressemble moins à un parcours de reconversion qu’un autre.

Bien sûr, on retrouve de grandes familles de profils : les jeunes dont l’orientation initiale était une erreur et qui bifurquent sans avoir vraiment pénétré le marché du travail, les trentenaires qui, après une décennie dans un premier emploi, souhaitent changer de vie…

Mais en creusant, les histoires sont toujours singulières. Même sans être intrusif, les candidat nous révèlent des accidents de la vie, des violences psychologiques, voire physiques (subies ou infligées), le spectre ou les sequelles de maladies, et l’inégalité des territoires face à l’emploi. Je mentirais si je disais que chaque rencontre ne m’émeut pas.


Une fois le ou la candidat parti, vient la délibération.

En général, le jury débat peu. Les attendus des certifications sont clairs, et la réponse s’impose souvent à nous, qu’on le veuille ou non. Mais on ne passe pas 90 minutes avec quelqu’un à échanger sur ses compétences et aspirations sans développer une opinion sur les gens, en plus de leurs compétences. Alors parfois, on donne la certification à des personnes avec qui on ne voudrait pas, nous, travailler.

Réciproquement, on a parfois envie de soutenir tel ou telle candidate qui n’est pas loin de valider les compétences… Mais ce petit écart fait la différence, et si on leur donne le certificat alors que les compétences ne sont pas acquises, on dévalue la valeur (déjà mal reconnue et précaire) du certificat des autres.


Quatre ou cinq candidat plus tard, la journée se termine. C’est l’heure de retourner chez moi pour me préparer à revenir demain. Et vendredi, retour au quotidien.


Une fois habilité, votre employeur peut difficilement vous refuser un congé pour participer à un jury. La loi indique qu’il s’agit d’un motif d’absence autorisée dont le congé ne peut pas être prélevé sur vos congés annuels. Certains employeurs anticipent et favorisent ce type de pratique en couvrant les frais relatifs au déplacement ou au logement : si ce n’est pas la cas, les AFPA les rembourseront.

Ce qu’en dit le Code du Travail (au 12 février 2025)
Article L3142-42

Lorsqu’un salarié est désigné pour siéger dans une commission, un conseil ou un comité administratif ou paritaire appelé à traiter des problèmes d’emploi et de formation, l’employeur lui accorde le temps nécessaire pour participer aux réunions de ces instances.

La liste de ces instances est fixée par arrêté interministériel.

Lorsqu’un salarié est désigné pour participer à un jury d’examen ou de validation des acquis de l’expérience, l’employeur lui accorde une autorisation d’absence pour participer à ce jury.

Article L3142-43

La participation du salarié aux réunions et jurys mentionnés à l’article L. 3142-42 n’entraîne aucune réduction de la rémunération.

La durée des congéscorrespondants ne peut être imputée sur celle du congé payé annuel.

Article L3142-44

Un décret détermine les conditions dans lesquelles les dépenses afférentes au maintien du salaire et au remboursement des frais de déplacement sont supportées par les instances et jurys mentionnés à l’article L. 3142-42 ou par l’entreprise.

Article L3142-45

Le bénéfice du congé peut être refusé par l’employeur s’il estime que cette absence est susceptible d’avoir des conséquences préjudiciables à la bonne marche de l’entreprise.

Le refus de l’employeur intervient après avis du comité social et économique. Il est motivé.

En cas de différend, le refus de l’employeur peut être directement contesté par le salarié devant le conseil de prud’hommes, statuant selon la procédure accélérée au fond, dans des conditions fixées par décret en Conseil d’Etat.


Je mesure la chance et le privilège d’avoir trouvé ma voie tôt. J’aime encore tellement mon domaine que je veux contribuer à y faire entrer de nouvelles têtes, et j’espère qu’un jour, j’aurai l’occasion de travailler avec des personnes rencontrées aujourd’hui.

Mais je sais aussi que la reconversion professionnelle est un parcours semé d’embûches. Le chemin est encore long pour garantir à tou les mêmes chances de réussite. Les organisations syndicales, la médecine du travail, et les commissions santé, sécurité et conditions de travail ont encore beaucoup à faire pour améliorer les conditions de formation et de reconversion.

Peut-être faudrait-il envisager des dispositifs de financement dédiés, comme un « Compte Reconversion », à l’image du compte formation, pour soutenir les candidat dans leur parcours. Tout reste à inventer, mais chaque jury est une étape de plus vers une société où la reconversion professionnelle est une opportunité accessible à tou.

Votre site est un restaurant

Dans la plupart des organisations, avant même de créer un site web, les équipes sélectionnent les technologies à utiliser, souvent sans avoir défini le périmètre fonctionnel et l’expérience utilisateur souhaitée. Je ne m’attarderai pas ici sur leurs motivations, mais le fait est qu’elles présentent cela aux parties prenantes qui, souvent, ne savent pas de quoi il retourne et valident par manque de compétences.

Avant de vous plonger dans les dernières technos mises en avant par les grandes entreprises, en pensant avoir les mêmes besoins et capacités qu’elles, permettez-moi de prendre un moment pour vous expliquer comment un site web est construit, en utilisant une métaphore que vous comprendrez : les restaurants.


Comment servir un plat de restaurant ?

Si vous souhaitez un jour servir un plat, vous aurez besoin d’une liste précise d’ingrédients et de leurs attributs (qui peuvent dépendre de l’ingrédient). Une carotte peut être cuite à la vapeur, un œuf poché. Cette liste d’ingrédients cuisinés ajoute de la profondeur et de la saveur au plat.

Ça, c’est HTML.

Des ingrédients cuisinés ne suffisent pas à créer un plat ; la présentation est essentielle. Pour susciter l’intérêt des clients, vous devez mettre en valeur ces ingrédients d’une manière qui reflète l’essence de l’art culinaire du restaurant.

Ça, c’est CSS.

Toutefois, une belle présentation ne suffit pas à définir un plat de restaurant. Pour y parvenir, il faut un personnel de service attentif qui prend les commandes, les communique à la cuisine et sert ensuite les assiettes dans la salle à manger.

Ce processus représente votre navigateur qui interagit avec le web.

Voilà, vous avez les bases.

Maintenant créons un restaurant qui deviendra par la suite une franchise.


Créer le projet

Pour mener à bien ce projet, les propriétaires réunissent une équipe dédiée. Celle-ci comprend un designer qui imagine l’expérience client, un chef cuisinier chargé d’élaborer les processus de cuisine et des artisans qualifiés chargés de construire les meubles et les cloisons. Bien que les propriétaires n’aient pas les moyens d’embaucher un designer, un chef et des artisans à temps plein dans un premier temps, ils prévoient de le faire une fois la franchise établie afin d’optimiser les coûts.

Le lancement du projet implique rapidement que les parties prenantes se rencontrent, car certaines décisions prises en cuisine impactent l’organisation de la salle de restauration ainsi que les choix de design. Servir de la nourriture fusion dans un décor de cow-boy n’est peut-être pas le meilleur choix !

Le comité de pilotage s’appuie sur les retours des artisans et de la brigade ; cependant, il prend fréquemment des décisions en huis clos. Il est donc essentiel que les informations partagées avec lui soient de haute qualité et qu’il possède une expérience suffisante pour prendre des décisions éclairées.

De nombreux projets web débutent par la constitution d’un petit comité de pilotage composé de prestataires, chargé de définir la vision et la gouvernance du projet. Au cours de cette phase, des décisions sont prises qui peuvent ne pas tenir compte des équipes qui seront chargées de faire vivre ces initiatives au cours des mois, voire des années suivantes.


Répétitions et pré-ouverture

Une fois que tout est en place, les propriétaires organisent des services fictifs, également appelés répétitions générales, qui permettent au personnel de service de simuler des scénarios réels, les aidant ainsi à affiner leur fonctionnement et à identifier tout problème opérationnel avant le lancement officiel. C’est souvent la première occasion pour tout le personnel de travailler ensemble.

Dans les projets web, nous appelons cela l’environnement d’intégration.

Une fois les propriétaires satisfaits, ils invitent amis et famille pour des pré-ouvertures privées. Cela permet à l’équipe de tester le service et de recueillir des retours clients dans un environnement concret, en apportant les ajustements nécessaires.

C’est l’environnement de pré-production ou de staging.

Petit à petit, les propriétaires décident d’augmenter le nombre de personnes. C’est un test de la capacité à monter en charge du service. Combien de clients pouvons-nous accueillir en une soirée ? Et combien pouvons-nous servir en une semaine ? Et si nous atteignons notre limite, qu’est-ce qui lâchera en premier et quelle sera l’expérience client ?

Sur le web aussi, nous faisons des tests de charge !


L’offre la plus simple

Le premier bistrot est désormais officiellement ouvert ! L’expérience culinaire est simple mais très efficace. Le menu propose une sélection soigneusement choisie et très limitée de plats, garantissant que chaque commande est préparée rapidement, satisfait les clients et est joliment présentée. Les clients peuvent commander à la carte, ou même demander des plats personnalisés, mais la plupart ne le font pas. Le personnel de service peut se déplacer efficacement entre la cuisine et les tables, améliorant ainsi l’efficacité globale du service. Après quelques années de fonctionnement, les propriétaires décident d’investir pour multiplier le nombre de restaurants. La franchise est en place.

Les sites web très simples en HTML+CSS, avec une personnalisation côté serveur limitée, sont souvent les plus rapides. Ils ont un Time To First Bite (Temps avant la Première Bouchée) très court ! La montée en charge est souvent aussi simple que de multiplier les serveurs frontaux.


Fast Food

À un moment donné, les propriétaires estiment que le concept peut être optimisé en investissant dans un processus de production à la chaîne plus efficace. Les clients perdent ainsi la possibilité de personnaliser leurs plats et doivent choisir parmi des menus standardisés. La brigade n’a besoin de consulter une nouvelle recette qu’une seule fois pour en maîtriser instantanément la préparation. La rapidité du service est donc déterminée par la vitesse à laquelle le personnel de service peut livrer les assiettes, dans la mesure où l’espace le permet. Le nouveau goulet d’étranglement est le paiement, car il n’est pas possible de produire en masse les additions, qui dépendent de la commande de chaque table, et de procéder à leur encaissement.

Sur le web aussi, on peut obtenir des réponses instantanées si l’on sert le même contenu à chaque visite : c’est ce qu’on appelle la mise en cache. Cependant, quelle que soit la rapidité de votre site web, la vitesse sera toujours limitée par les étapes personnalisées, telles que les entonnoirs de paiement. Il est essentiel de garantir une excellente interface utilisateur pour éviter les frustrations.


Quality Audits

Pour obtenir une certification ISO et se conformer aux cadres réglementaires dans tous les lieux où la franchise opère, les propriétaires ont choisi de mener des audits complets sur l’ensemble de la chaîne. Cela inclut tout, de l’accès des clients à la salle de restauration, aux procédés de fabrication des denrées alimentaires, en passant par l’approvisionnement en ingrédients.

Les thèmes peuvent varier considérablement. Par exemple, les auditeurs peuvent signaler l’absence de mains courantes dans les toilettes pour les clients handicapés ou souligner que le type de carottes utilisé en cuisine n’est pas sourcé localement. Ils fournissent des listes de contrôle, tests et vérifications que les propriétaires peuvent effectuer avant, pendant et après chaque service pour éviter toute régression en termes de qualité.

L’assurance qualité (Quality Assurance, ou QA) dans le développement web garantit que les sites web fonctionnent correctement et répondent aux exigences grâce à des processus de test et de validation systématiques. L’audit implique la révision et l’évaluation des applications web pour leur conformité aux normes et aux meilleures pratiques, identifiant les domaines à améliorer. Certains outils automatisés permettent d’effectuer des tests répétitifs de manière efficace, améliorant ainsi la fiabilité et la rapidité. Cependant, certains problèmes, en particulier l’accessibilité numérique, nécessitent une évaluation manuelle approfondie pour garantir la conformité avec des directives telles que les Web Content Accessibility Guidelines (WCAG) ou en France, le Référentiel Général d’Amélioration de l’Accessibilité (RGAA).


Service en salle

Pour améliorer la qualité du service, les propriétaires ont décidé de mettre en place une équipe d’assistance à la clientèle appelée « Jolly Servants » (JS). Certains de ces JS sont spécialisés dans les boissons, tandis que d’autres se concentrent sur l’assaisonnement. Parfois, ils offrent des services personnalisés sans quitter la salle, en fournissant des recommandations ; cependant, il arrive qu’ils aient besoin de l’aide de la cuisine, et demandent alors de l’aide au personnel de service habituel. Certains sont maladroits et déstabilisent le service lorsqu’ils tombent.

Bien que l’expérience de l’utilisateur soit de plus en plus personnalisée, la salle peut devenir quelque peu bondée, ce qui ralentit le service. Par conséquent, certains clients peuvent se retrouver à attendre avant de pouvoir profiter d’une expérience satisfaisante. En outre, le personnel de service doit parfois déplacer des assiettes pour faire de la place à d’autres, ce qui peut être frustrant.

JavaScript (JS) améliore les capacités natives du navigateur en offrant une expérience utilisateur avancée qui peut dépendre (ou non) des données du serveur. Cependant, une quantité excessive de JS peut entraîner des tâches longues (périodes pendant lesquelles le navigateur ne répond plus), ce qui peut se traduire par une expérience plus lente ou moins satisfaisante. Le déplacement d’éléments visuels peut entraîner des changements de mise en page, ce qui réduit encore l’expérience globale de l’utilisateur.


Mesurer pour optimiser

Pour améliorer les conditions d’exploitation du restaurant, les propriétaires ont engagé deux maîtres d’hôtel contractuels. L’un d’eux se concentre sur l’évaluation de la cuisine et du bureau, en identifiant les goulets d’étranglement dans les zones de stockage et de préparation, ainsi que dans la comptabilité. L’autre maître d’hôtel observe le personnel de service, les interactions avec les clients à leur table et la caisse enregistreuse.

Tous deux prennent méticuleusement des notes, qui sont ensuite envoyées à leur entreprise, laquelle génère un rapport en temps réel détaillant les performances du restaurant, avec des données de diagnostic et des recommandations d’amélioration réalisables.

Leur présence peut ralentir les opérations, surtout dans une cuisine ou une salle à manger déjà encombrée.

Les propriétaires reconnaissent qu’il ne s’agit là que d’une partie de leur investissement. Ils ont également confié au comité de pilotage la responsabilité de mettre en œuvre les améliorations, car l’observabilité seule est inefficace sans un effort d’amélioration continue qui lui aussi, coûte de l’argent.

Pour améliorer les performances du site web, les parties prenantes s’appuient souvent sur de la télémétrie. Certains services se spécialisent dans la surveillance du back-end, comme les outils de suivi des performances des applications (Application Performance Monitoring, APM), tandis que d’autres se concentrent sur le front-end, notamment les outils analytiques (Analytics) et de surveillance des utilisateurs réels (Real User Monitoring, RUM). Ces outils alimentent l’amélioration continue en permettant l’observation de l’utilisation, mais la plupart des sites web doivent sélectionner judicieusement leurs outils, car l’intégration d’un trop grand nombre de services tiers peut ralentir l’expérience.


Assiettes musicales

Pour mieux comprendre les attentes des clients, les propriétaires ont mis en place une série de tests. Dans un premier temps, différents restaurants de la franchise ont proposé des menus distincts, tandis que l’équipe dirigeante a analysé l’impact de ces variations sur l’expérience des clients. Mais ils se sont vite rendu compte qu’il était difficile de tirer des conclusions à partir d’une population hétérogène ayant des habitudes culturelles différentes. Ils ont donc décidé de mener les tests dans un même restaurant, en demandant aux Jolly Servants de présenter des menus différents à des tables différentes.

La conduite de tests visant à faire évoluer le menu d’un restaurant présente des difficultés considérables. Déterminer quelles tables ont droit à des options de menu spécifiques demande beaucoup de temps aux JS, ce qui peut avoir un impact négatif sur l’expérience globale du client. Certains habitués peuvent être déconcertés par le fait que le menu change d’un jour à l’autre, ce qui donne un sentiment d’incohérence qui s’ajoute à la lenteur du service.

Les tests A/B, principalement orchestrés par du code JS, sont largement considérés comme la méthode la plus fiable pour évaluer comment les changements apportés à un site web affectent l’expérience d’utilisation. Toutefois, la réalisation de ces tests peut s’avérer délicate et entraîner une expérience sous-optimale pour les utilisateurs au cours de la période d’évaluation. Les professionnels du web conseillent généralement de faire preuve de prudence lors de la mise en œuvre des tests A/B, de définir clairement la portée et la durée des tests et de veiller à ce que les solutions soient désactivées lorsqu’elles ne sont plus utiles.


Partenariats et délégation de tâches

Certaines parties du menu sont confiées à des partenaires avec lesquels le propriétaire a établi des conventions. Par exemple, les coupes glacées seront préparées par un glacier local. En outre, certains Jolly Servants internes ont été remplacés par des sous-traitants ; en particulier, un caviste installé de l’autre côté de la rue se charge désormais de la sélection des vins et formule des recommandations.

En réorientant son personnel vers son activité principale, les propriétaires ont amélioré à la fois l’efficacité et la fiabilité du service. Toutefois, cette réorientation a eu pour effet de ralentir certaines expériences déléguées, voire de les rendre plus risquées, notamment lorsque le sommelier doit se frayer un chemin dans la circulation en traversant la rue aux heures de pointe.

Les propriétaires doivent donc désormais surveiller leurs partenaires. En tant qu’éléments clés de ce partenariat, leur rôle est crucial pour la réussite de l’entreprise.

L’utilisation de JavaScript tiers peut s’avérer très efficace pour fournir des services qui seraient autrement hors de portée ou dont on sait qu’ils seront mieux exécutés par des professionnels. Toutefois, leur utilisation nécessite un contrôle rigoureux pour garantir que les services fonctionnent correctement et ne rencontrent pas de défaillances susceptibles de dégrader l’expérience d’utilisation. Les services de télémétrie et d’observabilité peuvent aider à détecter les erreurs et à évaluer leur impact.


À la table du Chef

Pour se démarquer de la concurrence, les propriétaires décident que certains de leurs franchisés offriront une expérience unique et caractéristique : la table du chef. Directement à la table, un chef spécialisé prépare un menu personnalisé pour les clients, en fonction de leurs préférences, de leurs restrictions alimentaires et de la disponibilité des ingrédients apportés par le personnel de service et les Jolly Servants.

Les tables de chef occupent un espace important dans la salle, ce qui oblige le personnel de service à se déplacer fréquemment pour rassembler ou réarranger les ingrédients. Cela peut ralentir le début du repas. C’est pourquoi, généralement, cette expérience immersive commence par la dégustation d’un délicieux cocktail pendant que les convives attendent.

Une fois que tout est en place, la table fonctionne de manière autonome, ce qui réduit la demande en cuisine, qui peut même devenir nulle. Le service fourni est à la fois personnalisé et immédiat. Toutefois, cette expérience exclusive n’est généralement accessible qu’aux clients les plus aisés (ou à ceux qui ont le plus gros carnet d’adresses !).

Afin de rehausser leur statut, les restaurants voisins ont commencé à proposer aussi des tables de chef, y compris le fast food situé à deux pâtés de maisons. Les longs temps d’attente et l’expérience décevante font que les clients ne reviennent pas pour une deuxième visite !

Dans l’industrie du web, les applications à page unique (Single-Page Apps, SPA) sont particulièrement bien adaptées à la création de parcours immersifs et attrayants pour les utilisateurs. Elles prennent souvent plus de temps à charger, et encore plus sur les appareils d’entrée de gamme, de sorte que les parties prenantes doivent réfléchir sérieusement aux astuces visuelles à utiliser pour embarquer le public et lui faire supporter l’attente.

De nombreux petits sites web adoptent des SPA, s’inspirant de la tendance établie par les grands acteurs du web, même lorsque leurs besoins sont simples et standardisés. Il en résulte souvent une mauvaise affectation des ressources, car les équipes utilisent des librairies et techniques qui ne correspondent pas à leurs besoins, et n’ont pas les moyens d’investir correctement dans leur mise en œuvre.


Des sites web divers pour de belles expériences

En conclusion de cette métaphore imparfaite et incomplète, je pense qu’il est essentiel de comprendre que, tout comme il existe différents types de restaurants, il devrait également y avoir une large variété de manières de faire des sites web. Du restaurant indépendant informel à la table de chef exclusive, chaque site peut offrir une expérience unique, avec son propre lot de défis.

Souvent, les solutions les plus simples s’avèrent les plus efficaces. Toutefois, un manque de personnalisation peut entraîner une diminution des marges bénéficiaires et entraver le développement d’une identité de marque solide. À l’inverse, les solutions plus complexes exigent une prise en compte méticuleuse de l’expérience utilisateur, ce qui nécessite des investissements importants dans l’analyse de la frustration et de l’amélioration continue. La dégradation temporaire d’une expérience peut être une décision stratégique visant à l’améliorer à long terme. Il est essentiel d’investir dans les processus et, en particulier, la mise en œuvre de l’assurance qualité joue un rôle essentiel dans la réduction des risques les plus importants.


Merci à Meryem, qui a supporté mes expériences de métaphores filées pendant plus d’un an, et à Morgan, Luke et Natacha pour leur relecture !

Incremental Font Transfer
une opportunité pour des web fonts en Asie

Pour un français comme moi, les langues asiatiques telles que le chinois, le japonais et le coréen, ainsi que d’autres ayant des écritures complexes, contiennent souvent beaucoup de caractères. Bien que cette diversité soit culturellement fascinante, elle pose de vrais défis lors de la sélection d’une police web. Les fichiers peuvent avoir un poids potentiellement très important, ce qui entraîne des temps de chargement plus lents, en particulier sur les appareils mobiles ou dans les régions avec une connectivité limitée à Internet.

Pour vous donner un ordre de grandeur de la différence de poids, voici le sous-ensemble latin-étendu :

En conclusion : le fichier de police médian avec un sous-ensemble latin-étendu de (395) caractères devrait pesé un peu moins de 20 Ko. Si vous regardez vos requêtes réseau et que votre police est beaucoup plus lourde, eh bien, il y a du travail à faire. « How many bytes is « normal » for a web font: a study using Google fonts », Stoyan Stefanov (traduction en français)

Et voici pour le chinois :

Dans un type de police chinois, la plus petite police standard contient 6 763 caractères. Un type de police japonais appelé Hanazono a 87 791 caractères. La taille typique d’un fichier de police chinois est généralement d’au moins 5 Mo, parfois plus de 20 Mo. « Chinese Typographic Design », Hynuza (traduction en français)

Vous comprendrez pourquoi il est courant de s’abstenir d’utiliser des polices web pour les pages web accessibles en ligne dans cette région.

De l’optimisation est toujours possible. Une méthode efficace est le subsetting, qui consiste à créer un sous-ensemble d’une police - un fichier qui inclut une sélection personnalisée (et généralement limitée) de glyphes. Mais même avec un chinois de base niveau lycée, nous aurions besoin d’un minimum de 3 000 caractères.

Je savais que le streaming de polices n’était pas possible, mais une publication récente d’Anthony sur le Web Performance Slack a attiré mon attention. Il faisait la promotion d’une nouvelle spécification (encore en brouillon) spécifiquement conçue à cet effet.

Sans cette technologie, un navigateur doit télécharger chaque dernier byte d’une police avant de pouvoir rendre des caractères utilisant cette police. « Incremental Font Transfer », W3C Working Draft (traduction en français)

L’idée est de créer une police qui peut être segmentée en un chargement initial, contenant uniquement le sous-ensemble de ce qui est critique, puis de lui adjoindre des additions qui complètent la police en cours de route. Une sorte de lazy-loading, mais pour les polices d’écriture.

Cette première itération, si elle est mise en œuvre dans les navigateurs, a le potentiel de débloquer d’importantes opportunités pour les marchés asiatiques. Je suis enthousiaste, même si je n’ai pas hâte de devoir maîtriser des descripteurs de police tels que size-adjust ou ascent-override pour gérer efficacement l’expérience utilisateur lors du chargement successifs de correctifs contenant des milliers de glyphes !

L’API Speculative Rules
une nouvelle itération dans l’histoire du préchargement

En Web Performance, il arrive un moment où vous avez épuisé toutes les options pour accélérer la vitesse de la page web que vous optimisez. Peut-être parce que vous avez appliqué toutes les améliorations que vous aviez prévues, ou peut-être que les contraintes de votre stack techno ne permettent pas d’aller plus loin. Lorsque vous atteignez ce point, votre attention se déplace généralement vers l’accélération du temps de chargement de la prochaine page web.

J’ai vu beaucoup d’expériences en ce sens au fil des ans, et je surveille de près la nouvelle itération : l’API Speculative Rules.

Petit historique personnel

Au début des années 2000s, les abonnements d’accès à Internet étaient limités dans le temps. Mon moi adolescent utilisait FasterFox, une extension Firefox qui préchargeait tous les liens possibles sur une page web pendant que je la lisais, me permettant de poursuivre ma navigation hors ligne. C’était particulièrement utile pour les sites web riches en contenu, comme ceux avec des paroles de chansons et des astuces de jeux vidéo !

À un moment, Firefox a introduit le support de la balise <link rel="next">, qui permettait au navigateur de précharger une page vers laquelle il prévoyait que l’utilisateur naviguerait ensuite. J’ai trouvé cette fonctionnalité particulièrement pratique pour créer des articles étalés sur plusieurs pages sur mes premiers blogs.

Pendant une période, je me suis concentré sur .NET et je ne me suis pas beaucoup intéressé au préchargement (j’ai surtout utilisé Wordpress pour la création de contenu, et j’ai appris jQuery, puis JavaScript, en cours de route). Je m’y suis remis sérieusement vers 2012.

Quelques années plus tard, Alexandre Dieulot a proposé un concept intéressant : il a remarqué qu’il y a généralement un délai de 200 à 300 millisecondes entre le moment où une personne survole un lien et celui où elle clique dessus. Il s’est demandé si ce délai pouvait être utilisé pour précharger la page, afin qu’elle soit prête dès que l’utilisateur clique. Cette idée, bien qu’elle nécessite de définir ce qu’était un préchargement et d’exclure les liens de téléchargement, était relativement simple et a conduit à la création de la bibliothèque InstantClick.io et son utilisation d’un requête XHR similaire à un prefetch.

D’autres bibliothèques ont suivi, offrant des possibilités supplémentaires. La plus remarquable d’entre elles était sûrement turbolinks. Ces bibliothèques visaient à offrir à l’utilisateur la même expérience avec les Multiple Page Apps (MPA) qu’avec les Single Page Apps (SPA). Elles s’appuyaient sur des Resource Hints et sur la toute nouvelle API HTML5 History pour conserver l’usage des boutons Retour et Rechargement. Il était possible d’utiliser à la fois une solution de type SPA et InstantClick, comme je l’ai fait sur ce blog pendant un certain temps. Cependant, j’ai finalement décidé que les avantages étaient trop faibles compte tenu du temps de réponse natif déjà rapide du site.

Compte tenu de l’efficacité de ces solutions et de leur faible besoin de maintenance au fil du temps (InstantClick n’a pratiquement pas changé en 10 ans), il semblait logique de développer une nouvelle API de navigateur qui améliorerait nativement les performances pour les navigations futures.

Découvrons l’API Speculative Rules

L’API Speculative Rules introduit une nouvelle méthode déclarative pour indiquer au navigateur quel contenu doit être préchargé et/ou pré-rendu à la demande du concepteur ou de la conceptrice du site.

Les règles de spéculation contiennent un paramètre appelé eagerness (qu’on peut traduire par « degré d’impatience ») qui détermine quand le navigateur doit télécharger le contenu. Doit-il le faire immédiatement (comme le faisait FasterFox), ou doit-il attendre un signal supplémentaire, tel qu’un survol (comme InstantClick), ou même le déplacement du pointeur de la souris vers le lien ?

Je trouve que les règles établies par cette API sont élégamment définies et faciles à comprendre. Prenons l’exemple suivant, directement à la fin du <body> :

<script type="speculationrules">
  {
    "prefetch": [
      { "where":
        { "href_matches": "/*" },
        "eagerness": "moderate"
      }
    ]
  }
</script>

Ou sous la forme d’un snippet à intégrer dans votre tag manager (pour un A/B test, par exemple) :

(function () {
  if (HTMLScriptElement.supports && HTMLScriptElement.supports('speculationrules')) {
    const script = document.createElement("script");
    script.type = "speculationrules"
    script.textContent = JSON.stringify({
      prefetch: [
        {
          where: { 'href_matches': '/*' },
          eagerness: 'moderate'
        }
      ]
    });
    document.body.appendChild(script);
  }
})()

NOTE
L’ajout d’un snippet HTML personnalisé dans Google Tag Manager ne déclenchera pas les règles de spéculation. Préférez l’option du snippet JavaScript.

Il indique au navigateur que pour toutes les URLs du domaine courant /*, il peut faire du prefetch s’il pense que l’utilisateur va avoir besoin du contenu. Avec une impatience « modérée » (moderate), cela se produira principalement lorsque l’utilisateur survolera le lien.

Est-ce vraiment si simple ? Oui.

Vous avez également la possibilité d’utiliser prerender au lieu de prefetch. Cependant, permettez-moi d’insister sur le fait que si la règle `prerender$ est appliquée, elle récupère et traite la ressource à l’avance, ce qui inclut la récupération des sous-ressources également, qu’elles proviennent d’une première ou d’une troisième partie.

Devons-nous attendre un peu ?

Déjà, précisions que même si la fonctionnalité est déployée dans Chrome depuis quelques mois, elle reste récente. Certaines alchimies, comme la spéculation prefetch couplée à un Service Worker, ne fonctionnent pas encore. Rien de dramatique, mais précaution est mère de sûreté.

Le préchargement et le rendu spéculatif, bien que bénéfiques pour l’expérience de certains utilisateurs, comportent le risque de gaspiller des ressourses : de la bande passante et des ressources du serveur si les données extraites ne sont pas utilisées parce que l’utilisateur ne navigue pas jusqu’à la page ainsi optimisée.

Si votre objectif est d’améliorer la sobriété de votre site web ou si vous êtes tenu d’en rendre compte (par exemple, en raison de la directive européenne sur les rapports de développement durable des entreprises), il n’est peut-être pas judicieux de gonfler artificiellement le nombre de pages que vos serveurs calculent et délivrent et que vos utilisateurs téléchargent.1

Du côté du serveur, l’utilisation de règles de spéculation peut potentiellement présenter un risque pour votre site web. Si une règle est trop gourmande, elle peut déclencher un grand nombre de chargements de pages et de ressources pour chaque utilisateur. Cette charge accrue peut mettre à rude épreuve la capacité de votre serveur à fournir rapidement du contenu à tous les utilisateurs, en particulier si vous n’avez pas mis en place de fonctionnalités de mise en cache au préalable. Dans les cas extrêmes, cela peut vous conduire à vous infliger à vous-même un déni de service distribué (DDoS).

L’utilisation de l’API Speculative Rules ne doit se faire uniquement au regard des impératifs d’amélioration de l’UX, mais aussi en prenant en compte d’autres facteurs. Nous pouvons aussi optimiser les règles : en tant qu’administrateurs de sites web, nous pouvons utiliser l’analyse comportementale pour mieux connaître les pages les plus populaires et les parcours de navigation des utilisateur. Ces informations peuvent nous aider à déterminer si l’utilisation de l’API Speculative Rules améliorerait ou nuirait à l’UX.

Enfin, et ce n’est pas neutre, l’utilisation de l’API Speculative Rules peut s’apparenter à une forme de suivi des survols des utilisateurs. En effet, si on imagine qu’un survol d’un lien ou qu’un glissement du pointeur de la souris vers un lien déclenche un prefetch ou un prerender alors il suffirait d’aller consulter les logs du serveur pour savoir ce qu’il a intéressé un utilisateur, qu’il visite la page… ou non2.

Alors, on y va ?

L’API Speculative Rules est le dernier développement d’une histoire qui dure depuis longtemps. Les problèmes que j’ai évoqués étaient déjà inhérents aux solutions précédentes. l’API Speculative Rules ne fait qu’intégrer ce comportement directement dans le navigateur, ce qui présente certains avantages par rapport à JavaScript.

Tout d’abord, le navigateur est mieux équipé qu’un développeur pour déterminer la position des éléments et comprendre les mouvements de la souris de l’utilisateur. C’est pourquoi il constitue actuellement l’option la plus efficace pour ce type d’optimisation. Deuxièmement, le navigateur est conscient de l’état de la connexion et du niveau de la batterie, et peut choisir de ne pas charger les ressources de manière spéculative si les conditions ne sont pas favorables. Si le navigateur détecte que les réponses du serveur à cette origine sont trop lentes, il peut également désactiver ce comportement.

Tout ceci étant dit, la demande du public pour un web plus durable et respectueux de la vie privée n’a jamais été aussi forte. Soyez donc peu gourmand dans vos règles et n’abusez pas des droits que vous avez sur les logs produits. Le chargement de ressources le plus sobre est celui qui n’a jamais eu lieu.

  1. A l’inverse, vous pouvez avoir un intérêt particulier à gonfler ces chiffres. En France, par exemple, les aides publiques à la Presse sont calculées en fonction du nombre de pages vues. Il est évident que certaines entités exploiteront ces règles pour « générer des pages vues », tout comme elles le faisaient auparavant avec des rafraîchissements excessifs. ↩

  2. Si un tel traitement des données est fait, il devrait –en tout cas dans l’Union Européenne– être encadré par un consentement. ↩

Entendre le réseau

Voici bon outil de sensibilisation qui passe par l’audio : Netbeep est une extension Chrome qui joue des sons à chaque requête sur le réseau en fonction du type de contenu et du domaine appelé. Le pitch du son est plus élevée pour les fichiers plus volumineux.

Une bonne manière d’activer la synesthésie. En s’appuyant sur le son plutôt que sur le regard pour porter une information autrement invisible à l’écran l’extension de permet de comprendre comment se charge une page.

Sur une page isolée, difficile d’en tirer quelque chose. Mais quand on commence à l’utiliser sur plusieurs sites, on entend très vite des différences.

Si quelqu’un a un équivalent Firefox, je serais ravi de l’ajouter à ce post.

L’UX n’est pas une checklist

Je discutais hier avec un client qui souhaite trouver un équivalent à Largest Contentful Paint sur Safari.

Du point de vue SEO, même si vous avez un tout petit peu de trafic sur Chrome, c’est ce trafic qui détermine la façon dont Google perçoit la performance web de la page. Mais si vous souhaitez mesurer et améliorer l’expérience de vos utilisateurs, alors je dirais : pourquoi se limiter au LCP ?

Le LCP a été créé en tant que mesure de substitution pour répondre à une question beaucoup plus intéressante : « Quand les utilisateurs voient-ils suffisamment d’éléments pour commencer à interagir avec la page ? Et ce « suffisamment » dépend de la nature et du contenu de la page, ainsi que des intentions de l’utilisateur.

Les LCP est rarement la meilleure mesure pour répondre à cette question. C’est juste la plus générique, calculable pour la plupart des pages, par Chromium et les navigateurs basés sur Chromium, donc parfaite pour une évaluation générique et très large dans l’optique du référencement de milliards de pages web.

[…]

Si j’essaie d’évaluer une page web en particulier, que je connais très bien, je ne mesurerais pas le LCP mais j’utiliserais plutôt des indicateurs personnalisés, qui répondront mieux aux défis de la page et qui m’aideront à comprendre son fonctionnement :

  • Le moment où l’autocomplétion de recherche est fonctionnelle et affichée (dans cet ordre, espérons-le)
  • Sur une liste de produits, le moment où les utilisateurs peuvent voir la première ligne de produits et commencer à interagir avec les filtres.
  • Le moment où le spinner de chargement apparaît et le moment où il disparaît pour afficher le contenu final (utile pour les « splash » d’accueil et les interstitiels du tunnel de conversion).
  • Dans une page composée de modules récupérant leur contenu à partir d’une API, les temps d’affichage spécifiques de chaque composant
  • etc.

C’est l’une des raisons pour lesquelles je pense que l’acquisition de Dareboost par Contentsquare a donné un nouveau souffle à ma carrière dans le domaine de la qualité Web. Plus encore qu’auparavant, je me suis impliqué dans les questions d’utilisabilité, dont la performance web n’est qu’une partie. Cela m’aide à garder à l’esprit que les indicateurs que nous mesurons en web performance ne sont souvent que les projections les plus génériques et les plus imparfaites de l’expérience technique d’une page web, et qu’ils ne sont pas nécessairement alignés sur les objectifs des clients et des organisations.

Hier soir, je suis tombé sur un article de Tim qui résume très élégamment la situation (traduction maison) :

Les organisations ont parfois tendance à considérer les performances comme une sorte de checklist, d’autant plus que les Core Web Vitals attirent plus que jamais l’attention sur les performances. On essaie de cocher les cases de ces indicateurs pour qu’ils passent au vert, puis on s’arrête là.

[…]

Mais tout cela est sans importance si ces mesures ne donnent pas une image exhaustive de la manière dont les utilisateurs interagissent avec nos sites.

La performance, comme l’accessibilité, n’est pas une question de conformité.

[…]

Il s’agit d’offrir une meilleure expérience aux personnes qui utilisent nos sites et nos applications afin qu’elles puissent atteindre leurs objectifs de manière efficace. Pour ce faire, nous devons être très attentifs à la nature de ces objectifs et à la manière dont ils sont atteints, et nous assurer que la manière dont nous mesurons les performances correspond à ces objectifs. « Performance Is Not a Checklist », Tim Kadlec

En tant que personne impliquée depuis des années dans Opquast, la checklist de référence de la Qualité Web, la critique du concept de checklist me touche. Mais elle est très juste. Les checklist ne sont que le début d’une approche de la qualité web, une ligne directrice. C’est un moyen de faire les choses correctement dès la première itération et d’ainsi réduire immédiatement l’exposition au risque de non-qualité. Mais ce n’est pas une réponse parfaite à l’UX, ça ne l’a jamais été et ça ne le sera jamais.

Un nouveau besoin sur le Produit

Quand je remonte un besoin pouvant donner lieu à une amélioration du produit :

Entre ce que je pense,
Ce que je veux dire,
Ce que je crois dire,
Ce que je dis,
Ce que le département Produit a envie d’entendre,
Ce qu’il entend,
Ce qu’il comprend,
Comment il mène l’étape de découverte du besoin,
Ce que d’autres utilisateurs et utilisatrices veulent entendre,
Ce qu’ils entendent,
Ce qu’ils comprennent,
Ce qu’ils expriment,
Ce que les designers veulent entendre,
Ce qu’ils entendent,
Ce qu’ils comprennent,
Ce qu’ils expérimentent avec ces personnes,
L’UX qui en ressort,
La manière dont elle est communiqué à l’équipe technique,
Ce que l’équipe technique a envie d’entendre,
Ce qu’elle entend,
Ce qu’elle est en mesure d’implémenter en respectant les contraintes,
Les délais qu’elle communique,
La manière dont ils sont reçus par les équipes opérationnelles,
Ce que les équipes opérationalles voulaient entendre,
Ce qu’elles comprennent,
Ce qu’il a fallu expliquer aux commerciaux,
Ce que l’équipe commerciale a envie d’entendre,
Ce qu’elle comprennent,
La manière dont elle projettent de le vendre,
Ce que le ou la cliente a envie d’entendre,
Ce qu’elle entend,
Ce qu’elle comprend,
Ce qu’elle achète,
Et les usages auxquels elle sera formé par l’équipe Customer Success…

… il y a quand même une grand chance qu’on ait des difficultés à communiquer.

Mais essayons quand même !

Un métier, pas qu’une passion

Développeurs et développeuses juniors : vos formations, courtes ou longues, ne vous rendent pas autonomes et prêt à accueillir n’importe quel défi. Et ça tombe bien, ce n’est pas le rôle de la formation initiale que de faire sortir des promotions entières de personnes immédiatement compétentes sur un projet exigeant.

Vous êtes peut-être passionné de code, mais cela ne suffit à en faire un métier. Si vous vous arrêtez là, c’est un hobby.

Pour que ça devienne un métier, il faut que cela s’inscrive dans un cadre :

  • un ensemble de compétences techniques ;
  • de la formation pour en acquérir de nouvelles ;
  • un cadre métier avec un contexte (légal, structurel, conjoncturel, géographique, etc.) ;
  • des engagements de cadre / coûts / délai à respecter ou, en tout cas, à définir ;
  • une organisation régie par une gouvernance à adopter (définissant qui décide de quoi, en informe qui, comment, qui est responsable en cas d’échec…) ;
  • souvent, un jargon mélangeant des composantes locales et plus consensuelles ;
  • des pratiques organisationnelles, parfois historiques, ayant un rôle social dans l’organisation ;
  • un portefeuille de projets orientés par une vision stratégique et des tactiques adaptées à chaque situation et inscrites dans des plans sur la durée (parfois pluriannuels).

Mais ce n’est pas tout.

À votre arrivée, vous ne serez pas seul. Vous évoluerez dans des équipes composées de professionnel déjà organisé qui gèrent des conflits et des équilibres de pouvoir au quotidien, avec des intérêts parfois divergents et de la gestion de conflits. Et… c’est normal. Parce que c’est comme ça dans toutes les organisations humaines.

L’école ne forme souvent qu’aux compétences techniques (et encore, souvent on en sort débutant avancé), en s’assurant de donner un bagage intellectuel théorique pour le reste, mais sans expérience. Et c’est déjà beaucoup.

Donc les compétences nécessaires pour naviguer avec aisance dans le reste s’acquièrent souvent avec le temps et la variété des expériences rencontrées. Elles s’acquièrent donc… lentement. Même deux ans d’alternance à mi-temps ne changent pas grand chose. Il s’agit souvent de deux ans pendant lesquels le ou la junior a travaillé temps partiel avec un jeu de responsabilité plus limité qu’un autre salarié. Ou alors l’étudiant a travaillé dans une petite start-up, a eu beaucoup de responsabilité mais aucun regard sur ce qu’il ou elle faisait. C’est la recette parfait pour un burn-out avant même son premier CDI…

Moralité : vous allez être perdu. Et c’est prévisible. Une organisation qui n’est pas prête à cela ne vous mérite pas. Mais vous dire ça, ça ne vous avance pas trop, hein ? Alors voici un vrai conseil : entourez-vous. Trouvez des mentor, dans ou à l’extérieur de l’entreprise, sur des sujets techniques ou non : si vous voulez vous épanouir, vous allez avoir besoin d’une cellule pour vous soutenir et vous faire grandir dans votre vie professionnelle.

Employeurs : si vous souhaitez travailler avec des devs près à l’emploi, qui ont déjà un savoir-faire, du savoir-être et savent le faire savoir, n’embauchez pas de juniors. Et quand vous écrivez sur LinkedIn qu’un ou une junior devrait absolument faire ceci ou cela, pensez aux juniors qui vous lisent, et qui dépriment parce qu’ils ont déjà l’impression que le marché les méprise. Prenez-en quelques-un en mentorat, vous comprendrez la violence de votre propos.

Bien. Ceci étant dit, pourquoi les employeurs et employeuses cherchent-ils souvent ce type de profils « prêt-à-l’emploi », quitte à leur demander des compétences parfois très spécifiques (que même les seniors n’ont pas) ?

Parce que notre domaine a un problème structurel avec l’idée de supporter le coût de la formation continue, qui est pourtant énorme (nos besoins techniques évoluant fortement et très régulièrement). Dans le tissu légal (droit à la formation, OPCO), rien n’est adapté, du financement de la formation à l’offre proposée par les canaux d’État. Les catalogues ne contiennent que des formations désuètes et les quelques formations pérennes y sont supprimées.

On se retrouve donc à devoir former en interne, ce qui est long, et cher. Comme le marché est très tendu chez les développeurs et développeuses expérimenté, ce sont des juniors qui sont finalement recherchés, dans l’espoir que leurs écoles leurs aient donné les quelques compétences techniques très spécifique recherchées par l’entreprise. Comme ces profils n’existent pas, sont finalement embauché des juniors qui possèdent 30 à 50 % du périmètre de l’offre publiée.

Juniors : maintenant que vous savez ça, vous savez que si un poste vous plait, vous pouvez postuler. Peu importe que vous ayez toutes les compétences. Passez des entretiens, beaucoup. Soyez prêt à être rejeté : ça arrivera, et ça ne voudra rien dire sur vous. À la fin, vous aurez engendré de l’expérience, c’est tout ce qui compte.

Cela créé énormément de problèmes :

  1. un sentiment d’imposture chez les salarié qui se traduit pas un manque de confiance dans la structure employeuse (et l’absence d’envie d’y faire carrière) ;
  2. des inégalités de genre, parce que par construction sociale, les hommes sont plus enclins à postuler à des postes pour lesquels ils n’ont pas toutes les compétences, là où les femmes vont plus facilement se remettre en question et douter d’elles-mêmes ;
  3. des juniors formé dans des entreprises qui ne voulaient pas d’elleux, qui finissent par partir dès que leur séniorité leur permet, ce qui ne fait que confirmer au marché qu’intégrer et former un junior n’est pas rentable ;
  4. et qui va remplacer ce ou cette développeuse senior, à votre avis ? La boucle est bouclée.

Les solutions pour s’en sortir : assumer des fiches de postes adaptées. Proposer par exemple des postes alternatifs permettant d’entrer dans le dev et d’y gagner de l’expertise sans en faire à temps plein (exemple avec cette fiche pour un Junior Data Consultant, ce qui n’est pas très éloigné de ce par quoi j’ai commencé chez Microsoft).

Mais également, imaginer et proposer des Graduate Programs, qui sont des formations proposées par les entreprises (et financées en dehors de budgets de financement classiques) qui permettent aux recrues d’arriver au niveau de compétence désiré par l’entreprise.

Oui, pour une entreprise, ça coûte cher. Mais combien ça coûte, aujourd’hui, de recruter une personne dont le niveau de productivité n’est pas celui attendu et de devoir, à l’arrache, produire les éléments nécessaire à le ou la voir grandir tout en regardant cette personne partir à la fin ?

Il n’y a pas de secret, dans le recrutement comme ailleurs : si vous voulez un retour sur investissement, commencez par investir.

Pourquoi mon script asynchrone bloque-t-il le rendu de ma page ?

Une très bonne manière de mesurer l’impact d’une ressource tierce, comme un script, est de mesurer la performance de la page avec et sans ce script. Nombreux sont mes clients qui découvrent alors que leurs scripts, qu’ils ont pourtant chargé avec les attributs async et defer, sont bloquants pour le rendu.

Et c’est normal. D’après la spécification HTML (source), un script async defer est, en fait, un script async partout où async est supporté, c’est-à-dire partout. Un script async est téléchargé avec une priorité basse, voire la plus basse. En revanche, une fois qu’il est disponible, il est exécuté immédiatement, interrompant les tâches en cours (y compris les tâches de rendu).

Si vous cherchez d’autres manières de télécharger des scripts, en voici au moins sept.

Et pour tout comprendre des attributs permettant de différer ou rendre asynchrone un script, c’est par ici.

Les Core Web Vitals partout

Comme prévu, de plus en plus de structures basent leurs efforts de Web Performance sur les Signaux Web Essentiels, ou Core Web Vitals. En France, par exemple, la méthodologie du classement JDN / Fasterize évolue pour adopter les CWV à la place d’analyses et d’indicateurs synthétiques.

Ce changement de paradigme va être un séisme pour beaucoup d’acteurs, mais je suis content de voir que mes client ont tendance à bien tirer leur épingle du jeu.

Pour les autres, prenez le recul nécessaire. Un mauvais classement n’implique pas nécessairement une mauvaise expérience pour vos utilisateur. Je sais que ce n’est pas évident à comprendre, donc voici quelques éléments d’explications.

D’une part, les CWV ne sont pas l’alpha et l’omega de l’UX.

Prenez le First Input Delay (FID), par exemple. D’après les données HTTP Archive sur plusieurs millions de pages d’accueil, il est globalement bon partout. Bien sûr, si vous proposez une web application qui repose sur beaucoup sur JavaScript, alors il est possible qu’il le soit moins. Mais pour la plupart des sites de ce classement, ce n’est pas le cas.

Je ne m’attarderai pas sur le Cumulative Layout Shift (CLS), car j’ai déjà dédié un article à cet indicateur et d’autres, comme Myriam, en parlent aussi très bien. Le CLS est biaisé par tellement de choses que Google imagine déjà son remplaçant.

Enfin, le Largest Contentful Paint (LCP) s’intéresse au contenu le plus important visuellement, sauf que ce contenu peut parfaitement être décoratif. On se retrouve donc avec un indicateur qui dévalorise des expériences d’utilisation qui ne sont pas dégradées.

D’autre part, le Chrome UX Report, d’où sont tirées les valeurs remontées la Search Console ou le classement JDN, ne délivre qu’une vision partielle des usages du Web.

Sa base de collecte est limitée aux utilisateurs et utilisatrices authentifiées de Chrome, sans passphrase, qui ont optée pour la synchronisation d’historique et l’envoi de rapports d’usages statistiques. Nous n’avons à ce jour pas d’information sur les biais de sélection que cela représente, mais on peut déjà souligner qu’aucun usage sur un autre navigateur n’est pris en compte (ce qui exclut d’emblée toustes les utilisateur d’iPhone, par exemple).

On se retrouve donc régulièrement avec des origines (domaines) absentes de la base de données Chrome UX Report parce qu’elles n’emmagasinent pas assez de visites. C’est le cas de plusieurs de mes client qui ont disparu du classement JDN parce que leur audience utilise plutôt des produits Apple.

Sachez donc garder du recul par rapport à ce référentiel qui n’est qu’une projection imparfaite et partielle de la performance. Elle n’est pas mauvaise en soi, toutes les projections sont imparfaites. Il faut juste le garder en tête.

Si vous souhaitez vraiment améliorer votre vision de la performance réelle, vous aurez besoin d’investir dans une solution de Real User Monitoring ou, à minima, dans un mécanisme de témoignages issus de vos utilisateurs et utilisatrices.

Sachez prendre du recul sur les impacts, également. J’aimerais pouvoir dire autre chose et « vendre » de la performance web à tours de bras, mais en réalité, je suis convaincu que l’impact de la Page Experience dans la mise à jour du ranking en mai sera réduit. Cela ne veut pas dire que la mise-à-jour de mai ne changera rien, mais peut-être qu’elle correspond tout simplement à un réajustement nécessaire, finalement assez éloigné de la web performance.

Google fait d’ailleurs évoluer sa communication avec le temps, puisqu’on est passé d’une réthorique de la prise en compte, interprété librement et sans contradiction par le monde du SEO technique comme un risque de pénalité, à une réthorique du boost de classement, mais uniquement quand les trois indicateurs sont bons, et uniquement dans le classement mobile…

En réalité, c’est une prophétie auto-réalisatrice qui se joue dans le monde du SEO technique. Les équipes qui sont en train de faire des optimisations interpréteront une absence de pénalité ou un meilleur classement comme étant un gain lié à leur travail alors qu’en réalité, ces équipes travaillent tout simplement à l’amélioration de l’expérience d’utilisation, ce qui va mécaniquement entrainer de meilleurs conversions.

Réciproquement, celles qui ne verront pas de gain remetteront en cause leur travail, principalement sur les Landing Pages, alors qu’il est peut-être très bon et que le problème se situe plus loin, dans le tunnel, ce qui est très difficile à savoir sans une approche plus précise de la donnée.

Parce qu’il est peut-être utile de le rappeler mais la performance web, ce n’est que de l’UX. C’est travailler techniquement à assurer une navigation de qualité, qui permet aux utilisateurs et utilisatrices d’atteindre leurs objectifs sur le site.

Si vous commencez à faire de la web performance parce que qu’un tiers vous « menace » (ici, Google), vous risquez de vous y mettre vite, et mal. Profitez plutôt du momentum actuel pour investir dans une équipe qualité transverse (pas que webperf, donc), qui se chargera de porter le sujet au long cours, sur toutes les fonctionnalités et de manière pérenne.

Les formations "courtes"

Je vois régulièrement des critiques à l’emporte-pièce visant les personnes qui suivent des formations courtes en informatique1, et cela m’énerve. Je suis Ingénieur ESIEE Paris, filière informatique, promotion 2007. Si je mets bout-à-bout l’ensemble du temps passé à coder durant ma formation, j’arrive à quelques mois, tout-au-plus.

La formation d’ingénieur m’a appris énormément de choses et j’ai eu souvent conscience de la force que cette diversité procure sur le marché du travail. Mais jamais je ne me permettrais de prendre de haut les personnes en formation initiale ou, encore plus souvent, en reconversion, qui elles aussi savent plein d’autres choses que le code et ont fait une formation de 3, 6 ou 9 mois.

Bien sûr, ces formations sont incomplètes. Mais n’étais-je pas moi-même sacrément incompétent à mes débuts ? Bien sûr que si. Et puis j’ai gagné du savoir-faire, du savoir être, une capacité à communiquer ancrée dans mon expérience et mes compétences. Et c’est normal.

La qualité de ma formation initiale m’a permis de m’en sortir rapidement, sans trop de douleur, et à un moment de ma vie où je n’avais pas trop de soucis. Ce n’est pas une raison pour me sentir supérieur : c’est plutôt un immense privilège.

J’admire les gens qui savent faire un bilan sur leur carrière, pivoter vers une nouvelle, s’y lancer alors qu’ils ont sur le dos un prêt, des enfants, qu’ils doivent faire attention à leur couple, qu’ils ont des investissements associatifs ou s’occupent de proches plus âgés, le tout avec bien moins de naïveté que moi quand j’ai commencé. Ce sont de vrais héros et héroïnes.

Est-ce qu’on peut s’interroger sur la manière dont la filière forme (en reconversion ou non) ? Oui, complètement. J’ai moi-même formé et je sais comment sont fait les programmes dans beaucoup d’écoles : pour nourrir les biais des parents des étudiants.

Est-ce que les formations courtes font mieux ? Non. Elles aussi vendent un time-to-market qui n’est pas réaliste et des salaires de sortie qui sont souvent de belles promesses. Mais ça ne veut pas dire que les gens ne sortent pas aussi compétents que d’autres juniors.

Est-ce que c’est un problème que des gens soient juniors ? Je ne crois pas. Je pense que beaucoup de gens peuvent venir au code tardivement, ou superficiellement, et que ce n’est pas grave. Ils ne volent le job de personne. Ils décrochent un job avec leurs compétences.

Est-ce que c’est ce dont les entreprises veulent ? Peut-être pas. Et c’est du coup très dur pour ces nouvelles personnes sur le marché. Beaucoup sont paupérisés dans des status qui leur font porter le risque de leur emploi, à des taux journaliers dérisoires.

Parenthèse : vous connaissez ma femme ? Allez lire son blog ou voir sa conférence sur le sujet.

Est-ce que les entreprises n’ont pas un rôle à jouer dans la situation ? Certainement. Peu sont enclines à l’embauche de ses profils, parce qu’elles ne veulent pas porter la formation de ces salarié ?

Elles en viennent à réclamer de la formation sur le temps libre du personnel, alors même qu’elles ont l’obligation légale de maintenir leurs salarié au niveau pour leurs postes. Mais bon, à ce niveau, c’est une culture de toute l’industrie du développement où la perception de la montée en compétence est à revoir. Nous sommes souvent traités comme des client de nos propres entreprises, responsables de notre formation avec le levier d’aller voir ailleurs si on n’est pas content.

Cette dynamique de turn-over fait que les entreprises embauchent des juniors en continu pour leur demande d’exécuter des tâches que des personnes désormais seniors faisaient, mais qu’elles ne font plus puisqu’elles sont parties chercher de la reconnaissance ailleurs.

Et comme ces entreprises sont en besoin de remplacement à profil identique, elles vont naturellement embaucher des gens qui ressemblent à ceux qu’elles avaient avant en laissant peu de place à des personnes en reconversion (ou à des femmes s’il y a déjà peu de femmes en place).

Rien de tout ça n’est de la faute des formations, il faudrait en prendre conscience. Les formations ont leur tort (sérieux, quand je vois des formations web qui ne forment pas aux bases de HTML, je pleure) mais cette problématique d’adéquation des profils formés aux besoins des entreprises est une dynamique systémique de marché.

  1. Je vous renvoie vers l’excellent article de Medhi sur la formation au développement. ↩

Tu devrais faire de la WebPerf

Cher confrère, chère consœur, tu devrais t’intéresser à la Performance Web. C’est un sujet qui se trouve au cœur du web, qui a besoin de spécialistes, et est en plein essor. Je sais que tu ne me crois pas, ou que tu penses que ce n’est pas simple et tu as bien raison. Alors laisse-moi t’expliquer où on en est et pourquoi on a besoin de toi.

Note : cet article a d’abord été publié sur 24 Jours de Web.

De la Performance Web, ou webperf, j’en fais depuis plus de dix ans. J’en ai parlé publiquement la première fois en 2012 1. Je disais qu’il fallait aborder le sujet en quatre temps : prendre conscience de l’enjeu, puis apprendre à optimiser, faire un suivi des performances et enfin, en parler en interne pour éviter de futures dégradations.

Huit ans plus tard, je pense toujours que c’est la meilleure manière d’aborder le sujet. Mais autour de moi, ça ne parle pas forcément beaucoup de performance web. Pour toutes celles et ceux qui n’ont pas forcément suivi où nous en sommes, faisons un tour d’horizon du sujet.

Le sujet est dense, mais mon but n’est pas de t’étouffer sous les informations. Si tu veux aller plus loin, tu trouveras plein de notes de bas de page menant à des lectures additionnelles.

Un point sur la situation

On va commencer par un peu de définitions.

La webperf, c’est tout ce que tu vas pouvoir faire pour que ton site soit ressenti comme plus performant par une personne l’utilisant. Ça part de l’expérience d’utilisation de ton site ou de ta web app (y compris les animations), puis on redescend dans les couches, avec du code HTML, CSS et JS, de la configuration de serveurs et enfin une analyse des infrastructures et services tiers que tu t’autorises à utiliser, et de leur configuration.

Attention, dans la mesure où un site performant consomme moins de ressources, la performance web partage 90 % de son ADN avec l’éco-conception. Mais certaines bonnes pratiques de performance web, comme l’utilisation de CDN, ne collent pas aux attentes écologiques 2.

On a généralement l’intuition qu’une application plus rapide est plus agréable. Avec la webperf, on a des chiffres qui le confirment. Beaucoup de marques ont commandité des missions d’optimisation et témoignent des gains obtenus, notamment sur la conversion 3. C’est un point important parce que ça veut dire que la webperf est un domaine de la Qualité Web dont le retour sur investissement est démontrable. Cela facilite les investissements.

Quand il y a des rémunérations à la clé, il est plus facile d’attirer des compétences. Il y a une bonne dynamique dans la communauté, qui s’alimente d’articles sur différentes expertises au sein de la web performance. Ça permet à l’ensemble de la communauté de progresser.

La « Front-End Performance Checklist » de Vitaly Friedman est une des ressources les plus complètes. C’est un généreux dossier remis à jour chaque année sur le Smashing Magazine. Le problème, c’est qu’on ne peut pas envoyer n’importe qui vers ce type de dossier : 53 pages se traduisant par une checklist opérationnelle de 13 pages 4, c’est pas à la portée de tout le monde : ça fait quand même une sacrée marche à monter.

Pour aller plus vite au cœur du sujet, on peut utiliser à la place un des nombreux outils et services d’analyse disponibles dans les navigateurs ou en ligne. Ces outils, qu’on appelle « synthétiques », sont super pratiques : ils analysent le chargement d’une page et produisent instantanément un rapport d’audit contextualisé permettant d’attaquer les points essentiels 5. On peut souvent leur demander de faire des tests avec des contraintes sur-mesure. Ça permet de faire des hypothèses comme « je crois que c’est ce fichier JS qui ralentit l’affichage », puis de tester en bloquant ce fichier et voir si l’affichage se produit vraiment plus vite. Ça permet aussi de mesurer la performance d’un site face à ses concurrents.

Mais la force de ces services est aussi leur faiblesse : ils ne mesurent que ce qu’on leur demande de mesurer. Ils ne peuvent pas dire si les sites sont rapides chez les gens. Si tu as besoin d’obtenir ces infos, il faudra te tourner vers des outils de télémétrie (des analytics). La télémétrie que tu utilises d’habitude peut suffire 6, mais pour aller plus loin dans l’évaluation de la frustration des utilisatrices, il faudra te tourner vers des solutions plus élaborées 7. En revanche, un peu d’implémentation sera nécessaire.

À l’inverse, si ton site web est public et reçoit beaucoup de visites, tu peux utiliser des données de terrain collectées par d’autres. Ces jeux de données sont pratiques, parce qu’ils sont accessibles sans rien installer sur les sites (et du coup, comme avec les outils synthétiques, tu peux faire des comparaisons entre sites). Les données ne sont pas forcément difficiles à récupérer, mais peuvent être incomplètes (par exemple, ne concerner que Chrome 8).

Dans l’absolu, dès que tu utilises des données de terrain, prends du recul. L’interprétation des résultats est très compliquée parce que beaucoup de facteurs peuvent affecter la performance mesurée 9. Si tu as l’intuition de quelque chose, n’hésite pas à valider cette hypothèse en recoupant avec d’autres données, ou via des tests synthétiques.

Pour résumer

Aujourd’hui, les connaissances techniques sur la performance web sont largement consensuelles et testables via des outils d’analyse automatisés. Des données de terrains génériques sont facilement accessibles et permettent d’avoir un retour sur les optimisations apportées, dont le coût n’a pas de mal à être financé et le gain à être mesuré.

Et pourtant… si on regarde les données de terrain, on peut voir que la performance des sites ne s’améliore pas franchement.

Évolution de l'indicateur First Contentful Paint de janvier 2017 à août 2020, mesuré en contextes Mobile et Bureau. Dans un cas comme dans l'autre, des fluctuations sont présentes et souvent corrélées entre les deux contextes, mais dans l'ensemble, la valeur moyenne varie peu voire se dégrade.

Évolution de l’indicateur First Contentful Paint de 2017 à 2020. Source : HttpArchive

Du coup, le paysage ne doit pas être si rose que ça. Faisons un petit tour des choses qui sont encore difficiles.

Le chemin qu’il nous reste à parcourir

Comme beaucoup de sujets de la Qualité Web, la performance web est l’affaire de toutes et tous. Pour améliorer les performances d’un site, il faut non seulement comprendre d’où viennent les problèmes mais également être capable de déterminer qui sont les personnes à contacter pour les résoudre. Comme la webperf concerne tous les corps de métier du Web, tu vas vite te retrouver à devoir parler à des gens très différents. Même sur des problèmes qui ont l’air simple.

Prenons l’exemple de l’optimisation des images. Dis comme ça, ça a l’air simple et beaucoup de gens auront l’impression de comprendre. Mais pour aborder le sujet dans sa globalité, il faut :

  • former les personnes à choisir le meilleur format en fonction de l’image ;
  • encadrer la contribution (pour éviter les images trop grosses) et déclencher l’optimisation et la génération de plusieurs variantes d’images en fonction du contexte et de la direction artistique ;
  • modifier le code HTML permettant d’insérer les images et éventuellement mettre en place un proxy d’images avec une négociation de contenu (interne ou externe), afin que chaque personne reçoive une image adaptée à son contexte

Et je n’ai même pas encore parlé de lazy loading.

Tu l’auras compris, quand tu commences à parler de performance web en entreprise, le plus dur n’est pas forcément la technique. C’est aussi de faire parler ensemble différents métiers afin d’avoir une vue d’ensemble de la situation et des actions à mener.

D’autant que c’est parfois difficile de parler de la même chose. Il y a vraiment beaucoup d’indicateurs différents et comme si ça ne suffisait pas, de nouveaux indicateurs apparaissent régulièrement. Il y a certains indicateurs qui sont vraiment pérennes, comme le Speed Index 10, un indicateur de référence depuis près de 10 ans. D’autres sont mal nommés, ou ne permettent pas de prendre des décisions, ou informent sur quelque chose qui n’est pas forcément primordial. Il faut donc sans cesse s’interroger sur les mesures, mais aussi sur la manière dont on mesure.

Mais le top du top, c’est quand on utilise ses propres indicateurs, des jalons temporels sur-mesure. Côté serveur, on appelle ça des Server Timings 11. Côté navigateur, on parle de User Timings 12. Contrairement aux autres indicateurs, ils correspondent à ce que ton équipe choisit elle-même de surveiller. On peut les retrouver quand on analyse la page dans les outils de développement de son navigateur et ils sont collectables par tous les outils d’analyse. Pourquoi s’en priver ?

Quand tu vas vouloir optimiser la performance d’un site, tu vas parfois te heurter aux librairies utilisées par d’autres pour répondre à des besoins métiers. Ces librairies répondent souvent à une liste d’objectifs mais n’ont pas en vue la webperf. Du coup les gens qui les utilisent n’ont parfois jamais entendu parler de performance. Et rien n’est prévu, dans ces solutions, pour les optimiser.

Concrètement, ça veut souvent dire qu’optimiser va être difficile, techniquement ou parce que les gens avec qui tu vas parler ne comprennent pas ce besoin. Quand l’optimisation n’est vraiment pas possible, n’oublie pas de l’écrire dans un référentiel de la dette technique, en espérant que celle-ci sera résolue à la prochaine refonte.

Pourquoi on a besoin de toi

Tu l’auras compris, le sujet de la Performance Web, comme tous les sujets de la Qualité Web, est un sujet technique. Mais cette technique, en fait, elle s’apprend assez bien.

Je ne vais pas te mentir : monter en compétence, c’est long. Mais les compétences acquises ne dépendent d’aucun framework, d’aucune solution du marché, d’aucune tendance. Il s’agit de comprendre comment fonctionnent les standards du web : HTTP, HTML, JS et CSS. On peut difficilement faire plus réutilisable et crois-moi : ça vaut le coup.

Tu verras que quel que soit ton rôle dans la chaîne de production du web, tu peux acquérir ces compétences et les mettre au service d’une meilleure performance des sites web.

Bien sûr, il nous faut des gens prêts à optimiser des sites web. Il y a une vraie demande à ce sujet. Mais c’est loin d’être la seule manière de participer. C’est même la fin de la chaîne.

Pour déjà comprendre le problème, on a besoin de Data Analysts capables d’analyser les données d’utilisation et d’affiner les mesures, pour mieux mettre en balance les investissements et les gains. Savoir qu’un sujet est pertinent parce que d’autres le disent, ce n’est pas pareil que de pouvoir ajuster son investissement au fil de ses besoins et de ses gains à soi.

Il faut que le sujet de la Performance infuse dans le développement des librairies de tous types. Qu’il s’agisse de Back-End ou de Front-End, il faut que ces projets intègrent la performance comme un besoin fondamental, de la même manière que la sécurité ou l’accessibilité.

On a besoin de designers qui pensent à la manière dont leurs interfaces sont progressivement affichées et priorisent les éléments les plus attendus par les utilisateurs et utilisatrices afin d’améliorer leur ressenti 13.

Tes compétences sont plutôt liées au Back-End ? Parfait. Nous avons aussi besoin de gens comme toi pour optimiser l’exécution du code, configurer des systèmes de cache serveur, ou aider au développement de serveurs intermédiaires de performance qui peuvent aider à optimiser un site rapidement en attendant que des corrections de fond soient réalisées 14.

Enfin, il nous faut aussi des personnes pour assurer la médiation de tous ces métiers, nourrir et encadrer le dialogue, permettre les conditions du succès et notamment la formation à un socle commun de compétence (en commençant par Opquast 15, par exemple).

Pour toutes ces raisons, tu devrais faire de la Performance Web.

Et, si ça se trouve, tu en fais déjà.


Les illustrations présentes dans cet article sont issues du projet Undraw, créé par Katerina Limpitsoun. Vous pouvez les utiliser dans n’importe quel projet, qu’il soit commercial ou personnel, sans attribution ni frais.

Merci à Carine Sobisiak, Olivier Rundstadler et Nicolas Goutay pour leurs relectures et leurs suggestions.

  1. « Mettre en place une stratégie de performance web » lors de Sud Web 2012. ↩

  2. Romuald Priol en parle très bien dans l’article « Les impacts du numérique : bonnes pratiques pour un Web plus écologique ». ↩

  3. WPOStats.com recense des études de cas et expériences démontrant l’impact de l’optimisation des performances web sur l’expérience d’utilisation et le succès commercial. ↩

  4. « Front-End Performance Checklist 2020: the PDF », 166 Ko. ↩

  5. Dareboost, sur lequel je travaille, est un de ces outils et j’en suis très fier, mais c’est loin d’être le seul. Calibre, Speedcurve, GTMetrix, Pingdom, entre autres, proposent également des rapports instantanés et du suivi. Les équipes de développement peuvent également utiliser Lighthouse ou WebHint sur leurs postes. ↩

  6. Exemple avec « Analyser la vitesse de chargement d’un site web via Google Analytics » par Anthony Barré mais personnellement, je collecte avec Matomo. ↩

  7. Voir à ce sujet « User Experience & Performance: Metrics that Matter », par Philip Tellis. ↩

  8. Il s’agit ici du Chrome User Experience Report, ou CrUX pour les intimes. ↩

  9. « Comment interpréter les mesures de performance réelles (RUM metrics) », par Gilles Dubuc. ↩

  10. « Speed Index : tout savoir sur cet indicateur majeur de la performance web », par Damien Jubeau. ↩

  11. « MDN Server-Timing Documentation ». ↩

  12. « Custom Timing : attendez la prochaine frame quand vous utilisez la User Timing API ». ↩

  13. « Mind over Matter: Optimize Performance Without Code », par Stéphanie Walter. ↩

  14. La solution française de référence, c’est Fasterize. ↩

  15. Opquast, la certification des du Web. ↩

Cumulative Layout Shift, l’indicateur de stabilité de la mise en page

Avez-vous déjà commencé à lire un article d’actualité passionnant, puis perdu votre ligne parce que tout le texte s’est déplacé vers le bas ? Cela m’arrive souvent, surtout à cause des publicités qui se chargent au-dessus du contenu.
Ce type d’expérience utilisateur peut être frustrant, mais jusqu’à présent, nous avons eu du mal à la mesurer quantitativement. Le Cumulative Layout Shift relève ce défi.

Note : cet article a d’abord été publié sur le blog de Dareboost (abandonné).

Lorsque vous voyez une page web, votre cerveau décompose l’information visuelle en éléments. L’agencement de la page vous donne des informations sur leurs relations les uns par rapport aux autres. C’est comme ça que vous détectez le contenu pertinent. Si ce contenu se déplace tout seul, ou si un autre élément est injecté dans la page et déplace les autres, alors vous risquez de le perdre de vue.

Chargement de la page d’accueil de LeMonde.fr. Les contenus insérés et en mouvement sont identifiés par des zones bleu clair. Le contenu d’environ 2/3 de l’écran se déplace pendant le chargement de la page.

Pire encore, vous pouvez penser que la mise en page est stable et essayer d’interagir avec la page. Par exemple en cliquant sur un bouton (image de gauche). Si un autre contenu apparaît juste avant le clic et pousse l’autre contenu vers le bas (image de droite), vous risquez d’interagir avec le mauvais élément.

Deux images d’un utilisateur tenant un téléphone dans sa main. Dans la seconde image, un tapotement est matérialisé.

L’utilisateur est sur le point de tapoter sur l’image d’un fauteuil, dans une liste de produits. Soudainement, un texte avec un bouton est inséré en haut de page, déplaçant tout le contenu vers le bas. L’utilisateur clique involontairement sur l’image d’un sac à dos.

Plan

Dans cet article, nous introduirons l’API Layout Instability et verrons comment elle est utilisée pour calculer le Cumulative Layout Shift (CLS). Nous verrons comment visualiser le CLS dans Chrome et comment optimiser son site pour avoir un bon CLS. Enfin, nous aborderons les étranges caractéristiques du CLS et nous conclurons.

Une API dédiée dans le navigateur…

Depuis plusieurs années, les équipes Front tentent d’identifier les éléments qui se déplacent pendant le chargement et l’utilisation d’une page. Il y a dix ans, il fallait un moteur de rendu sur-mesure pour afficher tous les repaints (dans l’exemple ci-dessous, Gecko, le moteur de rendu de Firefox).

ATTENTION

Cette vidéo contient beaucoup de clignotements. Ne la regardez pas si vous êtes photosensible ou si vous souffrez de troubles vestibulaires.

Pour déterminer le moment où une page est chargée/stable, vous pouviez utiliser l’événement onload, mais c’est loin d’être parfait. L’API Layout Instability de Chrome répond à cette limite. L’idée ici est de s’intéresser à d’autres signaux. Plus particulièrement, à la stabilité de la mise en page, ou « l’absence de sursauts d’interface ». Comme indiqué dans le résumé de l’API, elle « offre aux auteurs de pages web un aperçu de la stabilité de leurs pages, à partir des mouvements des éléments de la page ». Pour ce faire, l’API surveille les nœuds du DOM qui sont visibles dans le viewport. Si la représentation visuelle d’un nœud se décale, entre deux frames, de 3 pixels ou plus dans le sens horizontal ou vertical, l’API enregistre un layout-shif (un décalage) et lui attribue un score.

… utilisé pour pénaliser les saccades

Revenons à notre exemple :

Deux images d’un utilisateur tenant un téléphone dans sa main. Dans la seconde image, un tapotement est matérialisé.

L’utilisateur est sur le point de tapoter sur l’image d’un fauteuil, dans une liste de produits. Soudainement, un texte avec un bouton est inséré en haut de page, déplaçant tout le contenu vers le bas. L’utilisateur clique involontairement sur l’image d’un sac à dos.

Comment l’API Layout Instability attribue-t-elle un score à ce décalage ? Pour calculer le score de décalage (layout shift score), l’algorithme évalue d’abord la zone affectée par le décalage (impact fraction), et la multiplie par la longueur du décalage (distance fraction).

La zone affectée par le layout shift, ou impact fraction (fraction d’impact), est la zone totale occupée par le nœud qui se déplace, de sa première position à sa position finale. Ici, 78 % + 32 % = 110 %. Comme vous pouvez le voir, la fraction d’impact peut être supérieure à 100 % (la taille du viewport).

La longueur du décalage, ou distance fraction, est mesurée en pourcentage du plus grand côté du viewport. Dans cet exemple, nous allons donc considérer la hauteur. L’élément existant se déplace d’une hauteur équivalente à 34 % de la hauteur du viewport.

Pour ce Layout Shift en particulier, le score de Layout Shift est donc :

score de Layout Shift = 110 % (impact fraction) × 34 % (distance fraction) = 0,374

Le Cumulative Layout Shift (CLS) est la somme des scores de (presque) tous les Layout Shifts.

La fenêtre de 500 millisecondes

Pour éviter que les sites web ne soient pénalisés pour les transitions ou les animations qui résultent de l’interaction de l’utilisateur avec l’interface, l’algorithme du CLS ignore les Layout Shifts pendant 500 ms après chaque interaction active de l’utilisateur avec le document (par exemple, un clic, une frappe de touche ou un tapotement), ou après tout événement qui modifie directement la taille du viewport.

D’après Google, pour offrir une bonne expérience, les sites devraient s’efforcer d’avoir un CLS inférieur à 0,1 pour la plupart (75 %) des utilisateurs. C’est une mauvaise nouvelle pour les développeurs de l’exemple ci-dessus !

N’oubliez pas que la fraction d’impact et la fraction de distance sont dépendantes des caractéristiques du viewport. Une modification des dimensions ou de l’orientation du viewport peuvent modifier la mise en page (en provoquant une réadaptation du contenu à l’espace disponible). Si cela se produit, pour un même Layout Shift, la fraction d’impact et la fraction de distance, et donc le Cumulative Layout Shift, n’auront plus les mêmes valeurs.

Comment visualiser les Layout Shifts dans Chrome

Les Layout Shifts peuvent être affichés dans Chrome :

  1. Dans les DevTools (les outils de développement de Chrome), ouvrez le menu de commande en appuyant sur Control + Shift + P ou Command + Shift + P (macOS)
  2. Commencez à taper « Rendering »
  3. Exécutez la commande « Show Rendering » qui vous est proposée
  4. Activez la case Layout Shift Regions. Quand vous interagissez avec la page, les Layout Shifts apparaissent désormais en bleu.

Attention

Cette fonctionnalité peut provoquer des clignotements. Si vous êtes photosensible ou si vous souffrez de troubles vestibulaires, faites attention.

Depuis Chrome 84, vous pouvez également visualiser les Layout Shifts et obtenir des informations sur leur attribution (allant même jusqu’à la liste des éléments qui ont été décalés) dans l’onglet Performance, sur la ligne « Experience ».

Une capture de l’onglet Performance des DevTools, quand on zoome et qu’on sélectionne un Layout Shift en particulier.

Sur une ligne de temps, une succession d’écrans aide à comprendre la chronologie visuelle. En dessous, plusieurs lignes exposent ce qui s’est passé au même moment, y compris la ligne "Experience", qui contient des repères rouges, un pour chaque Layout Shift. Tout en bas, une description donne des informations plus précises sur le Layout Shift sélectionné.

Comment optimiser votre Cumulative Layout Shift

Une page accumule des Layout Shifts tout au long de son utilisation. À chaque fois que de nouveaux éléments sont insérés visuellement sans que l’espace nécessaire à leur affichage n’ait été réservé en amont par le navigateur. Le plus souvent, il s’agira d’images, mais vous devez également faire attention aux publicités, aux polices de caractères web, aux contenus intégrés et aux contenus injectés suite à une interaction qui génèrent des temps d’attente de plus de 500 ms.

Images

Quand il reçoit le code HTML de votre page, le navigateur ne sait pas grand choses sur les images qui y sont utilisées. S’il ne dispose que de l’URL de l’image, le navigateur ne peut pas connaître sa taille. Il ne peut donc pas allouer l’espace nécessaire à l’affichage de cette image. Cette situation est devenue encore plus complexe depuis l’avènement du Responsive Web Design puisque désormais, la taille d’affichage d’une image dépend souvent du contexte.

Pour donner le plus d’informations possible au navigateur (afin qu’il puisse faire son travail au mieux) définissez toujours les valeurs des attributs width et height sur vos éléments <img> (exprimées en pixels). Même si ce ne sont pas les dimensions réelles de l’affichage (qui peuvent dépendre des règles de style), le navigateur les utilisera pour déduire le rapport largeur / hauteur (appelé aspect-ratio) de l’image, et ainsi calculer la hauteur à réserver en fonction de la largeur d’affichage définie par le CSS.

Le saviez-vous ?

Edge, Firefox et Chrome ont une représentation interne du aspect-ratio des images sur lesquelles les attributs width et height sont définis. Une expérience est en cours sur Chrome pour ouvrir la fonctionnalité aux équipes de développement web.

.el {
    aspect-ratio: 16 / 9;
}
/* internal rule for img, using the --webkit prefix (in Chrome)
img[width][height] {
  --webkit-aspect-ratio: attr(width) / attr(height);
}*/

Pour en savoir plus sur aspect-ratio lisez cet article de Chris Coyier sur CSS Tricks

Et bien sûr, n’oubliez pas de servir la bonne taille de fichier en fonction du contexte. Utilisez srcset pour aider le navigateur à sélectionner la meilleure image de votre jeu d’images avec le même rapport hauteur/largeur (suivant la largeur du viewport). Utilisez picture et source pour gérer différents rapports hauteur/largeur ou différents formats d’image en fonction du contexte et des types supportés par le navigateur.

Publicités, intégrations, iframes et contenus créés dynamiquement

Comme pour les images, le navigateur doit allouer l’espace nécessaire pour afficher le contenu final. Mais vous ne pouvez pas donner beaucoup d’informations au navigateur, car souvent, vous ne disposez vous-même que de peu d’informations sur le futur contenu. Dans ce qui suit, je ne parlerai que du cas des publicités, car elles constituent un problème récurrent. Mais l’approche est la même pour les autres types de contenus injectés.

Dans la suite, nous examinerons l’impact des injections de contenu sur le contenu d’une page. Notez que le contenu des iframes n’est pas concerné : si une iframe produit de Layout Shifts, ceux-ci n’auront pas d’impact sur la page principale.

Le plus souvent, l’espace publicitaire est attribué à un service d’enchères qui injecte un conteneur publicitaire dans un nœud dédié du DOM. Ensuite, cet espace est « loué » au plus offrant, attribué à une régie qui injecte enfin une publicité. L’espace peut être redimensionné plusieurs fois avant que la publicité finale ne soit affichée, et dans le cas de publicités temporisées, des injections supplémentaires peuvent se produire plusieurs fois pendant la session de l’utilisateur.

Comment éviter que la mise en page soit modifiée ?

Définissez explicitement l’espace que vous souhaitez allouer au conteneur publicitaire. Prévoyez un habillage pour prendre en compte le cas dans lequel l’annonce serait plus petite que l’espace pré-réservé. Si l’annonce est plus grande que l’espace réservé, il faudra accepter qu’une partie de l’annonce ne soit pas affichée.

Il arrive que l’espace reste vide, si aucune publicité n’a été trouvée. Prévoyez des visuels correspondant à la taille de l’espace publicitaire afin de ne pas avoir à réduire l’espace publicitaire et à provoquer un changement de disposition. Si votre régie vous donne les moyens (par le biais d’un callback JS, par exemple) d’injecter du contenu utile en cas d’absence de publicité, bien sûr, n’hésitez pas.

Une autre façon de résoudre ce problème consiste à positionner les publicités dans l’espace négatif laissé par le contenu du site, en dehors du flux de pages. Si votre publicité a une position figée dans le gabarit de page, et que cette position n’interfère pas avec l’agencement du reste du contenu, alors l’insertion de la publicité ne provoque aucun décalage.

Une capture d’une page du Monde.fr où un espace est réservé pour une publicité dans la marge. Si la publicité est plus grande que prévue, elle occupe davantage de place dans la marge, mais ne décale pas le contenu.

Utilisation de l’espace négatif pour positionner les annonces.

Enfin, vous pouvez décider de déplacer vos espaces publicitaires plus bas sur vos pages. Cela évitera que la fraction d’impact du Layout Shift ne soit trop importante, mais cela réduira probablement vos revenus.

Police d’écriture web

Lorsqu’un navigateur doit afficher du texte avec une police d’écriture web, il détermine si la police est nécessaire et disponible (via le système d’exploitation ou dans le cache navigateur). Si la police est nécessaire mais non disponible, le navigateur la récupère. Pendant la phase de récupération, le navigateur suit les instructions font-display (ou leur absence) pour déterminer s’il doit afficher le texte avec une police de substitution disponible ou allouer l’espace avec du texte invisible. Une fois la police chargée, ou si le temps d’attente est trop long, le navigateur procède alors au rendu final.

En d’autres termes, chaque fois que le navigateur doit récupérer une police web, il attribue à la zone un texte avec une police par défaut, visible ou non. Et lorsque la police devient disponible, le navigateur effectue le rendu final de la zone de texte.

Problème : la police temporaire utilisée pour occuper l’espace n’a pas nécessairement pas nécessairement les mêmes caractéristiques que la police finale. Les lignes de base, la taille des points typographiques et les kernings peuvent être différents et le texte final peut apparaître plus court ou plus long que le texte temporaire, ce qui peut déplacer les contenus qui suivent dans le flux de page, et entraîner des Layout Shifts.

Chaque fois que j’ai besoin de me rappeler comment fonctionne la gestion de l’affichage des polices, je retourne voir le the font-display playground, de Monica Dinculescu.

Pour éviter ces Layout Shifts, vous pouvez accélérer le chargement des polices. ou choisir des polices web ayant des caractéristiques très proches des polices système. Vous pouvez également considérer la police web comme optionnelle lors du premier chargement de la page. Elle ne sera alors pas utilisée sur cette page, même si elle est téléchargée et mise en cache. En revanche, elle sera disponible pour la page suivante. À ce sujet, vous pouvez lire « eBay’s Font Loading Strategy » de Senthil Padmanabhan.

Contenu injecté plus de 500 ms après une interaction

L’algorithme du CLS ignore les Layout Shifts pendant 500 ms après chaque interaction active de l’utilisateur avec le document ou modification de la taille du viewport. Grâce à ce mécanisme, la plupart des interactions utilisateur ne provoquent pas de Layout Shifts comptabilisés dans le Cumulative Layout Shift.

Assurez-vous donc que votre interface réagira à l’interaction utilisateur dans la fenêtre de 500 ms. Si votre interface utilisateur repose sur des requêtes réseau ou un traitement javascript lourd, des décalages peuvent se produire après 500 ms et seront donc pris en compte dans la valeur du Cumulative Layout Shift.

Pour optimiser votre CLS :

  • Assurez-vous que vos transitions et animations qui suivent une interaction utilisateur durent moins de 500 ms.
  • Mesurez et optimisez les temps de réponse des vos API.
  • Anticipez le résultat de l’appel (ou des appels) ou du long traitement en réservant l’espace associé au(x) résultat(s) durant les 500 ms qui suivent l’interaction, quitte à ce que cet espace soit rempli ultérieurement, à la manière de l’optimistic UI.
  • Implémentez un paradigme d’interface utilisateur spécifique aux longs traitements et un appel réseau (mise en file d’attente et notification d’achèvement, affichage des résultats dans des pop-ins, etc.)
  • N’animez que des propriétés CSS qui ne déclenchent pas de changements de mise en page dans Blink.

Bien sûr, testez toujours vos optimisations. En menant quelques expériences pour écrire cet article, j’ai découvert que lorsque la durée d’une transition translate est de 0, des Layout Shifts apparaissent (un problème désormais résolu). Des cas-limites comme celui-ci existeront toujours. N’hésitez pas à les signaler à l’équipe Chromium.

Astuce: un traitement en deux étapes

Prenez l’exemple d’un bouton « Charger 20 articles supplémentaires » en fin de page. Si le traitement (appel réseau + rendu) prend moins de 500 ms, c’est parfait. Mais s’il prend plus de 500 ms, le rendu peut provoquer un décalage du pied de page et augmenter votre Cumulative Layout Shift.

Pour éviter ça, surveillez le temps écoulé et divisez la tâche en deux parties si nécessaire. Au lieu de faire un rendu systématique après l’appel réseau, vous pourrez plutôt changer le libellé du bouton en « Afficher les 20 éléments récupérés ». Cela obligera les utilisateurs à interagir à nouveau avec la page et vous accordera 500 millisecondes supplémentaires pour le rendu du contenu.

Bien sûr, n’hésitez pas à tester le ressensi des utilisateurs pour vérifier que l’utilisation de la fonctionnalité correspond mieux à leurs attentes. Optimiser le CLS ne doit pas se faire au détriment de l’UX.

Comportements contre-intuitifs

Augmentation continue dans le cas des Single-Page Applications (SPAs)

La plupart des algorithmes de calcul des indicateurs de performance web s’arrêtent à la fin du chargement de la page. L’évaluation du Cumulative Layout Shift, elle, se poursuit tout au long de l’utilisation de la page.

Beaucoup de sites web sont construits sur un paradigme de navigation de page à page, d’URL à URL. Pour eux, le CLS est réinitialisé à chaque changement de page. Certains sites, en revanche, sont construits autour d’une page unique dont le contenu évolue au fil des interactions. C’est ce qu’on appelle des Single-Page Applications (SPA).

Sur les SPA (y compris les applications qui utilisent des bibliothèques d’amélioration progressives comme turbolinks), le Cumulative Layout Shift augmente en continu pendant la session d’un utilisateur, puisque la navigation entre les contenus ne se fait pas en naviguant entre des pages. Le Cumulative Layout Shift n’est donc collecté que lorsque l’utilisateur quitte la page. Si la valeur du Cumulative Layout Shift que vous observez dans la Search Console (rubrique « Signaux Web essentiels ») vous semble élevée, c’est peut-être une explication.

Note

Ce comportement spécifique du Cumulative Layout Shift est particulièrement important. Pour les équipes développant des SPAs, l’objectif ne doit pas être de réduire le nombre de Layout Shifts, mais de concevoir des interfaces qui ne produisent aucun Layout Shifts. Dans le cas contraire, plus leurs interfaces sont populaires, plus les durées des session de leurs utilisateurs et utilisatrices seront longues, plus le CLS mesuré sera élevé.

Le problème des barres de défilement

Bien que cela puisse paraître contre-intuitif, les barres de défilement horizontales et verticales font partie du viewport. Elles sont notamment incluses dans les dimensions de pourcentage du viewport vw et vh. L’apparition ou la disparition des barres de défilement ne modifie donc pas le viewport, et ne sont donc pas éligibles aux « 500 ms sans accumulation de CLS ». Pourtant, l’apparition et la disparition des barres de défilement modifient la zone disponible pour les contenus, qui peuvent donc se déplacer pour mieux l’occuper, provoquant un Layout Shift.

Sur certains systèmes d’exploitation, comme Windows, les barres de défilement sont cachées jusqu’à ce qu’elles soient nécessaires. Si le chargement de votre site est très progressif (avec par exemple une page vide au début puis des requêtes JavaScript qui, petit-à-petit, créent le contenu), alors les barres de défilement peuvent être absentes lors du First Paint, puis apparaître au cours du chargement de la page et provoquer des Layout Shifts.

Pour éviter ce comportement, vous pouvez ajouter html { overflow-y: scroll } afin de forcer l’apparition d’une barre de défilement au First Paint, ou attendre l’implémentation du module CSS Overflow de niveau 4 et la nouvelle propriété scrollbar-gutter.

Impact de la timing-function

Dans l’exemple suivant, nous comparons deux mises en page réalisées avec flexbox. Dans les deux cas, le survol de l’élément central double sa surface. Sur la première ligne, la timing-function est ease. Sur la seconde, c’est linear.

Comme vous pouvez le voir, le deuxième exemple génère beaucoup moins de Cumulative Layout Shift. Pour l’expliquer, nous devons revenir à la spécification de l’API Layout Shift, et plus précisément à ce que l’on appelle les « nœuds instables » (« Unstable nodes »).

A Node N has shifted in a coordinate space C if the starting point of N in C differs from the previous frame starting point of N in C by 3 or more pixel units in either the horizontal or vertical direction.

qu’on peut traduire par :

Un nœud N s’est déplacé dans un espace de coordonnées C si le point de départ de N en C diffère du point de départ de la trame précédente de N en C de 3 unités de pixels ou plus dans le sens horizontal ou vertical.

Cette règle des « trois pixels entre deux frames » introduit un critère de vitesse dans la mesure de l’instabilité. Tous les éléments se déplaçant en dessous de cette vitesse ne sont pas considérés comme instables, et ces animations ne produisent pas de Layout Shifts.

Malheureusement, cela signifie que pour réduire le CLS, certains propriétaires de sites pourraient être tentés d’utiliser des animations linéaires, qui ont une vitesse constante, plutôt que des animations plus intuitives pour l’homme, telles que ease, qui accélère au début de l’animation et ralentit à la fin.

Les timing-function `ease`et `linear`, représentées par des courbes de bézier.

La timing-function linear a une croissance constante. ease accélère fortement jusqu’au milieu du temps, puis ralentit.

Autres comportements étranges de l’indicateur

  • Les éléments animés qui créent des Layout Shifts peuvent continuer à le faire, même s’ils ne sont pas visibles pour l’utilisateur (par exemple, s’ils ont une couleur qui se fond avec l’arrière-plan). Mais si vous utilisez visibility: hidden, ce ne sera pas le cas.
  • La page web.dev du CLS (traduite en français par Sarah Salis pour Fasterize) recommande d’utiliser transform et translate pour créer des animations qui ne produisent pas de Layout Shifts. Chrome créer des Layout Shifts lorsque le temps de transition est de 0, jusqu’à Chrome 86.

Conclusion

Le Cumulative Layout Shift est un indicateur qui mesure les instabilités de la mise en page d’une page web. Pour l’optimiser et améliorer l’expérience utilisateur, vous devez éviter d’injecter du contenu pour lequel le navigateur n’a pas alloué la bonne quantité d’espace. Il existe plusieurs techniques pour les images, mais cela rendra toutefois la gestion de la publicité beaucoup plus complexe.

Le mode de calcul du CLS lui confère des caractéristiques inhabituelles. L’algorithme actuel du CLS n’est probablement pas adapté aux Single Page Apps, car l’attribution des résultats au niveau de la page n’est pas correctement gérée. Par conséquent, l’utilisation des Core Web Vitals (Signaux Web Essentiels) comme critère de classement pourrait être particulièrement difficile dans de tels cas.

N’oubliez pas que le CLS est une nouvelle mesure. Nous manquons encore de retours d’expérience à grande échelle. En cas de doute, concentrez-vous toujours sur l’amélioration de l’expérience de l’utilisateur plutôt que sur l’optimisation de l’indicateur lui-même. Certaines optimisations du CLS peuvent aller à l’encontre de l’UX et doivent être évitées.


Support Navigateurs

En octobre 2018, Steve Kobes a annoncé que Blink (le moteur de rendu Chrome) avait l’intention d’implémenter une API faisant émerger cette information. Le travail sur le projet d’API Layout Instability a commencé en mai 2019, et l’API a été publiée dans Chrome 77 en septembre 2019. Daniel Holbert a créé un ticket pour Firefox en juillet 2020. Nous n’avons trouvé aucune mention de l’API Layout Instability parmi les tickets publics de Safari.

Resources


Merci à Damien Jubeau et Matt Hobbs pour leurs contributions.

Punir la loyauté

Imaginons que vous déployiez, sur votre site, un outil de collecte du consentement lié à vos conditions générales d’utilisation (CGU). Ce consentement se découpe le plus généralement autour de différents usages : consentement à la télémétrie, consentement à la publicité, consentement à la transmission d’information à des tiers…

Si vous souhaitez mesurer avec finesse l’impact de ces différents « niveaux de consentement » sur la Performance Web, alors il faut faire le tour de tous les cas d’usage, en fonction de la relation qu’entretient la personne concernée avec votre site.

Pour mesurer les performances de ces cas d’utilisation, vous aurez besoin soit de mesures réelles, soit de solutions de surveillance synthétique. La plupart des outils ignoreront la bannière de cookies et testeront donc sans charger ces dépendances supplémentaires. Vous devrez donc configurer vos tests de manière à ce qu’ils commencent par une configuration spécifique (souvent un cookie) pour reproduire tous les cas d’utilisation :

  1. Cette personne bloque le script de demande du consentement (via un adblocker, par exemple).
  2. Cette persone a donné son consentement à cette version des CGU.
  3. Cette personne a donné son consentement à une version antérieure des CGU, il est donc nécessaire de lui redemander son consentement.
  4. Cette personne a refusé son consentement à cette version des CGU.
  5. Cette personne a refusé son consentement à une version antérieure des CGU ; il peut être opportun de lui demander son consentement à nouveau.

Le cas numéro 3 peut donner lieu à une quantité importante de tests car il faudrait idéalement procéder à tes tests pour l’ensemble des combinaisons de consentements : « télémétrie », « télémétrie + publicités », « publicités seule »…

Pour simplifier, vous pouvez vous concentrer sur les deux tests les plus extrêmes :

  1. que se passe-t-il si la personne refuse ou ne donne pas son consentement ?
  2. que se passe-t-il si la personne a accepté l’ensemble des usages courants ?

Très souvent, le second cas est bien plus lent et inutilisable que le premier, sans pour autant que ces personnes ne se voient offrir de nouvelles fonctionnalités compensant cette dégradation.

L’occasion pour les Responsables Produit de réfléchir à l’éthique de ce type d’implémentation. Est-il normal que nous offrions l’expérience la plus dégradée à nos utilisateurs et utilisatrices les plus fidèles ?

Cette réflexion peut aboutir à une transformation de l’offre, soit vers un modèle où les utilisateurs et utilisatrices fidèles sont récompensé pour leur sacrifice (en ayant accès à des fonctionnalités qui ne sont disponibles que pour celles et ceux qui acceptent la collecte de données par des tiers), soit vers un modèle payant, plus protecteur mais moins accessible à tous.

Philosophiquement, nous entrons alors dans des considérations très actuelles sur la vie privée en tant que capital ou en tant que commun. Un sujet fascinant.

Priorités des chargements JavaScript dans Chrome

Je relis et conseille souvent cet article d’Addy Osmani de février 2019 mais mes interlocuteurs et interlocutrices ne sont pas forcément anglophones. J’ai donc décidé de le traduire.

Retrouvez l’original sur le blog d’Addy Osmani : JavaScript Loading Priorities in Chrome.

La façon dont les navigateurs ordonnancent et exécutent les scripts peut avoir un impact sur les performances des pages web. Si des techniques comme <script defer>, <link rel=preload> (et d’autres) influencent le chargement des scripts, il peut également être utile de savoir comment les navigateurs les interprètent. Grâce à Kouhei Ueno, nous disposons maintenant d’un résumé actualisé de la manière dont les scripts sont ordonnancés dans Chrome.

Priorité de chargement (network/Blink) Priorité d’exécution Comment l’utiliser ?
<script> dans <head> Moyenne/Haute Très Haute -
Interrompt l’analyse
  • Scripts ayant une incidence sur le rendu du First Meaningful Paint (FMP) / First Contentful Paint (FCP) content
  • Scripts devant être exécutés avant d’autres scripts

    Exemples :
    • Runtime de Framework (s’il n’y a pas de rendu statique)
    • Polyfills
    • Tests A/B qui modifient la structure du DOM de l’ensemble de la page
astuce <link rel=preload> +
<script async>
ou
<script type=module async>
Moyenne/Haute Haute -
Interrompt l’analyse
  • Scripts qui produisent un contenu critique (requis pour le FMP)
    • Mais ne devraient pas affecter la mise en page au-dessus de la ligne de flottaison
    • Scripts qui déclenchent des requêtes réseau pour injecter dynamiquement du contenu
    • Scripts devant être exécutés dès que leurs dépendances sont téléchargées, utilisez <script async type=module>

      Exemples :
      • Dessiner quelque chose dans un <canvas>
<script async> La plus basse/Basse Haute -
Interrompt l’analyse

Faites attention lorsque vous utilisez <script async>. De nos jours, il est souvent utilisé pour indiquer des scripts non-critiques mais ce n’est pas cohérent car même si le script est chargé en basse priorité, il est exécuté en haute priorité.

NdBoris : la attributes ne sont pas cumulatifs. Un script <script async defer> sera perçu par le navigateur comme un <script async> partout où async est supporté (c’est-à-dire… quasiment partout). La navigateur ne supportant pas async le considéreront comme un <script defer>.

<script defer> La plus basse/Basse Très basse -
S’exécute après les <script>s en fin de <body>
  • Scripts qui génèrent du contenu non-critique
  • Scripts qui fournissent des fonctionnalités critiques que >50% de sessions de pages utiliseront

    Exemples :
<script> en fin de <body> Moyenne/Haute Basse -
Attend la fin de l’analyse
Attention, quand vous utilisez <script> à la fin de <body> et que vous pensez définir une priorité basse. Ces scripts sont ordonnancés avec une priorité Moyenne/Haute.
<script defer> en fin de <body> La plus basse/Basse -
fin de queue
Très basse -
S’exécute après les <script>s en fin de <body>
  • Scripts offrant des fonctionnalités interactives utilisées occasionnellement

    Exemples :
    • Chargement des "Articles connexes"
    • Fonctionnalité "Votre avis nous intéresse"
<link rel=prefetch> + <script> lors d’une navigation vers la page suivante Inactive / La plus basse Dépend du moment et de la manière dont le script est consommé. Des scripts très susceptibles d’apporter des fonctionnalités importantes à une page visitée ultérieurement.

Exemples :
  • Bundle JavaScript d’une future route

Note : Les priorités de chargement ne sont pas nécessairement cohérentes d’un navigateur à l’autre. Utilisez donc ces connaissances à bon escient et mesurez-les en cas de doute. Dans l’idéal, cherchez à offrir une expérience de qualité au plus grand nombre d’utilisateurs possible.

Si vous êtes un développeur ou une développeuse web et que vous vous demandez où vous pouvez voir la « Priorité de chargement », Chrome DevTools a une colonne « Priorité » optionnelle disponible dans le panneau Réseau. Cliquez avec le bouton droit de la souris sur les en-têtes de colonne et vous pourrez l’activer :

Une capture des outils DevTools ouverts sur Walmart.com, onglet Réseau. On y voit un script de polyfill et un script de header en priorité haute, et un script de footer en priorité basse.

Cette synthèse des priorités ci-dessus est toujours valable en février 2019. Je souhaiterais personnellement avoir une meilleure compréhension des priorités de chargement dans d’autres navigateurs également. J’espère que cet aperçu sera utile à quelqu’un d’autre !

Merci à Kouhei, Dom Faralino, Pat Meenan, Kenji Baheux et Yoav Weiss pour leurs contributions permettant de mieux expliquer la pile réseau de Chrome.

En savoir plus


[Note de Boris] Et j’ajoute mes propres articles, en français :

Maîtrise de soi

Parfois, j’écris un tweet ou un billet de blog et je le supprime.
Parce que le monde n’en a pas besoin.
Parce que ça peut faire du mal à certaines personnes.
Parce qu’il y a d’autres moyens.
Parce que je peux vivre sans le publier
et que mon public mérite que je ne le fasse pas.

S’il vous plait, faites de même avec votre JavaScript.

Que penser des Core Web Vitals ?

Il y a quelques semaines, Google a créé une nouvelle appellation pour un jeu d’indicateurs de mesure de l’expérience utilisateur : les Core Web Vitals, ou Signaux Web Essentiels. La nouvelle fait grand bruit dans le monde du SEO, car Google souhaite faire de ces indicateurs des critères de ranking l’année prochaine.

Le déploiement est prévu en mai 2021.

Prenons un peu de recul.

Ceci est un avis personnel sur les Core Web Vitals. Retrouvez un avis complémentaire sur le blog de Dareboost : Signaux Web essentiels (Core Web Vitals) : un nouveau facteur SEO axé sur la vitesse des pages web.

Préambule 1 : qu’est-ce qu’un bon indicateur pour le marché ? À mon sens, c’est un indicateur qui mesure ce qu’il dit mesurer et qui, une fois cette mesure effectuée et les valeurs connues, aide à prendre des décisions pour améliorer l’expérience utilisateur.


Préambule 2 : les Web Vitals ne sont pas figés. Ce sont juste les indicateurs que Google met pour l’instant en avant dans ses outils de mesure de la performance. Comme ils le disent eux-mêmes :

[…] these signals are not perfect and future improvements or additions should be expected.

Rien ne garantit donc, même si c’est probable, que les indicateurs mis en avant aujourd’hui soient, l’année prochaine, toujours d’actualité. Pour rappel, Google a auparavant fait la promotion d’autres indicateurs, comme le Time To Interactive, avant d’en revoir l’appréciation à la baisse dans des itérations ultérieures de leurs outils (à raison).

De ce que j’ai vu du Cumulative Layout Shift, je pense qu’il sera également remplacé à moyen terme par un indicateur de meilleure qualité.

Suite aux critiques des équipes de développement de SPAs, la réflexion semble avoir commencé.


Préambule 3 : bien que la Performance Web soit mise en avant depuis des années par Google comme critère de ranking, et encore plus depuis la Speed Update, très peu de retours de terrain le confirment. Il semblerait que la Performance Web est plutôt, pour l’instant, un signal faible utilisé éventuellement pour de la pénalisation.

Cela ne veut pas dire que la Performance n’est pas utile : elle bénéficie au crawl et à l’expérience des personnes qui visitent vos sites, réduisant vos rebonds, améliorant votre conversion… C’est déjà énorme.

En revanche, c’est la première fois que Google communique explicitement sur des indicateurs utilisés. C’est très intéressant parce qu’on a vu plusieurs indicateurs être mis en avant au fil des années, notamment le Speed Index, et il a fallu attendre d’avoir un jeu d’indicateurs faciles à collecter pour eux (ne nécessitant pas l’usage d’une vidéo) pour que cette annonce soit faite.

Il y a donc fort à parier que le Speed Index n’a jamais été un indicateur calculé à l’échelle par Google, pour évaluer le ranking.


Dernier préambule : je pense que cette nouvelle dénomination de Signaux Essentiels ne va pas constituer une opportunité pour le monde du SEO. Comme le dit Olivier Andrieu :

L’UX ne sera jamais un critère SEO majeur. « Core Web Vitals : l’UX bientôt pris en compte par Google ? Prenons du recul… »

En revanche, c’est une opportunité intéressante pour les professionnels de l’Expérience Utilisateur, qui pourrait y voir une première phase peu coûteuse d’approche quantitative, préliminaire à une phase d’étude qualitative plus spécifique à l’usage étudié.

Et si c’est une clé pour l’UX, c’est donc aussi une clé pour le SXO (Search Experience Optimization).


Fin de la mise en bouche, parlons des Web Vitals en eux-mêmes !

Le First Contentful Paint (FCP) est facile à collecter (puisque fourni directement par Chrome), son nom correspond à sa définition et celle-ci est simple à comprendre, même si elle présente un petit souci dès qu’on utilise des Web Fonts. En savoir plus.

Le LCP (Largest Contentful Paint) indique le moment où est rendu le plus grand élément de contenu réellement visible dans le viewport. C’est un indicateur dont l’objectif est de mesurer ce que ressent l’utilisateur du chargement visuel de la page, à l’instar du Speed Index.

Le nom du LCP est explicite, correspond à sa définition et l’indicateur est facile à collecter. Nous allons donc le croiser de plus en plus. Je lui préfère le Speed Index, qui s’intéresse à la progressivité du rendu de l’ensemble de la page mais c’est sans importance : sur la très grande majorité des pages, les deux indicateurs sont très fortement corrélés.

Cela permet néanmoins de savoir que si le Speed Index n’est pas disponible dans l’outil de votre choix, le LCP sera probablement une très bonne alternative pour répondre à la question :

Quand la personne utilisant le site a-t-elle l’impression que la page est suffisamment chargée pour être utilisée ?

Le FID (First Input Delay) est une mesure réalisée auprès de vrais utilisateurs et utilisatrices (Real User Metric, RUM). Elle correspond au délai d’attente subi lors de la première interaction avec la page, quel qu’en soit le moment.

Le FID est facile à comprendre mais comme toutes les mesures « réelles », il présente l’inconvénient d’être peu utilisable sans l’observer dans sa distribution. Dit autrement : un FID « moyen » ne porte pas d’information en soi. Un point bien abordé dans cet article, qui montre deux distributions avec des valeurs agrégées similaires. Pourtant, l’expérience est très différente.

C’est la force ET la faiblesse du RUM : être capable de retranscrire la diversité des usages, mais ne pas faciliter la prise de décision et accompagner le suivi. Tout l’inverse de l’analyse Synthétique. RUM et synthétiques sont donc complémentaires. Gilles vous en dira plus.

En synthétique, trois indicateurs d’interactivit pris ensemble peuvent pallier l’absence du FID : le Max Potential FID (le pire FID possible), et le Total Blocking Time (TBT) (qu’on peut résumer de manière inexacte mais simple comme la somme des temps de frustration potentiels pendant le chargement) et le Time to Interactive (qui est, comme son nom ne l’indique pas du tout, le moment du dernier ralentissement notable durant le chargement).

À défaut d’avoir la répartition du First Input Delay en synthétique, nous pourrons bientôt disposer de sa valeur potentielle maximale, de l’espérance d’une frustration en divisant le TBT par la durée de la période sur laquelle il est agrégé (entre le First Contentful Paint et le Time To Interactive) et du moment après lequel le FID est négligeable à nul (le Time To Interactive).

Enfin, les Core Web Vitals intègrent le Cumulative Layout Shift (CLS). Son algorithme s’intéresse au déplacement des éléments durant le chargement, afin de détecter les modifications visuelles susceptibles de tromper ou frustrer l’utilisateur parce qu’elles déplacent des éléments. Si l’intention derrière le CLS est géniale – et que des propriétés CSS commencent à apparaitre pour limiter ces mouvements (comme contain) – je pense que nous manquons collectivement de recul sur l’algorithme, et donc sur l’indicateur lui-même.

Des choses seraient à creuser sur sa sensibilité à l’orientation, son rapport aux interactions et aux animations. J’ai en tête des exemple de pages très désagréables en termes de déplacement d’éléments, mais qui auraient un bon CLS. Le sujet est très complexe. Je ne suis pas certain que l’algorithme soit suffisament complexe pour être pertinent dans un contexte de ranking.

Depuis, j’ai pris le temps de décortiquer l’indicateur et son algorithme pour en liver une analyse : « Cumulative Layout Shift, l’indicateur de stabilité de la mise en page ».


Je ne sais pas ce que l’avenir nous réserve, mais d’autres mesures existent déjà, notamment du côté de la surveillance du curseur des utilisateurs (agitation frustrée, clics frénétiques…). Il y a donc encore un gros potentiel concernant l’expérience utilisateur. Philip en parle très bien.

Mais concrètement, on cherche toujours les mêmes informations depuis des années. On veut que l’utilisateur ait l’impression que la page :

  1. est disponible ;
  2. commence à s’afficher rapidement ;
  3. affiche vite les informations pertinentes ;
  4. est utilisable, correctement, peu de temps après l’affichage du contenu pertinent.

En regardant uniquement le Premier Octet et le Speed Index, on observe déjà bien les 3 premiers jalons temporels. Si ces métriques sont mauvaises, s’intéresser à l’interactivité est parfois prématuré, notamment en termes de maturité de l’équipe d’optimisation. D’expérience, excessivement peu de sites parviennent à déjà contrôler les trois premiers points…

Mais alors pourquoi inventer de nouveaux indicateurs alors qu’on pourrait continuer avec des indicateurs existants et des indicateurs personnalisés ?

Tout simplement, pour rendre le domaine de la Performance Web plus vivant, pour l’intégrer toujours davantage dans l’Expérience Utilisateur et créer de nouvelles dynamiques. Concrètement, les équipes chargées d’optimiser la Performance Web vont pouvoir négocier de nouveaux budgets.

Si ce n’est pas votre cas, pas de panique. Les fondamentaux de la Performance Web sont solides, et n’ont pas changé avec ces nouveaux signaux. Ce n’est pas parce que vous voyez des publications sur la corrélation entre de bons Core Web Vitals et des taux d’abandons réduits que cette corrélation n’existait pas déjà avant, avec les outils et indicateurs que vous utilisez peut-être déjà au quotidien.

Le cap est donc le même. Si vous n’arriviez pas à mobiliser des compétences pour corriger vos problèmes existants, il y a fort à parier que ces nouveaux signaux ne vous faciliteront pas la tâche. Mais si vous alliez déjà dans la bonne direction, vous continuerez probablement.

Dans les deux cas, je serais ravi de vous accompagner sur un bout du chemin.

Comment optimiser les performance de vos parties tierces

Intégrer des librairies ou services existants de parties tierces permet de gagner en productivité, mais a souvent un coût sur la performance ressentie. Dès lors que vous intégrez du code externe, comment vous assurer que ce code ne viendra pas nuire au rendu et à l’interactivité de votre site ? Explications et propositions pour un code tiers plus performant.

Note : cet article a d’abord été publié sur le blog de Dareboost (abandonné).
Une course de natation en eau vive. Pas de couloirs, tous les participants se ruent en même temps vers l'arrivée, quitte à entrer en collision.

Si rien ne distingue vos ressources des ressources tierces, elles entrent en compétition.

Développer un projet Web Front-End, c’est répondre à un ensemble d’exigences métiers avec du code. Ce code, vous pouvez le produire vous-même ou déporter cette responsabilité vers des librairies ou services du marché ayant déjà fait leurs preuves.

Lorsque vous référencez une de ces librairies ou un de ces services depuis une page web plutôt que de l’intégrer à votre propre code, ni vous ni le navigateur de la personne visitant votre page Web n’avez aucun contrôle sur cette ressource, puisqu’elle est produite, maintenue et hébergée par un tiers. On parle alors de ressources en « Tierce Partie » (ou « 3p »).

Comment cela fonctionne-t-il ?

Référencer des parties tierces, en HTML, passe généralement par les balises <script> (permettant de charger et d’exécuter un script), <link> (qui référence des ressources ultérieurement nécessaires à la page) ou <iframe> (qui crée au sein de la page un tout autre contexte de navigation).

D’après l’Almanac Web 2019, 93 % des pages destinées aux ordinateurs de bureau comprennent au moins une ressource tierce et près de 76 % de ces pages émettent une requête vers un domaine de télémétrie (comme Google Analytics, par exemple).

Les parties tierces peuvent concerner des domaines très variés : publicité, télémétrie, aide à la relation client, intégration de réseaux sociaux, fonctionnalités marketing, gestion des utilisateurs, vidéos… Très souvent, les références à ces ressources sont réunies au sein d’un gestionnaire de tags, qui permet d’en centraliser la gestion et d’offrir un point d’entrée pour les discussions relatives aux parties tierces utilisées sur la page.

Avoir recours à des parties tierces augmente la productivité de vos équipes de développement (qui délèguent certaines fonctionnalités au tiers concerné). En contrepartie, cela augmentera votre coût opérationnel, puisqu’il faudra éventuellement s’acquitter d’une licence d’utilisation, et très certainement surveiller le bon fonctionnement de cette brique logicielle sur laquelle vous n’avez plus la main.

Sachez enfin que vous n’avez en général aucun droit à demander une modification du fonctionnement des ressources ou services tiers que vous utilisez : le fait que ces ressources soient utilisées par un très grand nombre de sites permet à son éditeur d’être à l’abri des influences individuelles.

Et au niveau performance ?

Souvent critiquées, les tierces parties ont un impact sur les performances de rendu et d’utilisation qu’il est pourtant important de nuancer. Si on prend, par exemple, les librairies JS les plus courantes, servies en tierces parties par des CDN : elles sont parmi les ressources les plus efficacement servies, avec une minification et une obfuscation efficaces, souvent couplée à des CDNs permettant une faible latence dans l’accès aux données. Bien que leur utilisation détériore souvent Start Render, cela est plus souvent dû au fait que ces scripts sont chargés de manière synchrone plutôt qu’à leur statut de parties tierces.

Le plus gros impact sur les performances vient des publicités et des scripts de réseaux sociaux dont le coût sur le réseau et la performance est rarement compensé par les fonctionnalités qu’ils apportent aux utilisateurs, à tout le moins pendant la phase de chargement initial de la page.

On pourra par exemple citer le cas du bouton « J’aime » de Facebook, dont on peut discuter l’intérêt mais qui, du point de vue de l’expérience utilisateur, n’est certainement pas utile avant d’avoir pris connaissance du contenu de la page. Il devrait donc naturellement être chargé en différé.

Une fois évaluée la pertinence de vos parties tierces et leurs modalités respectives de chargement, vous découvrirez certainement que le chargement de vos parties tierces peut être optimisé. Plusieurs cas de figure se présenteront.

Retarder une ressource ou un service chargé trop tôt

Il s’agit du cas où une tierce partie charge une ou plusieurs ressources avant que l’ensemble des éléments critiques de la page n’aient été affichés et rendus interactifs. On pourra citer, par exemple, le chargement de vidéos Youtube situées sous la ligne de flottaison, consommant la bande passante alors qu’elles ne sont pas visibles.

Dans ce cas, il faudra revoir la déclaration du <script>, <link> ou <iframe> permettant l’inclusion de la partie tierce dans le site, de manière à ce que cette inclusion soit plus tardive : soit par rapport à un évènement levé pendant le chargement d’autres ressources, soit par rapport à un événement lié à l’utilisation de la page par l’internaute (une problématique de Lazy-Loading déjà abordée pour le chargement des images).

Prioriser une ressource ou un service chargé trop tard

Si vous utilisez des parties tierces destinées à définir ou améliorer le design (polices d’écritures, scripts JS définissant des dimensions d’éléments dans la page), voire à récupérer une partie du contenu à afficher, vous souhaiterez en prioriser le téléchargement et l’utilisation. Or, très souvent, l’utilisation de ces ressources est ralentie par :

  • la résolution DNS de l’origine qui les héberge ;
  • la connexion à cette origine ;
  • le téléchargement de ces ressources.

Comment indiquer au navigateur le comportement à adopter pour optimiser leur chargement ? Jetez un œil à mon précédent article sur Preload et les Resource Hints !

Le cas des Googles Fonts

Dès qu’il s’agit de polices web, les Google Fonts sont prépondérantes : toujours d’après l’Almanac Web 2019 (chapitre « Polices »), au moins 74 % des requêtes de polices web proviennent de Google Fonts, et 29 % des pages contiennent un lien vers une feuille de style CSS Google Fonts.

Ce type d’appel présente un véritable risque, car le chargement d’une feuille de style CSS est synchrone. Le navigateur interrompt le rendu de la page pendant qu’il requête, télécharge et analyse le fichier CSS. L’appel constitue alors un Point Unique de Défaillance (en anglais, Single Point of Failure, SPOF) : si aucune réponse n’est apportée, alors la page reste figée. Il est très facile de simuler une défaillance de ce type avec Dareboost (en ciblant fonts.googleapis.com).

On pourrait penser qu’en raison des moyens déployés par Google, une défaillance de cette ampleur soit peu probable. Pour autant, personne n’est à l’abri d’un incident, et Google n’est qu’un maillon de la chaîne. Entre les incidents réseaux, les équilibrages autour de la neutralité du net, les erreurs de configuration de proxy nationaux ou d’entreprises, ce risque existe et se réalise parfois (n’hésitez pas consulter notre article sur les Single Point of Failure).

Pour éviter cela, vous pouvez utiliser des techniques de chargement asynchrone basées sur des altérations d’attributs ou des librairies JavaScript exposant le cycle de vie de vos polices.

Une optimisation plus simple est de télécharger les Google Fonts. Une fonctionnalité proposée nativement sur le site Google Fonts mais également disponible via l’outil Google Webfont Helper de Mario Ranfti qui vous aidera à générer le fichier CSS permettant de les déclarer.

En faisant cela, cependant, vous perdrez le bénéfice de la négociation de contenu de Google Fonts, détaillée dans cet article de Barry Pollard. En bref: Google Fonts optimise le fichier CSS qu’il délivre afin d’offrir les bons formats de polices et les jeux de caractères supportés par votre navigateur.

La meilleure solution est donc, à l’heure actuelle, d’utiliser un proxy de ressources. En apparence, il s’agit de sous-domaines vous appartenant qui sert les ressources tierces dont vous avez besoin. En réalité, il s’agit d’une web application qui procède à la récupération et la mise en cache des ressources sur des domaines externes, en filtrant les informations envoyées à ces domaines (transférant ce qui est pertinent pour la négociation de contenu mais pas ce qui relève de la vie privée des utilisateurs). Avec un tel outil, vous servez les polices depuis votre domaine, tout en bénéficiant de la négociation de contenu de Google Fonts. Cette technique, également disponible pour les JavaScript, est bien décrite dans cet article de l’équipe Tech de Décitre : « Limiter les dégâts du chargement d’un JS tiers ».

Cette technique, complexe, n’est pas à la portée de tout le monde. Une alternative est donc d’utiliser un mélange de preload (pour la feuille de style CSS) et de preconnect (au domaine servant les polices) pour bénéficier de la meilleur optimisation possible. Harry Roberts traite ce sujet en détail dans un article paru aujourd’hui-même : « The Fastest Google Fonts ».

Conclusion

Les ressources ou services en parties tierces apportent des fonctionnalités à votre site, mais la manière dont ils sont chargés peut nuire à l’expérience utilisateur. Pour optimiser leur chargement, commencez par déterminer les compromis à réaliser afin de donner à chaque élément considéré une priorité. Une fois ces priorités définies, alors vous pourrez retarder ou prioriser le chargement des parties tierces afin d’en tirer le meilleur profit, quitte parfois à les servir sur votre propre domaine, en direct ou via un proxy.

Preload, Prefetch et Preconnect : accélerez votre site avec les Resource Hints

Pour charger une page web complète, il faut un ensemble de ressources qui, collectivement, permettent l’affichage et l’interaction avec la page. Pour que l’utilisateur ait une impression de vitesse, il peut être nécessaire d’influencer l’ordre de récupération et d’exécution de ces ressources. C’est là que preload et les Resource Hints entrent en jeu.

Note : cet article a d’abord été publié sur le blog de Dareboost (abandonné).
Une course de natation

Besoin d’altérer les priorités définies par le navigateur ? Agissez avec précaution.

Une page web est composée d’un document principal, en HTML, et d’éventuelles ressources additionnelles permettant de la mettre en forme, ou de lui adjoindre des médias, ou des comportements. D’après l’Almanac Web 2019 (chapitre « Poids »), plus de la moitié des pages contiennent plus de 68 ressources qui s’additionnent au document principal.

Il n’est donc pas absurde de dire qu’en temps normal, télécharger une ressource est une tâche récurrente pour le navigateur. Cette tâche se décompose en plusieurs étapes, dont :

  • la résolution DNS de l’origine de la ressource
    (si nécessaire, c’est-à-dire si le navigateur ne l’a pas déjà faite) ;
  • la connexion au serveur de cette origine
    (si nécessaire, c’est-à-dire si le navigateur n’est pas déjà connecté) ;
  • le téléchargement de la ressource
    (si nécessaire, c’est-à-dire si la ressource n’est pas déjà dans le cache client et toujours valide) ;
  • et suivant le type de ressource et la raison de la requête, son éventuelle évaluation et utilisation.

Pour permettre au navigateur de télécharger de manière plus efficace les ressources, vous pouvez lui indiquer comment optimiser ces différentes étapes.

Vous pouvez même indiquer au navigateur de télécharger certaines ressources en amont, de manière à fluidifier de futures expériences de navigation sur votre site.

Définitions et usages

preload, dns-prefetch, preconnect, et prefetch sont les directives à utiliser pour influencer le chargement des ressources. Nous parlerons par la suite de « Resource Hints » pour l’ensemble de ces directives mais sachez que preload possède sa propre spécification, alors que les autres Resource Hints sont définis dans une spécification indépendante, notamment parce que preload n’est pas qu’une indication au navigateur, mais plutôt un ordre.

Pour écrire ces directives, vous pouvez utiliser soit la balise HTML <link>, soit l’en-tête HTTP Link. Comme pour spécifier le jeu de caractères, nous vous recommandons l’en-tête de réponse HTTP, puisqu’il sera pris en compte par le navigateur avant le début de l’interprétation du code HTML de la page.

Dans le corps de page HTML :

<link href="url-de-la-ressource" rel="directive" as="type-de-la-ressource" crossorigin="valeur" />

Via un en-tête HTTP :

Link: <url-de-la-ressource>; rel="prefetch"; as="type-de-la-ressource"; crossorigin="valeur"

Que vous choisissiez l’une ou l’autre des syntaxes, les paramètres à définir sont toujours les mêmes :

  • l’URL de la ressource, évidemment ;
  • la directive à utiliser ;
  • le type à considérer pour la ressource, ce qui permet de lui appliquer les Content-Security-Policy adaptées à sa nature (en savoir plus) ;
  • l’attribut crossorigin, sur lequel nous reviendrons un peu plus loin.

Ces paramètres vous permettent de définir 4 directives supportées par la plupart des navigateurs récents :

  • dns-prefetch : indique au navigateur qu’il pourrait réaliser la résolution du nom de domaine fourni (déterminant l’IP à contacter) avant que ce domaine ne soit utilisé pour télécharger des ressources ;
  • preconnect : indique au navigateur qu’il pourrait se connecter à l’origine fournie, avant que celle-ci ne soit utilisée pour télécharger des ressources. Cela implique, comme dns-prefetch, la résolution DNS, mais également l’établissement de la connexion TCP et la négociation TLS (si la page est en HTTPS) ;
  • prefetch : indique au navigateur qu’il pourrait télécharger une ressource donnée, même si elle n’est pas détectée dans la page. La priorité de ce téléchargement est alors faible ;
  • preload : indique au navigateur qu’il doit télécharger une certaine ressource au plus tôt, avec une haute priorité.

On retrouve des usages intéressant de dns-prefetch dans le cadre de l’utilisation de parties tierces critiques : en réalisant en amont la résolution du domaine, ce sont quelques millisecondes qui peuvent être économisées à moindre coût.
Cependant, dans la plupart des cas, il sera plus intéressant d’utiliser preconnect à la place de dns-prefetch, de manière à anticiper l’ensemble de la connexion.

Si votre site doit être compatible avec Internet Explorer, qui ne supporte pas preconnect, vous pouvez utiliser la syntaxe rel='preconnect dns-prefetch'.

Utilisez preload pour les ressources dont vous savez qu’elles seront utiles très tôt dans le chargement de la page mais qui ne seraient pas naturellement priorisées par le navigateur. preload est ainsi inutile pour les scripts synchrones présents dans votre <head>, qui sont déjà considérés par l’analyseur comme ayant une haute priorité. En revanche, il peut vous permettre d’augmenter la priorité d’exécution d’un script asynchrones situé dans le <head>. On utilise également preload pour charger des ressources référencées dans d’autre ressources (comme des polices d’écriture web, des images, ou d’autre feuilles de style référencées via @import) afin de les récupérer avant que le téléchargement et l’analyse de ces premières ressources ne soient terminés.

prefetch est une directive qui donne au téléchargement une très faible priorité, donc ne vous en servez pas pour déclarer des ressources essentielles. En revanche, il peut être très pertinent pour améliorer la navigation sur les pages suivantes. Un des meilleurs cas d’usage est d’utiliser prefetch lors de l’authentification, afin de profiter de la saisie des identifiant et mot de passe d’un internaute pour précharger les ressources statiques nécessaires au rendu de la page qu’il ou elle visualisera une fois authentifié.

L’attribut crossorigin

L’attribut crossorigin, facultatif, est utilisé lors du téléchargement de ressources issues d’origines différentes de l’origine principale (CORS). Pour de nombreuses ressources (comme les CSS, ou les images), il n’est pas utile de le préciser, sauf à souhaiter requêter ces ressources en passant des en-têtes d’authentification, des cookies, etc. (on utilise alors la valeur use-credentials).

Pour d’autres types de ressources, définies dans des spécifications plus récentes, crossorigin doit être explicité. C’est le cas, par exemple, pour les polices de caractères (voir la spécification), y compris quand elles proviennent du domaine principal.

Attention aux implications : par exemple, si vous utilisez preconnect sur un domaine tiers sur lequel vous récupérez des images et des polices, dupliquez la déclaration de manière à créer deux connexions : une sans crossorigin (qui servira pour les images) et l’autre avec (qui servira pour les polices).

À consommer avec modération

À la lecture de cet article, vous pourriez penser qu’il est pertinent de déclarer de très nombreux Resource Hints pour que le navigateur charge la page au plus vite. Il n’en est rien.

Puisqu’il définit une priorité de chargement faible, vous pouvez utiliser prefetch sans réel impact sur le chargement immédiat de la page. Attention cependant : son usage augmentera la consommation de données sur votre site, ce qui peut être un problème pour vous (augmentation du trafic sur votre serveur) et pour vos visiteurs (surconsommation inutile de ressources).

Utilisez preload avec parcimonie, car il prend le pas sur les priorités définies par l’analyseur du navigateur, aussi bien en terme de téléchargement que d’exécution. Par exemple, imaginez que vous avez un script async dans votre <head>. Grâce à l’attribut async, sa priorité de téléchargement est faible. Cependant, une fois téléchargé, comme tout script non-différé, son analyse et son exécution interrompent le fil d’exécution principal (vous devez utiliser l’attribut defer pour éviter ça). Si vous ajoutez une directive preload qui concerne cette ressource, le navigateur la récupérera plus rapidement, donc l’analysera et l’exécutera plus rapidement. Le fil d’exécution sera interrompu très tôt dans le chargement de la page,, annulant l’effet retardataire de votre attribut async.

Même si le coût d’un preconnect est faible, il n’est pas nul. Si la connexion ainsi ouverte n’est pas utilisée rapidement, alors le preconnect aura engendré un surcoût de consommation CPU (côté client comme serveur) et de compétition réseau inutile.

[…] utilisez-la à bon escient : chaque socket ouvert entraîne des coûts à la fois sur le client et sur le serveur, et vous voulez éviter d’ouvrir des sockets qui pourraient rester inutilisées. Comme toujours, faites-le, mesurez l’impact dans le monde réel et itérez pour obtenir le meilleur gain de performance possible. « Eliminating Roundtrips with Preconnect [EN] », Ilya Grigorik, traduit de l’anglais.

Un conseil datant de 2015 mais toujours d’actualité, notamment dans le cas de connexions à des origines sécurisées, dont la validation des certificats ajoute de la charge CPU et réseau.

On retrouve le même genre de recommandations chez Ivan Akulov, qui conseille même de basculer vers dns-prefetch, dont le coût est plus faible, si plus de 4 à 6 domaines sont concernés.

Vous l’aurez compris, un grand pouvoir implique de grandes responsabilités. Si vous souhaitez prendre la main sur les priorités attribuées nativement par le navigateur, alors vous devez le faire de manière modérée et responsable, afin d’éviter de reproduire des engorgements réseau et des consommations CPU desservant vos utilisateurs. Cela peut s’avérer très payant, notamment pour optimiser les services tiers (comme vos analytics ou vos polices d’écriture web). Comme de nombreux sujets relatifs à la performance web : testez, mesurez et itérez !

Trackers sur votre domaine, chiffre d’affaire en danger

Dans le Web, des actualités qui peuvent n’avoir rien à voir en apparence peuvent, en réalité, être très liées. Là où la loi ne suffit pas toujours, le portefeuille finit souvent par l’emporter.

Des trackers en 1st party

Collecter un maximum de données (et surtout bien les collecter) est un des enjeux principaux pour l’ensemble des marques. Néanmoins, face à la croissance du taux d’adblocking, à la mise en application du Règlement Général sur la Protection des Données (RGPD) et ainsi au fossé toujours plus important se creusant entre le traitement des différents types de cookies, des questions sont réellement à se poser.

Comment réussir à ne pas ressentir l’impact de ces éléments sur sa collecte et donc sur sa stratégie data-driven ? Comment préserver la quantité et la qualité de ses données ? Et si, à cause de ces éléments, votre Tag Management System (TMS) ne se déclenchait pas ? Vous êtes-vous posé la question du 1st party ?

Voici l’introduction qu’on peut trouver sur la page « Comment éviter de passer à côté de données avec l’arrivée du RGPD » d’Eulerian, une des solutions phares de recoupement de données de surveillance d’internautes.

Si vous n’avez pas compris le discours, il s’agit simplement de se demander comment contourner l’absence de consentement des internautes (voire l’expression claire de leur non-consentement quand elles et ils installent des adblockers) pour collecter des données malgré tout. La « solution » proposée : cacher les saletés sous le tapis en les masquant dans un sous-domaine appartenant à la marque.

Par exemple, au lieu d’envoyer des données à mon_domaine.eulerian.net, l’organisation les envoie vers 43bdf.mon_domaine.com puis s’assure que 43bdf.mon_domaine.com pointe bien vers mon_domaine.eulerian.net.

Le nombre de problèmes éthiques soulevés par cette pratique est important, mais elle pose aussi des problèmes de sécurité puisque, mal implémentée, elle peut transmettre des données de sessions à un tiers, permettant une usurpation de la session utilisateur, le vol de données critiques ou le défaçage de la plate-forme. Un risque que les prestataires se gardent bien de mettre en avant.

Un badge « Page lente » sur Chrome ?

Google a annoncé le déploiement d’initiatives du type « badge de la honte », pénalisant les sites lents. L’idée d’un signalement de ce type, des expérimentations avaient déjà été menées en 2015. Des badges « Slow To Load » et « Red Slow Label » avaient été affichés sur des résultats de recherche. Cette fois, Google annonce démarrer des expérimentations au niveau de Chrome.

Captures d'écran mobiles

Exemple d’expérimentation qui pourrait être menée : dans le cadre du chargement d’une page mobile lente, la barre de chargement serait bleue et l’écran de chargement afficherait un badge d’avertissement. Dans le cadre du chargement d’une page potentiellement rapide, la barre serait verte.

Depuis la fin des années 2000, Google multiplie les initiatives autour de la Performance Web. Depuis 2017, j’ai néanmoins l’impression d’une accélération, sûrement dûe à la volonté d’indexer plus fidèlement le Web en utilisant des sondes toujours équipées de la dernière version de Chrome et exécutant JavaScript. Une tendance pour laquelle de nouveaux indicateurs ont même été créés, comme le Time To (Consistently) Interactive qui, à défaut d’être un bon indicateur d’UX, est un excellent indicateur de fin de chargement pour un robot.

Si la loi ne convainc pas, le portefeuille le fera

Si vous travaillez dans une organisation qui envisage de masquer des parties tierces dans un domaine en 1st Party, je vous encourage à ne pas le faire, pour des raisons éthiques et de sécurité.

Si cela ne vous suffit pas, sachez que vous perdrez rapidement des utilisateurs et utilisatrices averties qui sauront s’équiper de solutions détectant ces scripts malgré vos manipulations, et refuseront de cautionner ces usages.

Si cela ne vous convainc toujours pas, je vous encourage à la surveillance minutieuse de votre Performance Web. Si, ces parties tierces venaient à répondre de manière lente, alors cela pourrait ralentir la perception que Google a de l’ensemble de votre domaine, et provoquer l’affichage d’un badge « page lente ».

Nous savons déjà que la dégradation de la Performance Web a un impact sur le ranking. Avec les expérimentations de Chrome, elle aura un impact explicite sur les visites de l’ensemble de votre domaine. On ne parle plus ici de personnes qui penseront que, temporairement, le réseau leur fait défaut, mais de personnes qui seront averties par Google que votre site est lent, et partiront.

Vous voulez vraiment prendre ce risque ?

Custom Timing : attendez la prochaine frame
quand vous utilisez la User Timing API

Les indicateurs habituels de performance web (Premier Octet, Speed Index…) sont très intéressants mais j’ai souvent besoin d’ajouter des marqueurs temporels personnalisés, basés sur des événements qui ont un sens du point de vue métier.

  • le moment où un contenu (ou une fonctionnalité) spécifique est disponible pour les utilisateurs
  • le début et la fin de l’affichage d’une animation de chargement (très utile dans les tunnels complexe)
  • dans une page découpée en composants récupérant leur contenu dans une API, les temps d’affichage spécifiques de chaque composant
  • …

J’utilise la User Timing API (voir sur MDN [EN]) pour insérer des timings dans la performance timeline du navigateur. Comme on peut récupérer tous ces indicateurs dans Dareboost ou Contentsquare Speed Analysis, je peux ensuite surveiller leur évolution sur la durée.

Deux courbes dans un graphique. Sur l'axe des abscisses, une période d'un mois. Sur l'axe des Y, le temps entre 0 et 3 s. La courbe orange indique la valeur du marqueur "mark_declare_js_end" tandis que la courbe verte correspond au marqueur "mark_switchlang_end".

Quelques Custom Timings issus de ce site

En utilisant l’API avec JavaScript, poser un marqueur est assez simple (et bien supporté).
Par exemple :

// Le truc dont vous voulez mesurer l'occurence
document.getElementById('content').classList.add('blue');
// Le marqueur temporel
performance.mark('mark-blue');

Vous pouvez ensuite récupérer la valeur dans les outils de développement de votre navigateur, en utilisant :

performance.getEntriesByType('mark');

Cependant, j’ai récemment1 réalisé quelque chose d’important. Le simple fait que le navigateur exécute du code JavaScript ne signifie pas que l’utilisateur puisse voir les résultats de cette exécution. Le navigateur doit, entre temps, mettre à jour l’affichage. Or, sa capacité à le faire dépend du code JavaScript qui suit le morceau de code qui nous intéresse…

Dans l’exemple suivant, j’injecte une boucle bloquante d’une seconde après mon timing de performance, ce qui bloque le rendu par le navigateur.

// Le truc dont vous voulez mesurer l'occurence
document.getElementById('content').classList.add('blue');
// The timestamp
performance.mark('mark-blue-sync');

// Un bout de code qui coûte des ressources au navigateur
// pendant 1 seconde
let n = performance.now();
while (performance.now() - n < 1000) {}

Bien sûr, dans la vraie vie, vous n’aurez pas une simple boucle. Vous aurez d’autres tâches qui prendront peut-être beaucoup de temps, ou peut-être pas. Vous ne pouvez pas le savoir et, même, vous ne pouvez pas le tester, car tout cela dépend du contexte client que vous ne contrôlez pas.

Pour contourner ce problème, nous pouvons utiliser requestAnimationFrame() afin de demander au navigateur de poser notre timing juste avant le prochain rendu (la prochaine frame) :

// Le truc dont vous voulez mesurer l'occurence
document.getElementById('content').classList.add('blue');
performance.mark('mark-blue-sync');
// Le Custom Timing, avant la prochaine frame
window.requestAnimationFrame(() => {
    performance.mark('mark-blue-frame');
});

// Un bout de code qui coûte des ressources au navigateur
// pendant 1 seconde
let n = performance.now();
while (performance.now() - n < 1000) {}

Si vous voulez voir comment ça fonctionne par vous-même, voici une page de test.

EN UN MOT
Utilisez l’API User Timings pour créer des Custom Timings liés à votre activité.

Encapsulez-les dans des callbacks requestAnimationFrame() pour comprendre le comportement de l’interface, plutôt que l’exécution du code.

Si vous voulez avoir une idée de la latence de l’affichage, attachez deux marques : l’une après l’événement à suivre, l’autre dans un callback requestAnimationFrame().

  1. En lisant « Performance metrics for blazingly fast web apps » [EN], de Conrad Irwin ↩

Mesurer l’interactivité avec le TTI
Time To (consistently) Interactive

L’objectif de la mesure de la Performance Web est de déterminer le moment à partir duquel une personne visitant la page peut accomplir son objectif efficacement. Cela implique qu’elle puisse consulter le contenu qu’elle cherchait et qu’elle soit en mesure d’interagir avec la page de manière satisfaisante. Certains indicateurs mesurent les étapes du rendu par le navigateur, d’autre la progression de ce rendu par le biais de vidéos. Mais quand il s’agit de mesurer efficacement l’interactivité, le mystère reste entier.

Depuis quelques années maintenant, Google met en avant un indicateur ambigu : le Time To Interactive. De quoi s’agit-il ? C’est ce que nous allons définir, avant d’expliquer comment et quand l’utiliser (ou non).

Note : cet article a d’abord été publié sur le blog de Dareboost (abandonné).
 Photo d'un manège qui tourne. Le mouvement de rotation créé un effet de flou : il est impossible de déterminer avec certitude la vitesse du manège.

Mesurer l’interactivité, c’est comme monter sur un manège en marche. Quand peut-on considérer que le manège a suffisamment ralenti pour qu’on puisse monter dessus. Il n’y a pas de réponse précise.

Synthèse

La mesure de l’interactivité est un véritable défi pour les experts de la Performance Web. Les éditeurs de solutions de monitoring synthétique, en particulier, rencontrent des difficultés puisque leurs solutions ne reposent pas sur des interactions d’utilisateurs.

Le Time To Interactive de Google est un indicateur sophistiqué, construit pour déterminer les conditions idéales d’interaction en surveillant à la fois l’activité du fil d’exécution principal de JavaScript et l’activité réseau. Il permet de déterminer avec efficacité un moment à partir duquel on peut être sûr qu’une interaction pourra avoir lieu de manière fluide.

Néanmoins, le Time To Interactive est un indicateur dont la construction est compliquée à comprendre et à exploiter, et qui ne mesure pas ce que la plupart des gens pensent qu’il mesure : le moment à partir duquel une page devient interactive.

La seule manière de capturer des actions utilisateurs est d’en disposer, donc d’utiliser du Real User Monitoring (RUM). Mais même là, il n’existe pas un unique KPI qui décrit simplement la relation entre le comportement des utilisateurs et l’interactivité de la page dans le temps.


En quête d’un nouvel indicateur

Qu’essayons-nous de mesurer ?

Accéder à une page web est une expérience que le monde de la performance web décrit généralement comme étant composée de 4 « moments » :

  1. L’utilisateur a la confirmation que le chargement a commencé.
  2. L’utilisateur dispose de suffisamment d’informations pour penser qu’il peut interagir avec la page.
  3. L’utilisateur peut interagir avec la page (ce moment particulier étant dépendant du type d’interaction effectuée).
  4. L’interaction de l’utilisateur avec la page est sans effort et intuitive, sans délai et sans agitation.

Plusieurs signaux peuvent indiquer à l’utilisateur que le chargement a commencé : la mise-à-jour du titre et de l’URL, une éventuelle animation de l’onglet ou du favicon, l’apparition des premiers pixels non blancs, puis du reste de la page…

Pour estimer la perception visuelle des visiteurs, on peut utiliser le Speed Index et le First Contentful Paint, deux indicateurs qui aident à comprendre la manière dont un utilisateur perçoit le chargement de la page. Comme leurs modes de calcul sont liés à la manière dont les éléments sont affichés, leurs limitations peuvent être identifiées en un clin d’œil par un être humain.

En revanche, lorsqu’il s’agit de mesurer l’interactivité – les points 3 et 4 – ça devient plus difficile. Nous ne savons pas vraiment comment la mesurer. La seule chose que nous savons bien faire est de recueillir des informations qui nous permettent de déduire ces moments particuliers.

Par exemple, Akamai cherche depuis des années de nouvelles manières de mesurer l’activité des utilisateurs. Ils s’appuient sur la bibliothèque Boomerang, créée par Philip Tellis qui est venu à We Love Speed 2018 pour présenter de nouvelles mesures d’UX. Ces nouveaux indicateurs permettent de mesurer la réactivité des pages : clics « de rage », clics manqués, clics morts et secouage du curseur. En analysant la distribution de ces données qui expriment toutes la frustration de l’utilisateur, nous pouvons approximativement déduire le moment où l’utilisateur s’attend à ce que la page, ou un composant particulier, soit interactive.

 Clics de rage en fonction de la Première Interaction et du Visuellement Complet : il y a une corrélation linéaire nette ; la pente varie entre 1.2 and 1.5.

Il y a une corrélation linéaire évidente entre les clics "de rage" et les clics situés 1,2 à 1,5 fois après le Visually Ready (le moment où l’utilisateur perçoit que la page est prête pour une interaction – voir la définition complète sur la documentation Boomerang).

Ce type de corrélation nécessite de grandes quantités de données collectées auprès d’utilisateurs réels, soit par le biais de bibliothèques JavaScript comme Boomerang, soit via du RUM intégré au navigateur comme le Chrome UX Report. Ces données ne peuvent être collectées que sur des environnements de Production accueillant un grand nombre de visites.

Tester des optimisations dans un environnement de ce type est risqué. Sans tests préalables, le déploiement en Production peut entraîner des régressions et/ ou des ralentissements, et nuire à votre entreprise. De plus, vous devrez attendre d’avoir recueilli un volume de données suffisamment important avant de pouvoir déduire quoi que ce soit. Et même là, il sera difficile d’évaluer ce jeu de données, car les données RUM ne sont pas si faciles à analyser.

Les solutions de surveillance synthétique, elles, peuvent effectuer des mesures de performance précises sur tous les environnements, tout en contrôlant les contextes de test. Et elles seraient encore plus utiles si elles pouvaient fournir une mesure de l’interactivité.

Mais comme elles n’impliquent pas de vrais utilisateurs, les solutions de mesure synthétique sont obligées de ruser…

Arrive le Time To (Consistently) Interactive

NOTE
Bien qu’il en existe plusieurs définitions, nous nous concentrerons sur la définition proposée par Google par le biais de ses outils et sites Web.

L’interactivité peut être envisagée de deux manières : soit comme un passage entre deux états (non interactif et interactif), soit comme un continuum. Savoir quand une page devient interactive pour la première fois est intéressant mais si l’interface ne répond pas rapidement, l’UX ne sera pas très qualitative. Quand nous parlons « d’interactivité », nous considérons donc à la fois le fait que la page est interactive et le fait que les interactions aient eu lieu de manière satisfaisante.

Le Time To Interactive, anciennement connu sous le nom de « Time To Consistently Interactive », est un indicateur synthétique expérimental qui tente de mesurer quand votre application web est à la fois rendue visuellement et interactive.

 Superposition de plusieurs photos d'un danseur en mouvement. Chaque mouvement est capturé et pourtant il est impossible de saisir le continuum sur une image statique.

Comme les choses en mouvement sont difficiles à appréhender, nous nous appuyons souvent sur des approximations et des modèles.

Le TTI est une mesure de l’interactivité qui ne repose pas sur les interactions réelles des utilisateurs. L’algorithme fait plutôt une approximation en considérant qu’une interaction satisfaisante ne peut se produire que dans des conditions spécifiques et s’intéresse à déterminer la survenue de ces conditions.
Pour déterminer le TTI, l’algorithme avance le long de la ligne de temps, effectue des vérifications et redéfinit son estimation du TTI jusqu’à ce qu’il trouve un moment où toutes les conditions sont remplies. Il choisit d’abord, comme limite inférieure, le moment où l’utilisateur estime que le contenu primaire de la page est visible. Plusieurs indicateurs sont disponibles pour cela : le « Time To Interactive Explainer » parle du First Meaningful Paint, mais on peut également utiliser le First Contentful Paint, comme le fait WebPageTest.

Ensuite, l’algorithme du TTI vérifie que le navigateur est disponible, en mesure de prendre en compte l’interaction. La plupart des actions sont gérées côté client par du code JavaScript tournant dans un unique fil d’exécution, donc l’algorithme doit ensuite s’assurer qu’aucune tâche JavaScript de longue durée n’occupe actuellement ce fil (thread, en anglais), ce qui empêcherait le JS de gérer les entrées utilisateur immédiatement. Pour le W3C, une tâche est « longue » (Long Task) si elle dure plus de 50 ms. Par la suite, l’algorithme cherchera une fenêtre de 5 secondes sans Long Tasks.

Si le code JS nécessaire pour gérer l’interaction n’est pas encore téléchargé, tout ceci est inutile. Plutôt que d’observer finement chaque réponse HTTP pour savoir si les ressources JavaScript sont téléchargées, l’algorithme du Time To Interactive va se servir d’un signal : il va attendre une période d’au moins 5 secondes pendant laquelle il n’observe pas plus de 2 ressources (tous types confondus) chargées en parallèle.

Si l’une des conditions (Long Task et Réseau) n’est pas remplie, l’algorithme fait avancer son estimation du TTI et reprend l’observation pour trouver une autre Long Task et une autre fenêtre de faible activité réseau de 5 secondes après la dernière Long Task observée. À ce stade, l’estimation du TTI correspond à la fin de la dernière Longue Tâche observée.

Mais nous n’avons pas fini ! L’algorithme ne considère pas qu’une page est interactive avant que le navigateur n’ait fini d’analyser le document donc si l’événement DOMContentLoadedEnd se produit après cette estimation, ce moment est choisi comme valeur définitive du Time To Interactive.

 A graph summarizing the above explanations.
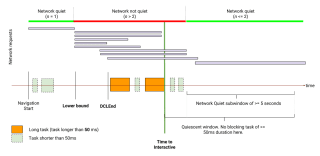
Schéma de principe de la définition, dans le "Time To Interactive Explainer".

Comment utiliser le TTI ?

Un des premiers indicateurs que l’on découvre quand on s’intéresse aux performances d’affichage est le Visuellement Complet, c’est-à-dire le moment où le rendu de la zone visible de la page est terminé.

Le Time To Interactive est comme le Visuellement Complet : un marqueur de la fin de quelque chose. Mais la question est « de quoi ? ». Tim Dresser a probablement trouvé la meilleure manière de l’exprimer « a ‘no jank past this point’ metric ». Cela signifie que le Time To Interactive détermine un moment à partir duquel nous avons la certitude que les interactions seront fluides. C’est évidemment quelque chose qu’il est important de surveiller et d’optimiser ou, du moins, ne pas détériorer sans avoir de bonnes raisons.

En effet, le TTI est calculé à partir de l’observation indirecte du CPU – par le biais des Long Tasks JS – et de l’activité réseau. Si le TTI augmente, cela implique qu’une Long Task JS s’est produite plus tardivement qu’avant, pendant le chargement de la page, et qu’il est important de savoir pourquoi. Une nouvelle Long Task a-t-elle été introduite ? S’agit-il d’une tâche déjà connue, repoussée par une modification apportée au code ? Est-ce une conséquence d’une dépendance tierce récemment implémentée ?

Comme nous le démontrerons plus loin dans l’article, cette Long Task n’est pas nécessairement nuisible à votre UX (par exemple, si vous différez vos scripts, alors les Long Task qu’ils ont produites se produiront plus tard) mais vous pouvez certainement optimiser pour vous assurer qu’elle ne se produise pas (par exemple, vous pouvez déléguer des algorithmes JavaScript complexes aux Web Workers, les faisant exécuter en tâche de fond sans occuper le thread principal JavaScript).

Quelques malentendus fréquents concernant le Time To Interactive

Le Time To Interactive n’est pas le temps qui s’écoule avant qu’une page soit interactive.

« Time To Interactive » est un nom vraiment ambigu.

Même dans la documentation de Lighthouse, vous pouvez lire de courtes définitions trompeuses comme :

Le paramètre Time to Interactive (TTI) mesure le temps qu’il faut à une page pour devenir interactive.

Heureusement, la phrase est suivie d’une définition de ce qu’on entend ici par « interactif », mais pour quelqu’un qui ne lirait pas davantage, le mal est fait.

Parce qu’en réalité, le Time To Interactive ne mesure pas le temps qu’il faut pour qu’une page devienne interactive, il mesure le temps qu’il faut pour s’assurer que toutes les conditions soient réunies, pendant au moins 5 secondes, pour qu’une interaction puisse se produire de manière satisfaisante. C’est pourquoi la mesure était auparavant connue sous le nom de Time To Consistently Interactive.

Il est totalement possible d’avoir une page très rapide et utilisable qui, malgré cela, a un TTI important. Il suffit que la page exécute des Long Tasks de courtes durées (la plus courte possible), à un rythme suffisant pour interrompre la fenêtre d’observation du TTI. Cette page, par exemple, exécute une tâche de 51 ms toutes les 2 secondes, pendant un total de 20 secondes et son TTI est supérieur à 19 secondes.

Néanmoins, la page est parfaitement interactive bien avant que le TTI ne le suggère.

Dans l’algorithme du TTI, la sous-fenêtre de « silence réseau » n’est qu’un signal

Le Time To Interactive est toujours lié à la dernière Long Task JS. L’heuristique « activité réseau réduite » n’est qu’un signal. J’ai vu des gens demander s’ils avaient besoin d’améliorer leur Waterfall pour qu’elle contienne moins de deux requêtes simultanées à chaque instant. Si aucune de ces requêtes n’engendre une Long Task, pas d’inquiétude, votre TTI ne souffrira pas.

Cependant, comme il ne s’agit que d’un signal, cet algorithme ne garantit pas que le code JS requis pour gérer l’interaction soit vraiment disponible. Vous pouvez avoir un Time To Interactive très correct et pourtant une page qui n’est pas du tout interactive – du moins de la manière dont l’utilisateur s’y attend.

Le TTI de Google n’est pas le même que celui des autres

Chaque fois que Google introduit un nouveau concept, il y a une forte demande du marché. Mais attention, le Time To Interactive n’est pas un standard !

Akamai Boomerang, l’une des solutions de Real User Monitoring les plus célèbres, a sa propre définition du Time To Interactive, qui diffère fortement de celle de Google. Ils utilisent divers signaux comme le Frame Rate, les Long Tasks, la disponibilité de la page (« Page Busyness », mesuré via des setInterval) et les délais mesurés dans les interactions utilisateur. Même s’ils conservent la définition à 50 ms d’une Long Task (comme le W3C), leur fenêtre d’observation n’est que de 500 ms (au lieu de 5 secondes), ce qui empêche les valeurs de Time To Interactive de se disperser en raison de tâches isolées.

Des solutions de Monitoring Synthétique prétendent supporter l’indicateur de Time To Interactive mais, comme pour le temps de chargement, il faut toujours vérifier leur définition. Au cours de mes recherches, j’ai constaté que certaines d’entre elles n’hésitent pas à apposer une étiquette « TTI » sur d’autres indicateurs (comme l’événement domInteractive), qui n’ont rien à voir.

Le Time to Interactive manque de stabilité

Un indicateur qui n’est pas prévisible est difficile à comprendre. En faisant des recherches pour cet article, nous avons rassemblé ces éléments qui suggèrent que le TTI est l’une de ces mesures dont la nature complexe le rend difficile à stabiliser.

Je l’ai essayé et c’était un indicateur trop instable pour mesurer Wikipedia. En voici un exemple : https://phabricator.wikimedia.org/T176369

Peter Hedenskog, ingénieur logiciel pour la Fondation Wikimedia

Nous avons peu de retours d’expérience sur le TTI

Il y a peu de données concernant sur la corrélation des mesures du TTI et ce qui est observé chez les utilisateurs, en tout cas aucune qui n’indique que l’indicateur soit plus intéressant que les existants.

Basé sur une première étude de Deepanjan Roy (une scoresheet concernant 28 sites Web), le Time To Interactive a par la suite été qualifié par Tim Dresser, sans grand succès. Pour être honnête, ces corrélations sont très difficiles à obtenir : comme nous pouvons le voir dans l’analyse de Tim, même sur des indicateurs plus stables comme le FCP, la corrélation entre les données de terrain et de tests n’est pas bonne.

J’ai trouvé une étude de 2017, de Nic Jansma, citée récemment par Addy Osmani, où il explique que l’amélioration du TTI a un impact réel sur le taux de conversion dans un cas d’utilisation réel. Malheureusement, les diapositives ne donnent pas accès aux données ni aux conditions expérimentales.

D’autres cas d’utilisation, disponibles en ligne, consistent souvent à supprimer tout le JavaScript des Landing Pages. Une modification assez drastique, là où d’autres solutions (comme le téléchargement et le byte-caching du JS dans un Service Worker pour une utilisation future) auraient pu être préférables. Ne vous méprenez pas, je suis toujours partant pour réduire le JavaScript au maximum, mais jamais au détriment du parcours utilisateur.

Le Time To Interactive intervient dans un paysage de la Performance Web qui offre déjà de multiples indicateurs, dont certaines sont plus faciles à comprendre et à commenter. La plupart des cas d’utilisation que j’ai lus sur le Time To Interactive ne précisent pas si les indicateurs existants étaient suffisants pour qualifier la situation. Or la plupart des propriétaires de sites ne veillent que sur 3 ou 4 indicateurs de performance Web. Avant de leur demander de laisser tomber l’un d’entre eux pour celui-ci, je pense qu’il est important qu’ils puissent se faire une idée détaillée de leur pertinence respective.

La définition d’une Long Task à 50ms crée un effet de seuil

Les seuils du Time To Interactive ont le mérite de sensibiliser à l’importance des budgets de performance. En effet, le TTI est un budget de performance en lui-même : « L’indisponibilité du fil d’exécution principal ne doit jamais dépasser 50 ms ».

Toutefois, à chaque fois qu’on définit un seuil, cela a un impact.

 Capture de WebPageTest. L'évaluation du "Page Interactive" est verte très tôt dans la page, mais perturbée par une partie rouge beaucoup plus tard dans le chargement.

Prenons une page de blog très simple, et testons-la sur avec WebPageTest en Desktop. La page est visuellement prête et complètement interactive dès 1,2 secondes. À ce moment et pendant quelques secondes, un visiteur peut lire et faire défiler la page librement. À environ 3,5 secondes, une exécution de script reCaptcha crée une Long Task de 150 ms (en rouge, sur la barre inférieure) qui décale le Time To Interactive. Cette exécution serait-t-elle perçue par un visiteur qui interagirait avec la page à ce moment précis ? D’ailleurs, combien de temps faudrait-il pour qu’un visiteur ressente un délai ?

According to the RAIL performance model (Response, Animation, Idle, Load), the user perception of performance delays depends on the nature of the delay. Interaction delays are perceived after ~100ms. A value consistent with Nielsen’s 1993 post, based on Miller & Card et al. studies.

Mais si un délai n’est remarqué quà partir de 100 ms, pourquoi considérer une tâche JS longue à partir de 50 ms ? L’explication se trouve dans la spécification Long Task API :

Le modèle de performance RAIL suggère que les applications doivent répondre en moins de 100 ms à une sollicitation utilisateur (pour le touch tactile et le défilement, en moins de 16 ms). Notre but avec cette API est de faire apparaître des notifications sur les tâches qui peuvent empêcher l’application d’atteindre ces objectifs. Nous mettons en valeur les tâches qui prennent 50 ms ou plus. Un site Web qui n’a pas de tâches de ce type devrait répondre aux sollicitations des utilisateurs en moins de 100 ms : il faudra moins de 50 ms pour terminer la tâche en cours d’exécution lorsque l’action utilisateur sera reçue et moins de 50 ms pour exécuter la tâche qui réagit à cette sollicitation.

Long Task API 1, traduction

En d’autres termes : la gestion d’une interaction nécessite à la fois que le navigateur soit capable de gérer l’entrée utilisateur en n’étant pas déjà occupé (interactivité) et qu’il puisse traiter l’exécution potentielle du code JS déclenché par cette action de manière rapide (réactivité). Comme nous ne connaissons pas le temps de réponse réel du navigateur pour exécuter le traitement déclenché, nous considérons que ce temps devrait être inférieur à 50 ms. Cela laisse 50 ms pour que le navigateur ait le temps de réagir.

En réalité, tous les navigateurs et les contextes de navigation sont différents et de nombreux facteurs peuvent influer sur le temps pris par le navigateur pour traiter une tâche.

Mesure de l’interactivité : le TTI suffit-il ?

Le TTI comme nouvel indicateur de référence ?

Créer et promouvoir un indicateur est un acte performatif, surtout lorsque cet indicateur est défini comme LA référence pour l’interactivité : mis en avant par Google, il ne se contente pas d’évaluer le Web, il le modèle. Les experts SEO/SEM s’empressent de le recommander à leurs clients, des entreprises l’utilisent dans des classements. Rapidement, tout le monde considère l’indicateur comme une référence, sans remettre en cause sa logique interne.

Cependant, ses nombreuses limitations, toutes cohérentes avec sa définition basée sur de nombreuses approximations, font du TTI un indicateur plutôt binaire. Soit votre TTI est très bas et vous pouvez être heureux parce que vous êtes absolument certain que la page web offre les meilleures conditions pour des interactions de qualité ; soit ce n’est pas le cas, et vous devez enquêter en profondeur pour savoir ce qui se passe car il est possible que certaines Long Task retardent le TTI sans déranger les utilisateurs mais la page peut tout aussi bien être inutilisable. Le TTI ne vous donne pas les outils pour distinguer ces deux possibilités sans faire de recherches approfondies.

 Un microscropt zoomant sur un échantillon.

Un mauvais TTI est un signe que toutes les conditions ne sont pas parfaites pour l’interactivité. Cela ne signifie pas que les interactions seront forcément dégradées. Une analyse approfondie est toujours nécessaire.

Un jalon plus qu’une évaluation d’un continuum

Le Time To Interactive est à l’interactivité ce que le Visuellement Complet est à l’affichage : un jalon final. Ce qui nous manque, c’est « Speed Index des interactions » où, pour déduire la frustration de l’utilisateur, chaque Long Task serait pondérée par sa durée et le moment où elle se produit, en relation avec d’autres indicateurs (par exemple, les indicateurs de rendu).

Nic Jansma, dans l’étude mentionnée précédemment, a observé la distribution des durées des Long Tasks et a trouvé une corrélation avec la conversion. J’espère que nous progresserons sur ce point dans les années à venir.

 Temps de la première LongTask vs. Taux de conversion (gauche) ; Temps de la première LongTask vs. Durée de session (droite)

L’étude de Nic n’a pas observé de diminution de la conversion tant que les Long Task de la première page étaient plus courtes que… 100 ms (et pas 50 ms). Intéressant, non ?

En attendant, il existe beaucoup d’autres mesures concernant l’interactivité, principalement en RUM où l’activité réelle des utilisateurs peut être observée. Par exemple, je pense que la distribution des First Input Delay est une information extrêmement pertinente, facile à comprendre, mais ce serait un vaste sujet, digne d’un autre article de blog.

N’oubliez pas : si vous avez besoin de comprendre ce qui se passe avec JavaScript dans du Monitoring Synthétique, vous pouvez toujours utiliser les Custom Timings pour instrumenter votre code. C’est la meilleure façon de comprendre ce qui compte vraiment pour votre entreprise.


En savoir plus sur l’interactivité et le Time To Interactive :

Une touche d’archéologie


Merci à Henri, Phillip, Peter et Tim qui m’ont aidé à organiser mes idées, et Damien pour ses conseils et multiples relectures.

De retour du Wordcamp Bordeaux 2019

Il y a quelques semaines, j’ai participé au Wordcamp Bordeaux 2019. L’événement se tenait à la Cité Mondiale, en plein cœur des Chartrons, à Bordeaux, dans un espace chaleureux et accessible.

Logo du Wordcamp Bordeaux 2019

Bien que je sois arrivé avec pas mal d’avance, l’accueil fût très bon, d’une part parce que l’équipe était enjouée, sympathique et très organisée et d’autre part parce que tout le travail de signalétique était remarquable (retrouvez les créations sur le portfolio de Mylène Boyrie). Rapidement, le petit déjeuner pris place, avec son lot de réseautage.

Il s’agissait de mon premier Wordcamp, à la fois comme orateur et participant. J’ai rapidement pris la température de l’événement : je dirais que 60 % des participant se connaissaient déjà (réellement ou virtuellement) et étaient ravi de se revoir tandis que les autres, moi vocaux, avaient parfois un peu de mal à s’intégrer. L’ambiance s’est réchauffée assez vite mais pour une future édition, je recommande un petit ice breaker.

Je suis rapidement parti à la découverte de l’amphithéâtre ou je devais, plus tard, présenter ma conférence. L’espace est vaste, sans être écrasant, car les sièges sont distribuées sur la largeur plus que la profondeur. Des écrans secondaires permettent de voir ce qui se passe derrière soi, et la qualité du retour audio est incroyable.

Quelques tests plus tard, le Wordcamp débuta.

De l’intervention de Rémi Corson, je garde un sentiment d’une urgence écologique réelle, mais également d’une grande tristesse. J’ai trouvé que la très juste critique du bilan carbone du Web ne s’accompagnait pas toujours d’une réflexion, qui me semble pourtant utile, sur l’évolution des usages qui en sont faits.

Trop peu de gens restèrent pour l’intervention de l’accessibilité, par Marie Guillaumet. Je préfère me dire que les participant ont préféré assister à la conférence de Daniel Roch sur l’audit de sites Wordpress mais en réalité, je sais qu’il y a souvent une défection pour les sujets en rapport avec l’accessibilité, ce qui confirme qu’il est toujours nécessaire d’en proposer et d’en présenter.
Marie fût assez impressionnante tant ses connaissances sur le sujet sont vastes. Cependant, Si Marie est capable d’aborder tous les aspects de l’accessibilité en moins d’une heure, son public n’est pas nécessairement en mesure de tout assimiler. J’ai trouvé que le contenu de la présentation était très dense, et comme il était aussi très maitrisé, il n’y avait pas de redites. Je me suis juré de revenir ultérieurement sur ses slides.

La conférence de Jack Lennox, mêlant écoconception et performances web, m’a beaucoup intéressé, mais j’ai regretté qu’il n’ait pas répondu au mail que je lui avais envoyé plusieurs semaines avant la conférence pour échanger sur les périmètres respectifs de nos interventions, cela m’aurait permis d’éviter les redites ou de venir abonder certains points plutôt que de les répéter.

Valérie Galassi a parlé d’organisation du travail et son propos m’a beaucoup touché. Les problèmes abordés, je les rencontre parfois dans mon quotidien de télétravailleur à temps complet. Le concept de cotivation, d’ailleurs, résume assez bien la relation qui s’est mise en place naturellement entre Matthieu et moi.

J’ai ensuite assisté à la présentation « E-commerce : Comment assurer la conformité juridique d’un site web en 2019 ? », présentée par Jean-Philippe Souris, du cabinet HAAS Avocats. Il fit le tour des choses importantes à savoir concernant la conformité juridique des activités de vente en ligne. Un rappel intéressant et très bien mené, à près d’un an de l’entrée en application du Règlement Général sur la Protection des Données.

Enfin, j’ai assisté à l’intervention de Stéphanie Laporte sur l’acquisition Social Ads. Cette présentation m’a à la fois enchanté et terrifié car la puissance de Facebook sur nos données, démontrée ici, est toute à la fois fascinante et terrifiante : en captant nos données, Facebook ne se contente pas de nous modéliser, il nous façonne. Le tout, sans arriver à protéger nos données plus d’une semaine d’affilée.

Je n’ai malheureusement pas pu rester jusqu’à la fin de la conférence ; je devais retourner sur Périgueux avant une certaine heure.
J’ai vraiment apprécié cette conférence et je pense que je reviendrai avec plaisir une prochaine fois. Un grand merci à tous les participant, les intervenant et, bien sûr, l’équipe derrière l’événenement !

Netflix : augmenter la vitesse des vidéos

Il y a quelques mois, j’ai publié un article sur l’augmentation de la luminosité des vidéos Netflix et il a eu un certain succès. Mais que faire si vous avez vraiment besoin d’accélérer votre épisode en cours pour le terminer avant que votre bae arrive ou ralentir les mouvements de Beyoncé pour mieux apprendre une de ses chorés dans HOMECOMING ? Pas de problème.

Cliquez-glissez ce lien dans vos favoris:

Gérer la vitesse de lecture des vidéos

N’hésitez pas à renommer le favori avec un libellé plus court. Par exemple, j’utilise seulement les émojis ☀️ (soleil) and 🏃‍ (course).

Allez ensuite sur Netflix, OCS, Molotov, ou n’importe quel service de streaming utilisant des vidéos HTML1, lancez votre série ou film préféré, et cliquez dessus !

Et si vous voulez gérer à la fois la luminosité et la vitesse de lecture vidéo sans multiplier les signets, en voici un qui fait les deux à la fois:

Gestion de la luminosité et de la vitesse de lecture vidéo

GIF: Beyoncé, habillée en reine, pendant Mrs. Carter World Tour

À vous d’être Reine !

  1. Comme expliqué dans le billet précédent, si le site Web a défini une Content-Security-Policy bloquant les favoris, cela ne marchera pas, désolé ! ↩

Lazy Loading, des pages web plus rapides sans impact SEO

Les images sont au cœur de votre site web ? Si vous prenez la performance de votre site au sérieux, vous les avez probablement optimisées. Mais avez-vous pensé à les charger en Lazy Load ? Le Lazy Load des images améliore l’expérience utilisateur en libérant de la bande passante pour le contenu important.

Certains rejettent la technique pour des questions de SEO. Mais un Lazy Load de vos images ne les empêche pas d’être indexées. Voyons pourquoi vous devriez implémenter un Lazy Load d’images et comment vous assurer qu’il soit compatible avec votre SEO.

Note : cet article a d’abord été publié sur le blog de Contentsquare.

Les images sont partout sur le Web, mais servir l’image la plus adaptée au contexte courant peut s’avérer très difficile. L’image doit être optimisée, adaptée à sa zone de rendu et chargée uniquement si nécessaire.

Le Lazy Loading d’images est un ensemble de techniques conçues pour répondre à ce dernier besoin en différant le téléchargement de chaque image jusqu’au moment où elle est nécessaire : après une interaction spécifique, à la suite d’un défilement… ou jamais.

Selon HTTPArchive, 420 Ko (valeur médiane) pourraient être sauvegardés par page en chargeant ainsi les images hors écran et/ou masquées.

Graphique présentant la quantité de données qui pourrait être sauvegardées en ne chargeant pas les images hors-champ.

Quelques cas d’usage

Il y a de nombreux cas concrets du Lazy Loading. Prenons quelques minutes pour citer quelques exemples.

Résultats de recherche E-commerce. Ces pages contiennent souvent tellement de résultats que beaucoup de produits se trouvent en dehors de la fenêtre. Est-il utile de télécharger leurs images ? Avec le Lazy Loading, vous pouvez retarder leur chargement jusqu’à ce que la page soit déroulée.

Les carrousels, vous connaissez ? Pourquoi l’utilisateur devrait-il charger toutes les images alors qu’il ne visualise que la première pendant quelques secondes ? Utilisez le Lazy Load ! Chargez la première image normalement, et lancez le téléchargement de l’image suivante en arrière-plan, quelques secondes avant l’animation du carrousel. Et ainsi de suite.

Menus et onglets. Les images contenues dans un menu ou un onglet sont souvent masquées, affichées seulement après un clic. Avec le Lazy Loading, vous pouvez retarder le chargement de ces images jusqu’à ce que le bouton affichant l’élément soit survolé ou cliqué.

Suivant la nature de votre page, d’autres cas sont envisageables. Aucune image ne devrait être incluse à vos pages sans que vous ne vous soyez posé la question d’en retarder le téléchargement. Car à la clé, il y a d’importants gains de performance.

Il en faut peu pour être heureux

En retardant le chargement des images qui ne sont pas immédiatement nécessaires (ou, dans certains cas, en ne les chargeant pas du tout), le navigateur économise des ressources (bande passante aussi bien que CPU). Ainsi, les ressources préservées peuvent être affectées au contenu plus critique : la page se charge plus rapidement et l’expérience utilisateur est améliorée. Les gains sont aussi présents côté serveur : le processeur et la bande passante nécessaires pour fournir les ressources sont moins sollicités, réduisant les coûts d’hébergement et/ou de CDN.

Comme indiqué dans l’introduction, utiliser du Lazy Loading n’empêche pas vos images d’être indexées par les moteurs de recherche. Mais cela peut être compliqué. Toutes les techniques ne se valent pas car les différentes bibliothèques et plugins disponibles sur le marché ne respectent pas nécessairement toutes les bonnes pratiques. Pour préserver votre référencement naturel, il est donc essentiel de comprendre comment le Lazy Loading fonctionne, et comment l’utiliser sans risque.

Utiliser JavaScript pour le LazyLoad

Dans un monde parfait, le Lazy Loading des images serait automatiquement assuré par le navigateur. Ça sera peut-être bientôt le cas, car une Feature Policy dédiée au Lazyload est à l’étude, mais nous ne pouvons pas encore compter dessus. En attendant, nous devons explorer d’autres solutions, chacune d’entre elles impliquant une modification du balisage HTML et l’ajout d’une dépendance JS.

IMPORTANT Vous n’avez pas besoin – et ne devriez pas – appliquer un lazyload à toutes vos images. Si vous savez que certains images seront affichées la plupart du temps, laissez-les être chargées et rendues normalement. Le Lazy Loading est uniquement recommandé pour les autres images. N’ajoutez pas de complexité si ça n’est pas nécessaire !

Traditionnellement, on utilise JS pour évaluer, à intervalles réguliers, si chaque image (ou chaque élément affichant une image en arrière-plan) doit être chargée et affichée. Les bibliothèques JS très performantes comme lazysizes sont construites sur ce paradigme et sont compatibles avec les anciens navigateurs. lazysizes peut même détecter si le User-Agent est capable de scroller et, sinon, charger les images sans attendre.

Cependant, l’exécution régulière de ces tests a un coût dont on peut s’affranchir sur les navigateurs qui exposent les APIs Intersection et Mutation Observer. Ces API permettent de réagir à des états spécifiques du DOM plutôt que d’avoir à tester continuellement. yall.js et lozad.js sont de bons exemples d’implémentations de ce type mais sont seulement compatibles avec les navigateurs modernes, ou exigent que vous utilisiez une autre bibliothèque, appelée polyfill, pour émuler la fonctionnalité manquante au navigateur.

À NOTER Pour éviter que le navigateur ne considère son absence comme une erreur, je vous recommande fortement de toujours définir la valeur de l’attribut src, en utilisant une très petite image transparente pour occuper l’espace, comme :

<img
src="data:image/gif;base64,R0lGODlhAQABAAAAACH5BAEKAAEALAAAAAABAAEAAAICTAEAOw=="
…

Quelle que soit la solution JavaScript que vous choisissez côté client, vous devez modifier votre backend pour retourner le bon code HTML. Le balisage HTML pour le lazyload d’une image est toujours similaire : l’attribut src est remplacé temporairement par un attribut data-src qui empêche l’élément <img> de charger l’image finale immédiatement.

<!-- Lazy loaded image: before -->
<img data-src="garden.jpg" src="placeholder.jpg" class="js-lazyload" src="data…" />

<!-- Lazy loaded background image: before -->
<div data-class="bg-image-garden" class="container js-lazyload">…</div>

La bibliothèque identifie ses images cibles à l’aide d’un attribut, très souvent en utilisant une classe spécifique (par exemple, ici, nous utilisons la classe js-lazyload). Lorsque la bibliothèque détecte qu’il est temps de charger l’image, l’attribut data-src est utilisé pour remplir l’attribut src et le navigateur commence à charger l’image. La technique est la même pour d’autres types de médias (vidéo, iframes) ou d’images adaptées pour le Responsive Web Design (par exemple, l’attribut data-srcset peut être utilisé pour conserver temporairement la valeur finale de l’attribut srcset)

<!-- Lazy loaded image: after -->
<img src="garden.jpg" class="js-lazyload" … />

<!-- Lazy loaded background image: after -->
<div class="container js-lazyload bg-image-garden">…</div>

Pas de JavaScript ? Contourner avec style (et <noscript>).

Les robots d’indexation, comme par exemple les Googlebots, sont des logiciels qui parcourent le Web dans le but d’en indexer le contenu. Personne ne sait avec certitude quand les Googlebots vont exécuter le code JavaScript de leurs pages, et sous quelles contraintes. Comme démontré par Stephan Boyer en 2016 et confirmé plus tard par Tom Greenaway pendant Google IO 2018, les Googlebots n’exécutent pas JavaScript durant leur première visite. Pour obtenir une indexation se basant sur un rendu complet, il est parfois nécessaire d’attendre plusieurs jours.

Comme les Googlebots indexent le contenu web en deux temps, il est possible que certains détails nous échappent. Tom Greeaway

Comme certaines images.

Parce que si JavaScript n’est pas disponible, les images qui devraient être chargées en Lazy Load ne le seront pas, car l’attribut src ne sera jamais rempli, empêchant le navigateur de démarrer le téléchargement et d’afficher les images. Ne pas télécharger et afficher les images en lazyload impliquent malheureusement qu’elles ne seront pas indexées par les moteurs de recherche.

Comment servir ces images malgré l’absence de JavaScript ? Il y a un élément HTML spécifique que vous pouvez utiliser : <noscript>. Le contenu d’un élément <noscript> n’est affiché que si les fonctions de script ne sont pas supportées ou sont désactivées. C’est exactement ce qu’il nous faut !

Donc si votre réponse HTML contient :

<img
    data-src="garden.jpg"
    src="data/…"
    alt="A spacious garden dominated by a large pine tree."
    class="lazyload"
/>
<noscript>
    <img src="garden.jpg" alt="A spacious garden dominated by a large pine tree." … />
</noscript>

alors :

  • lorsque JavaScript est disponible, seul le premier élément <img> est affiché ;
  • lorsque JavaScript n’est pas disponible, les deux éléments <img> sont pris en compte lors de l’affichage de la page. Le second (dans l’élément <noscript>), est affiché et indexé par les moteurs de recherche. La technique, confirmée par John Mueller, Webmaster Trends Analyst chez Google, est exactement la même pour les images de fond :
<div data-class="bg-image-garden" class="container js-lazyload">…</div>
<noscript>
    <div class="container bg-image-garden">
        … A spacious garden dominated by a large pine tree. …
    </div>
</noscript>

Attention : ne manquez pas d’ajouter un style spécifique qui sera appliqué lorsque JavaScript n’est pas disponible, masquant les images qui n’auront pas été chargées en Lazy Load.

Comme le code de chaque image est plus que dupliqué, vous pourriez craindre que cette implémentation ne produise un code HTML verbeux. Ne vous inquiétez pas, vos documents HTML sont normalement compressés avec gzip ou brotli avant d’être envoyés sur le réseau. L’impact de ces duplications sur le poids du transfert est donc négligeable (si vous n’êtes pas sûr que votre site utilise une compression, testez vos pages avec Dareboost).

Reste bien sûr que saisir toutes ces balises n’est pas évident. En gérant les images responsives, la direction artistique… le balisage des images peut être très, très pénible. De toutes façons, vous ne devriez pas saisir ce code HTML à la main : gérer cette complexité automatiquement devrait être de la responsabilité de votre CMS, ou une tâche dédié de votre processus de contribution.

Un cinquantaine de lignes de HTML bien dense.

Balisage d’une image de The Guardian, avant-même la mise en place d’un Lazy Loading

Tester l’implémentation

Une fois le Lazy Load implémenté, vous devrez tester qu’il fonctionne. La solution la plus simple est, bien sûr, d’exécuter un audit complet de performance web avec Dareboost pour détecter si toutes les images hors du viewport sont chargées tardivement ou à la demande. Si ce n’est pas le cas, l’outil vous remontera les URL des images pour lesquelles le chargement peut être reporté.

Si vous avez conditionné le chargement de vos images à la survenue d’un événement navigateur ou personnalisé, n’hésitez pas à consulter la Waterfall de votre rapport pour vérifier que le chargement des images respecte votre chronologie. S’il s’agit d’un événement personnalisé, n’hésitez pas à utiliser un Custom Timing pour être en mesure de le retrouver dans la Waterfall.

Il peut aussi être utile de faire des tests manuels. Ouvrez votre navigateur sur la page web concernée, ouvrez les outils de développement et sélectionnez l’onglet Réseau (tous les navigateurs modernes le proposent). Videz la pile réseau pour mieux visualiser les nouveaux appels, puis provoquez l’interaction destinée à démarrer le Lazy Loading.

Voici un exemple sur Chrome, avec un Lazy Loading activé au défilement :

Vous pouvez envisager d’automatiser ces tests en utilisant des outils basés sur un navigateur. Puppeteer est l’un d’entre eux et peut être utilisé pour tester le comportement de votre Lazy Loading avec Chrome ou Chromium, pour s’assurer que vos vrai visiteurs verront vos images.

Pour vérifier que les robots d’indexation verront également vos images, vous pouvez demander à Google lui-même, en utilisant l’outil Inspecteur d’URL de la Google Search Console. Vous afficherez votre page exactement comme si elle avait été récupérée par Google. Insérez simplement votre URL pour que le Googlebot teste votre page et réalise une capture d’écran du résultat pour confirmer que votre contournement <noscript> fonctionne comme prévu.


Et voilà, vous savez maintenant tout ce qu’il y a à savoir sur le Lazy Loading d’images, son impact SEO et la meilleure façon de le contourner. Il est temps de faire un peu de ménage !

Optimisation du temps de compilation de Jekyll

Il y a trois ans, fatigué par WordPress et de sa galaxie de plugins douteux, j’ai décidé de migrer vers un générateur de site statique. Après quelques essais avec diverses solutions, j’ai opté pour Jekyll, dont la communauté me semblait plus mature.

Trois ans plus tard, je commence à comprendre les forces et les faiblesses de la solution, mais je reste loin d’en maîtriser tous les mystères. Je l’ai bidouillée pour publier du contenu multilingue, j’ai développé mes propres plugins, j’ai intégré des éléments d’architecture piochés chez des amis… Disons que je suis désormais assez à l’aise.

Par contre, à force de manipulations, mon Jekyll ressemblait moins au célèbre docteur qu’au monstre de Frankenstein : un assemblage de portions de code grossièrement liées entre elles par des liens fragiles, se déplaçant lentement en gémissant… En un mot comme en cent : mon build était lent.

Note : cet article a d’abord été publié sur le blog de Jamstatic.fr.

TL;DR

  • Constatant que ma compilation Jekyll était des plus lentes, j’ai contacté la communauté JAMstack francophone pour des conseils.
  • Plusieurs choses ont émergé, chaque conseil permettant d’optimiser le temps de compilation.
  • Le plus gros gain provient des évolutions de Jekyll lui-même, sur lequel l’équipe est en train de faire un énorme travail.

Pour générer mon site (source), j’ai développé un ensemble de commandes Rake1 qui se chargent de nettoyer l’espace de travail, de déterminer l’environnement de destination et de configurer la compilation en conséquence, de vérifier l’intégrité des en-têtes front matter de mes articles, de générer le site avec Jekyll et, enfin, de contrôler ce qui est produit en utilisant la gemme html-proofer. Je n’exécute pas tout cela sur mon ordinateur : à la place, je délègue cette tâche à Netlify, branché sur mon dépôt GitHub pour compiler et déployer mes branches.

Toutes ces tâches prenaient individuellement du temps, mais la partie dédiée à la génération avec Jekyll restait la plus consommatrice de CPU, prenant plusieurs minutes. Résultat : pendant des mois, mes compilations Netlify ont duré plus de 10 minutes. Chaque compilation était plus lente que la précédente.

Il y a quelques jours, Netlify a complètement arrêté le déploiement du site web car mes compilations prenaient tellement de temps qu’elles dépassaient la limite imposée par le système d’intégration continue de Netlify2.

Il était temps d’agir.


Un proverbe africain dit :

Seul, on va plus vite. Ensemble, on va plus loin.

Je ne pense pas que ce soit tout à fait vrai. Je crois que lorsque nous nous entourons des bonnes personnes, nous pouvons aller ailleurs, vers des possibilités que nous n’avions même pas envisagées.


Quand j’ai pensé que j’atteignais la limite de mes compétences, j’ai demandé l’aide à la communauté que je connais le mieux : les membres de JAMstatic. Et parmi eux, un membre de la Core Team de Jekyll, Frank. Il m’a beaucoup aidé (et continue de le faire) en me montrant des possibilités que je n’avais pas envisagées.

Inclusions : à consommer avec modération

L’expérience m’a appris qu’il est souvent plus difficile de maintenir un projet que de le réaliser en premier lieu. Pour augmenter ses chances de succès, mieux vaut trouver des techniques d’organisation du code qui soient adaptées à sa compréhension sur le long terme. À mon sens, diviser le code en portions significatives est l’une des astuces de maintenance les plus efficaces.

Dans Jekyll, cela se fait avec des inclusions, via la balise {% include %}. Mais attention, une décomposition de code trop ambitieuse aura un coût sur votre temps de compilation, que vous pourrez visualiser avec le profileur Liquid [EN].

D’après Pat Hawks, membre de la Core Team Jekyll :

Chaque fois que vous utilisez une balise {% include %}, Jekyll doit ouvrir le fichier concerné, lire son contenu en mémoire, puis analyser le gabarit avec Liquid. Cela se produit à chaque {% include %}, et pas une seule fois par fichier ! Donc l’utilisation d’une même inclusion sur 100 pages provoquera le chargement et l’analyse de cette inclusion 100 fois. Le problème s’aggrave très rapidement si vous commencez à faire des inclusions dans vos inclusions…

Une façon de surmonter ce coût supplémentaire est de mettre en cache les blocs compilés pendant l’interprétation de votre {% include %}. Il y a un plugin pour cela : le plugin jekyll-include-cache de Ben Balter. Mais attention à deux choses très importantes :

  1. assurez-vous de passer toutes les données nécessaires à votre {% include %} en paramètres, car elles seront utilisées comme clés pour le cache ;
  2. si vous le pouvez, n’utilisez des inclusions que pour générer des portions de code réutilisables. Si les paramètres de l’inclusion la rendent si spécifique qu’elle n’est pas réutilisable ailleurs, alors le cache relatif à cette inclusion aura été construit pour rien et n’apportera aucun gain de performance.

Ces deux contraintes sont si fortes qu’elles m’ont obligé à réintégrer plus de la moitié de mes inclusions dans mes gabarits (_layouts). Je ne suis pas entièrement satisfait de cette situation (car, en conséquence, je trouve que les capacités de maintenance sont dégradées) mais je dois avouer que j’ai gagné près de 10 % de temps de compilation3 en sacrifiant ce petit confort.

Et avec des commentaires Liquid ({% comment %}This is a comment{% endcomment %}), je peux toujours organiser efficacement mon code, même réintégré dans un seul fichier.

Faites confiance aux gemmes compilées en C

Par défaut, Jekyll est basé sur un ensemble de gemmes écrites en Ruby. Récemment, de nouvelles gemmes sont apparues, partiellement écrites en C, ce qui améliore leur performance d’exécution. L’équipe Jekyll a eu la gentillesse d’ajouter des tests conditionnels dans le générateur pour utiliser ces gemmes si elles sont référencées dans votre Gemfile. Vous n’avez donc qu’à ajouter les gemmes à votre Gemfile pour tirer parti de ces améliorations.
Il en existe certainement d’autres, mais en voici au moins deux :

  • la gemme liquid-c, pour optimiser la compilation Liquid ;
  • la gemme sassc, si vous avez besoin de Jekyll pour compiler des fichiers Sass plus efficacement.

Je n’ai pas besoin de Jekyll pour mes fichiers Sass mais en utilisant liquid-c, j’ai économisé 9 % du temps de compilation.

Si vous pouvez l’éviter, n’utilisez pas LSI

Jekyll est livré avec une option très pratique appelée Latent Semantic Indexing (LSI) dont le rôle est d’analyser tout le contenu avant de générer le site, afin d’alimenter, pour chaque article, une collection qualitative d’articles connexes (au lieu des dix articles les plus récents). LSI fait un très bon travail mais si vous avez des centaines d’articles comme moi, il fonctionnera lentement, très lentement4.

Après une très rapide non-analyse des données analytiques dont je ne dispose pas5, j’ai décidé de me séparer de la proposition d’articles associés et d’économiser 17 % du temps de compilation.

Markdown : choisissez la bonne variante

Markdown est un langage à balisage léger vraiment sympa mais il lui manque une chose très importante : une standardisation. Il existe des douzaines de parseurs Markdown, chacun avec ses caractéristiques spécifiques. Depuis quelque temps, une initiative de standardisation émerge autour de CommonMark, et les projets l’implémentant fleurissent.

Par défaut, Jekyll utilise kramdown, un surensemble de Markdown développé en Ruby qui fait du très bon boulot. Pour le remplacer par CommonMark, j’ai voulu utiliser commonmarker qui est, encore une fois, un wrapper Ruby pour une implémentation en C. Pour en tirer parti dans Jekyll, vous pouvez utiliser le plugin jekyll-commonmark de Pat Hawks.

Attention, la transition n’est pas sans adaptations. kramdown et CommonMark sont assez différents : en passant de l’un à l’autre, j’ai dû sacrifier quelques sucres syntaxiques.
Par exemple, CommonMark ne supporte pas les attributs de bloc tels que { :.myclass} pour décorer un paragraphe de contenu. Vous aurez besoin d’utiliser de bonnes vieilles balises HTML. N’oubliez pas d’activer l’option UNSAFE dans votre configuration Jekyll (_config.yml) si vous ne voulez pas générer beaucoup de commentaires du type <!-- raw HTML omitted --> :

markdown: CommonMark
commonmark:
  options: ["SMART", "FOOTNOTES", "UNSAFE", "HARDBREAKS"]
  extensions: ["strikethrough", "autolink", "table"]

Vous remarquerez peut-être aussi que CommonMark est moins tolérant que kramdown, qui corrige à la volée de nombreuses approximations de contribution. Passer à cet analyseur m’a aidé à détecter des problèmes dans mes articles que je n’avais jamais remarqué auparavant. Si vous avez un contenu conséquent, attendez-vous à devoir corriger quelques coquilles.

Un petit prix à payer pour gagner encore 9 % de temps de compilation.

Faites confiance à la Team pour aller dans la bonne direction

Enfin, l’une des dernières améliorations apportées a été le passage à la version master de Jekyll. Depuis la version 3.8.5 (ma version précédente), de nombreuses améliorations ont été apportées, et le gain de performance est vraiment considérable : 93 % !

Je n’arrivais tellement pas à y croire que j’ai temporairement versionné mon dossier _site et vérifié qu’il n’y avait rien de cassé en changeant de version. Et dans mon cas : rien à redire, tout est parfait.

Si vous ne deviez retenir, ou tester, qu’une seule optimisation, c’est celle-ci. Faites confiance à la Core Team, la performance est une de leurs priorités.

Qu’en est-il de mon chantier multilingue ?

Avec toutes ces optimisations, ma compilation Jekyll est passée de plus de 15 minutes à environ une minute. C’est encore beaucoup, et je sais pourquoi : ma gestion « fait maison » de l’internationalisation, et plus particulièrement de la traduction de mes articles, est sous-optimale.

Elle est basée sur une clé front matter i18n-key qui me permet de faire se correspondre mes articles et pages d’une langue à l’autre et sur un plugin qui, pour chaque contenu, scanne tous les autres contenus pour trouver ceux qui sont des traductions du contenu courant. Cette stratégie O(n²), bien que facile à mettre en œuvre, n’est pas efficace du tout et pénalise mes performances de compilation.

Ashwin Maroli, l’un des membres de la Jekyll Plugin Core Team, travaille sur un plugin qui utilise une convention d’organisation des fichiers pour trouver les traductions, ce qui devrait considérablement améliorer les choses : jekyll-locale. J’ai essayé d’implémenter le plugin sur mon blog mais j’ai rencontré quelques impondérables lors de cette première tentative. J’y reviendrai plus tard, une fois que j’aurais simplifié mon organisation des contenus. J’aurais également besoin que certains autres plugins soit modifiés pour être compatibles, comme jekyll-paginate-v2 de Sverrir Sigmundarson, qui me sert pour la pagination.

Je ne manquerai pas d’en parler quand j’attaquerai à nouveau ce chantier


Protocole expérimental

Comme les optimisations ci-dessus nécessitent également de modifier le contenu, je n’ai pas effectué de benchmark en parallèle de l’implémentation itérative des optimisations. J’ai attendu d’avoir complètement terminé, et donc d’avoir le contenu final, puis j’ai repris ma configuration d’avant optimisation et j’ai analysé les gains étape par étape.
Voici mon protocole de test : Je suis parti d’une installation sans aucune de ces optimisations, puis j’ai écrit un script implémentant les optimisations une par une et compilant le site (sauf la suppression des inclusions, car… j’étais trop paresseux pour scripter la modification des gabarits, je l’avoue). J’ai ensuite programmé l’exécution du script 10 fois et je me suis couché pendant que mon ordinateur passait près de 16 heures à passer ces optimisations au banc d’essai.

Voici les données brutes, si certains veulent jouer avec :

Run Step Done in… (s)
Test 1 1 - Before 1337,872
Test 1 2 - Switch to liquid-c 1509,997
Test 1 3 - Remove LSI 1264,981
Test 1 4 - Switch to CommonMark 1282,607
Test 1 5 - Switch to main 64,949
Test 2 1 - Before 1510,356
Test 2 2 - Switch to liquid-c 1457,161
Test 2 3 - Remove LSI 1239,278
Test 2 4 - Switch to CommonMark 1058,934
Test 2 5 - Switch to main 72,335
Test 3 1 - Before 2148,253
Test 3 2 - Switch to liquid-c 1465,446
Test 3 3 - Remove LSI 1253,785
Test 3 4 - Switch to CommonMark 886,152
Test 3 5 - Switch to main 92,384
Test 4 1 - Before 1621,322
Test 4 2 - Switch to liquid-c 1506,737
Test 4 3 - Remove LSI 1225,414
Test 4 4 - Switch to CommonMark 1057,497
Test 4 5 - Switch to main 87,943
Test 5 1 - Before 1589,323
Test 5 2 - Switch to liquid-c 1607,33
Test 5 3 - Remove LSI 1261,815
Test 5 4 - Switch to CommonMark 914,124
Test 5 5 - Switch to main 77,526
Test 6 1 - Before 1643,596
Test 6 2 - Switch to liquid-c 1481,98
Test 6 3 - Remove LSI 1237,843
Test 6 4 - Switch to CommonMark 1336,47
Test 6 5 - Switch to main 69,099
Test 7 1 - Before 1456,432
Test 7 2 - Switch to liquid-c 1487,558
Test 7 3 - Remove LSI 1268,737
Test 7 4 - Switch to CommonMark 1106,233
Test 7 5 - Switch to main 69,562
Test 8 1 - Before 2943,453
Test 8 2 - Switch to liquid-c 1492,383
Test 8 3 - Remove LSI 1229,34
Test 8 4 - Switch to CommonMark 1321,156
Test 8 5 - Switch to main 70,332
Test 9 1 - Before 1587,532
Test 9 2 - Switch to liquid-c 1586,698
Test 9 3 - Remove LSI 1264,424
Test 9 4 - Switch to CommonMark 950,634
Test 9 5 - Switch to main 69,907
Test 10 1 - Before 1643,22
Test 10 2 - Switch to liquid-c 1581,063
Test 10 3 - Remove LSI 1229,119
Test 10 4 - Switch to CommonMark 1332,547
Test 10 5 - Switch to main 69,022
  1. Rake est un orchestrateur similaire à make, mais en Ruby (en savoir plus). ↩

  2. 15 minutes, comme confirmé par Chris McCraw dans son article « How Our Build Bots Build Sites ». ↩

  3. Vous allez devoir me croire sur parole, parce que mon protocole d’expérimentation ne contenait pas de test avec et sans inclusions. Il s’agit donc d’une estimation personnelle. ↩
  4. Il semblerait que la gemme gsl permette d’améliorer cela, mais je ne l’ai pas testé. Vos retours m’intéressent. ↩

  5. Parce que je n’ai pas besoin de ça pour connaître les personnes qui me lisent, car elles interagissent souvent avec moi dans les commentaires ou sur Twitter. ↩

Content Encoding: pourquoi utiliser la balise meta charset et l’en-tête Content-Type

Améliorer la vitesse à laquelle une page Web est affichée implique souvent de rendre la vie du navigateur aussi facile que possible. Lorsque le navigateur reçoit une réponse HTTP, il reçoit en fait du texte encodé en octets, où chaque octet ou séquence d’octets représente un caractère donné. Si le navigateur ne sait pas clairement quel encodage utiliser, il perdra du temps à essayer de le deviner et sera susceptible d’échouer dans certains cas.

Note : cet article a d’abord été publié sur le blog de Dareboost (abandonné).

Bien que le Web se veuille universel, les différents groupes humains qui l’utilisent ont leurs propres spécificités. L’une de ces spécificités est le langage, surtout lorsqu’il est écrit. Tout contenu textuel est composé de caractères, provenant d’un répertoire destiné à un type donné d’utilisation. Les hiraganas, par exemple, constituent un système phonétique destiné à la transcription sans ambiguïté de la langue japonaise.

Hiraganas

Tableau montrant le sens d’écriture des hiraganas
par Karine WIDMER (CC-BY-SA-3.0 · Source)

Pour pouvoir désigner chaque caractère sans ambiguïté, il faut attribuer à chacun d’eux un identifiant unique. L’ensemble des identifiants sera appelé un jeu de caractères. Une fois cette table de correspondance définie, chaque caractère doit être converti en une séquence d’octets afin que nous puissions les stocker ou les partager entre systèmes informatiques. C’est ce qu’on appelle l’encodage de caractères (encoding).

Imaginez que j’utilise un jeu de caractères pour écrire du texte et un encodage correspondant pour le convertir en octets, et qu’enfin, je vous l’envoie. Comment le décoder et lire le contenu, sans savoir quel encodage ou quel jeu de caractères j’ai utilisé ? Vous n’aurez pas d’autre choix que d’essayer les jeux de caractères les plus couramment utilisés, en espérant que le résultat ait un sens… Au pire, que pourrait-il bien se passer ?

Remplacer un point-virgule (;) par un point d’interrogation grec (;) dans le code JavaScript de vos amis puis regardez-les s’arracher les cheveux sur les erreurs de syntaxe. Ben Johnson (@benbjohnson), 16 novembre 2014

Oui, bon… ce n’est visiblement pas une bonne idée.

À titre d’exemple, la séquence de bits 1100 0011 1010 1001 correspond au caractère « é » dans l’encoding UTF-8. Si vous décodez cette séquence en supposant devoir utiliser l’encoding Latin-1 et non de l’UTF-8, vous lirez « Ã © ».
En Latin-1, le caractère « é » est représenté par la séquence 1110 1001.

Lorsque le navigateur reçoit des octets, il doit identifier la collection de lettres et de symboles qui ont été utilisés pour écrire le texte qui a été converti en ces octets, ainsi que le codage utilisé pour cette conversion, afin de l’inverser. Si aucune information de ce type n’a été transmise, le navigateur tentera de trouver des motifs reconnaissables dans les octets pour déterminer l’encodage lui-même, et éventuellement essayer certains jeux de caractères courants, ce qui prendra du temps, retardant le traitement ultérieur de la page.

Pour accélérer l’affichage de vos pages, vous devez spécifier l’encodage du contenu dans votre réponse HTTP.

Comment choisir le bon jeu de caractères ?

Il fut un temps où coexistaient des centaines d’encodages de caractères, tous limités et ne pouvant pas contenir suffisamment de caractères pour convenir à la plupart des langues du monde. Parfois, aucun encodage n’était adéquat pour toutes les lettres dans une seule langue.

Aujourd’hui, Unicode (un jeu de caractères universel, définissant tous les caractères nécessaires pour écrire la majorité des langues) est devenu un standard, quelle que soit la plate-forme, le périphérique, l’application ou la langue que vous visez. UTF-8 est l’un des encodages Unicode et celui qui devrait être utilisé pour le contenu Web, selon le W3C :

Tous ceux qui développent du contenu, qu’ils soient des auteurs de contenus ou des programmeurs, devraient utiliser l’encodage de caractères UTF-8, sauf s’il existe des raisons très spéciales pour utiliser autre chose. (Si vous décidez de ne pas utiliser UTF-8, vous devrez choisir l’un des quelques encodages interopérables mis en place sur tous les navigateurs.) « Présentation des jeux et encodages de caractères », W3C

Note : si vous utilisez une base de données pour stocker votre contenu côté serveur, vous pourriez être tenté d’utiliser aussi le jeu de caractères « utf-8 ». Attention : sur MySQL et MariaDB, c’est un alias pour « utf8mb3 », un encodage UTF-8 appelé « Basic Multilingual Plane » (ou BMP) qui ne stocke qu’un maximum de trois octets par caractère. Préférez plutôt utiliser « utf8mb4 », un encodage qui stocke un maximum de quatre octets par caractère. Sinon, vous ne pourrez pas utiliser certains caractères populaires, tels que 🚀, autrement connu sous le nom de « U+1F680 ROCKET » !

Comment communiquer l’encodage utilisé… et la meilleure façon de le faire.

Avant d’aller plus loin, faisons un point sur le vocabulaire usité :

Historiquement, les termes « character encoding », « character map », « character set » et « code page » étaient synonymes en informatique […]. de nos jours, les termes ont des significations connexes bien que distinctes […] Quoi qu’il en soit, les termes sont toujours utilisés de façon interchangeable, « character set » s’imposant presque partout. « Character encoding », Wikipedia, traduction française

On retrouve cette utilisation de « character set » ou « charset » pour désigner, en réalité, un encodage, dans les spécifications HTML. Nous ferons de même dans la suite de cet article. Une des façons les plus simples de spécifier un jeu de caractères dans une page HTML est de mettre une balise <meta> dans l’élément :

<meta charset="utf-8">

Déclarer un jeu de caractères de cette façon nécessite de respecter certaines contraintes [EN], l’une d’entre elles étant que l’élément contenant la déclaration d’encodage de caractères doit être complètement sérialisé sur les premiers 1024 octets du document. Cela permet de s’assurer que les navigateurs recevront l’information par les premiers paquets IPs transitant sur le réseau, et qu’ils seront ensuite en mesure de décoder le contenu du document de manière fiable. Comme la balise charset <meta> est la seule à présenter ce type d’impératifs, il est de bon ton de la placer directement après la balise ouvrante :

<html …>
  <head …>
    <meta charset="utf-8">

Si vous avez peur d’oublier, ne vous inquiétez pas. C’est évidemment l’un des contrôles que Dareboost effectuera pour vous au sein de notre outil d’analyse de la qualité web. Cependant, il se peut que vous vous trouviez dans la situation où cette déclaration n’est pas suffisante, et que le navigateur n’en tienne pas compte. Pourquoi ? Parce que les métadonnées de la page peuvent indiquer un autre jeu de caractères et qu’en cas de conflit, ces informations, définies dans les en-têtes HTTP, sont prioritaires.

Pour s’assurer de l’information transmise par les métadonnées de la page, vous pouvez utiliser notre fonctionnalité d’affichage de la Timeline/Waterfall. Dépliez les informations détaillées de votre document principal pour afficher les en-têtes HTTP de la réponse, y compris l’en-tête Content-Type, contenant les métadonnées d’encodage.

En-tête de type de contenu dans une réponse HTTP

Pour changer cet en-tête HTTP, vous devrez vous adresser à la personne qui gère votre serveur web, qu’il s’agisse de votre hébergeur ou d’un responsable de votre organisation, car la configuration des en-têtes HTTP est très spécifique au serveur Web utilisé, et vous aurez besoin des droits d’administration appropriés pour pouvoir modifier ces paramètres.

Sur Apache 2.2+, la configuration de l’UTF-8 comme jeu de caractères par défaut pour les fichiers de types text/plain ou text/html implique d’utiliser la directive AddDefaultCharset [EN]:

AddDefaultCharset utf-8

Pour les autres types de fichiers, vous aurez besoin d’utiliser la directive AddCharset:

AddCharset utf-8 .js .css …

Dans nginx, vous devrez vous assurer que le module ngx_http_charset_module est chargé, puis utiliser la directive charset.

charset utf-8;

Ici aussi, il est possible d’affiner le champs d’application pour que d’autres types de fichiers que text/html soient livrés en utf-8, en utilisant la directive charset_types:

charset_types text/html text/css application/javascript

Bien sûr, vous pouvez aussi configurer l’en-tête HTTP Content-Type dans votre code côté serveur. En PHP, par exemple, vous pouvez utiliser la fonction réseau the header(). N’oubliez pas, si vous le faites, de définir le type de média (ou type MIME) du corps de la réponse, en plus du jeu de caractères.

header('Content-type: text/html; charset=utf-8');

Attention : si vos pages sont délivrées par un Content Delivery Network (CDN), vous devrez peut-être configurer l’en-tête Content-Type dans la configuration du CDN, car la plupart d’entre eux ne répercutent pas les en-têtes qu’ils trouvent sur vos serveurs.

Additional Resources

Ne me git pas

À des fins d’expérimentation, j’ai joué avec browser.tabs.onActiveChanged pour afficher une chanson dans l’onglet de mon blog quand on quitte la page. Je n’avais aucune idée de l’impact sur l’accessibilité et voulais le tester. Je ne l’ai pas gardé, car le résultat perturbe grandement la navigation des utilisateurs et utilisatrices d’outils de restitution des contenus.

GIF: Capture vidéo de Chrome où l’on voit l’onglet s’animer

🎶 Moi je t’offrirai
des commits ciselés
sur des branches forkées
Où on ne rebase pas !

Je ferai des pull
Jusqu’après ma mort
Pour avoir tes tags
Jusque dans mon stash !

Je ferai un HEAD
Où le –force sera chain
Où master sera main
Où tu seras reine

Ne me git pas
Ne me git pas
Ne me git pas 🎶

Jacques <br/>el.

Un fichier hosts pour les bloquer tous

En tant qu’expert du domaine, les gens me demandent souvent comment améliorer la performance des sites Web. Parfois, ils me demandent aussi comment améliorer les performances du Web sur leur propre machine, pour leur propre expérience de navigation. Dans ce cas, ma réponse est toujours la même : commencer par le fichier hosts.

Gollum, tenant l'Anneau unique dans l'adaptation du Seigneur des Anneaux de Peter Jackson

Je manquais d’inspiration pour trouver une illustration plus sympa…

Filtrer les polluants

Le Web d’aujourd’hui est blindé de saletés. La plupart des sites sont bourrés de traqueurs, de publicités et de beaucoup d’autres choses désagréables qui pénalisent le chargement des sites Web. Pour éviter cela, les gens utilisent de plus en plus d’AdBlockers1. Ils offrent une solution simple et rapide (la plupart du temps, une extension de navigateur) qui bloque la plupart des contenus indésirables.

Malheureusement, au niveau de l’UX, les AdBlockers ne font pas toujours l’affaire. Ils augmentent souvent la quantité de mémoire vive et de cycles CPU utilisés par votre navigateur Web, ce qui ralentit votre expérience de navigation au lieu de l’améliorer. Certains font mieux que d’autres, et des navigateurs entiers2 ont été conçus pour bloquer les contenus indésirables, et font en cela un travail incroyable. Mais le web ne se limite pas à votre navigateur, n’est-ce pas ?

Tout votre ordinateur consomme du Web. La plupart des applications grand public sont autant remplies de trackers que n’importe quel site web de Presse. Parfois, vous pouvez même voir les publicités affichées dans votre interface utilisateur (Bonjour, Skype. Oui, je parle de toi, vilain garçon).

Les AdBlockers ne peuvent rien y faire. Mais un simple fichier hosts, si.

Hosts… kézako ?

Le fichier hosts est un fichier utilisé par le système d’exploitation d’un ordinateur lors de l’accès à un réseau, comme Internet par exemple. Son rôle est d’associer des noms d’hôtes à des adresses IP. « hosts », sur Wikipedia

Chaque fois que votre navigateur interagit avec un site Web, il requête en réalité un serveur, identifié via son adresse IP, comme 185.31.40.11 (IPv4) ou 2a00:b6e0:1:20:2::1 (IPv6). Cette adresse est assez semblable à une adresse postale.

Imaginez que vous accédez à une page web, comme https://boris.schapira.dev. Comment votre navigateur sait-il quelle adresse IP contacter ? Eh bien, le navigateur demande simplement à l’annuaire Internet. Enfin, à l’un d’entre eux. Et l’annuaire, appelé DNS, trouve l’adresse IP correspondante et la donne au navigateur.

Je ne sais pas pour vous, mais moi je n’utilise jamais d’annuaire. La plupart du temps, j’ai recueilli l’adresse des personnes à qui je veux écrire dans mon carnet d’adresses personnel et je pioche dedans. C’est exactement à cela que sert le fichier hôtes. Chaque fois qu’un processus sur votre ordinateur a besoin d’accéder à une ressource sur Internet, il passe d’abord par le fichier hosts pour savoir où la trouver.

Maintenant, imaginons que vous ne vouliez pas que le processus trouve la ressource en question. Rien de plus simple, lancez-le sur une mauvaise piste, en associant le domaine badthings.com à une adresse non spécifiée comme 0.0.0.0.0.

Donc, si quelqu’un fait une liste de tous les domaines contenant des ressources problématiques, nous pouvons tous les rediriger vers 0.0.0.0.0 dans notre fichier hosts, et faire de notre propre Web un endroit beaucoup plus sympa.

Un projet pour tous les rassembler

Il n’y a rien de nouveau dans ce que je décris ici. Les gens cool font ça depuis des années, partageant leurs fichiers hôtes. Les sites de fake news, les plates-formes de jeu d’argent, les groupements de sites pornographiques, les pages qui cryptominent sur votre ordinateurs, les tentatives de fraude et les escroqueries sont tous patiemment identifiés et répertoriés dans des fichiers en accès libre.

J’utilise le projet « hosts » de Steven Black, un script python, pour les agréger en un fichier hosts unique de 2MB contenant plus de 70k domaines. Au cas où vous vous poseriez la question : je peux modifier le résultat avec ma propre liste d’acceptation (des domaines qui seraient bloqués normalement, mais dont je veux quand même laisser passer les requêtes) et des redirections (ce qui me permet d’écrire cet article et de vérifier le résultat sur https://boris.schapira.local:10443/ qui pointe, en fait, vers ma propre machine).

Si vous n’êtes pas à l’aise avec la ligne de commande et utilisez Windows 10, l’application hostsman vous offrira les mêmes fonctionnalités (malheureusement, au moment où je publie ce billet, le site web ne semble pas joignable. Heureusement, il existe une version portable de l’application).
Je ne recommanderai pas de modifier votre fichier hôte sur les versions précédentes de Windows même si je le faisais, avant 2015, sauf si vous aimez exécuter ipconfig /flushdns toutes les 30 minutes. Sur Linux, j’ai vu des gens discuter de dnscrypt-proxy… mais je ne l’ai jamais testé.

Un capture de la fenêtre de hostsman, lors de la gestion des sources.

Vous pouvez gérer des sources pour vos mises à jour dans hostsman

Quelques astuces pratiques

Parfois, j’ai besoin de désactiver temporairement ce fichier hosts. Par exemple, quand j’ai besoin d’aider des clients Dareboost à comprendre l’impact des scripts tiers sur leurs pages (et que j’ai donc besoin de charger ces scripts tiers également).

Pour activer ou désactiver mon fichier hosts, j’utilise une fonction en ligne de commande que j’ai développée et placée dans mon fichier ~/.profile [^ozsh]: [^ozsh]: En réalité, je l’ai mises dans mon ~/.zprofile, car j’utilise Oh My ZSH.

function togglehost() {
    if [ -e /etc/host.bak ]
    then
        sudo mv /etc/host.bak /etc/hosts
        echo "Fichier host réactivé"
    else
        sudo mv /etc/hosts /etc/host.bak
        echo "Fichier hosts mis de côté"
    fi
}

Une fois cette fonction chargée, l’activation ou la désactivation de mon fichier hosts est très simple :

$ togglehost
Fichier hosts mis de côté
$ togglehost
Fichier host réactivé

Mais comme j’oublie parfois de le remettre en place, j’ai mis en place une routine qui vérifie chaque minute que le fichier est bien là et, si ce n’est pas le cas, me prévient en utilisant noti, de Jaime Piña, pour déclencher une notification. Pour exécuter ce contrôle régulier, j’utilise crontab.

* * * * * if [ ! -e /etc/hosts ]; then /usr/local/bin/noti -t "Fichier hosts" -m "introuvable"; fi

Cela fait des années que j’utilise cette technique et il m’arrive d’oublier que mon fichier hosts me protège à ce point. Chaque fois que j’ai besoin d’utiliser l’ordinateur de quelqu’un d’autre, ou de désactiver temporairement mon fichier hosts, je réalise le niveau de confort qu’il me procure.

Je suis bien conscient que la manipulation de son propre fichier hosts est une solution efficace mais qui recquiert un certain niveau de compétence technique. Il ne remplace pas complètement un AdBlocker (ou je n’ai pas encore agrégé assez de fichiers) mais c’est un gain de performance incroyable, que je recommande fortement pour la navigation quotidienne.

Essayez par vous-même, et dites-moi ce que vous en pensez !


Synthèse

Le fichier hosts est le carnet d’adresses interne de votre ordinateur qui guident les requêtes Web vers les bons serveurs. Remplissez votre fichier hosts avec des domaines pointant dans le vide vous permet de vous assurer que les requêtes pointant vers ces domaines échoueront rapidement et efficacement. Des gens partagent leurs fichiers hôtes depuis des années. Il existe maintenant des solutions pour les concaténer, ce qui permet de co-construire une solution pour lutter contre le Web pollué auquel nous devons faire face tous les jours.


Bonus

Quelques alternatives sympas à localhost :

# http://👻 (localghost)
127.0.0.1 xn--9q8h
# http://🏖️ (localcoast)
127.0.0.1 xn--km8h
# http://🚽 (quand le projet n'est pas très… motivant)
127.0.0.1 xn--s78h

Et bien d’autres sur Emojipedia

  1. Le taux de pénétration des bloqueurs publicitaires aux États-Unis est d’environ 30 % sur les ordinateurs de bureau, et d’environ 12 % sur les téléphones mobiles, selon cette étude eMaketer sur le blocage des publicités à partir de mars 2017. ↩

  2. Si vous n’avez jamais testé le navigateur Brave, je ne peux que vous encourager à le faire, et à rejoindre les 4 millions de personnes qui lui font confiance pour réparer leur Web. ↩

Netflix : augmenter la luminosité des vidéos

Mes enfants sont en vacances chez leurs grand-mères, ce qui me laisse beaucoup de temps libre pour binge-watcher des séries TV sur Netflix. Sauf que je trouve que sur Netflix, l’image est souvent trop sombre. Pas vous ?

Du coup, entre une partie de PS41 et un chapitre de roman2 (parce qu’il y a une vie en dehors de Netflix), j’ai préparé un petit bookmarklet qui augmente la luminosité des vidéos de la page courante. Pour en profiter :

Cliquez-glissez le lien suivant dans votre barre de favoris3 :

Gérer la luminosité des vidéos

Ensuite rendez-vous sur Netflix, lancez votre série ou film préféré et cliquez sur « ☀️ » !

GIF: Le Joker applaudit

Notez que cela doit marcher un peu partout, pas que sur Netflix. Un clic sur le bookmarklet et votre navigateur augmentera la luminosité de toutes les vidéos présentes sur la page, à condition que la page ne verrouille pas les injections de style à l’aide d’une Content-Security-Policy.

J’ai testé sur Firefox et Chrome, dernières versions, sur Mac. Je n’irai pas plus loin et n’assurerai pas le support ; considérez ce petit bout de code comme étant sous licence WTFPL.

Pressé ? Il y a aussi un bookmark pour accélerer votre vidéo Netflix ?

  1. Je joue à « Arkham Knight », de Rocksteady, et c’est une tuerie. Je passe d’excellents moments et je pense énormément à mon ex-collègue Stéphane, auteur génial du célèbre « Batou » que le Joker utilise pour s’adresser à Batman, ce qui donne au jeu une saveur particulière. ↩

  2. Je lis en anglais « The Golden Fool » de Robin Hobb, deuxième tome de la « Tawny Man Trilogy » (en français, le découpage est différent. D’après Wikipédia, je suis en train de lire « Serments et Deuils »), qui elle-même fait partie de la saga « The Realm of the Elderlings » dont j’ai déjà lu les sept livres précédents (en français, cela fait 18 livres). Et je compte bien lire les huit suivant aussi (soit l’équivalent de 17 livres français) dans l’année ! ↩

  3. N’hésitez pas à renommer le favori avec un libellé plus court. Par exemple, j’utilise l’émoji ☀️ (soleil). ↩

Meilleure UX, meilleures performances : la nouvelle donne du web statique

Générateurs de sites statiques, CMS « headless », plateformes d’intégration continue et de déploiement… depuis plusieurs années, une nouvelle gamme de solutions émerge dans le paysage des technologies web. Ces solutions contribuent à une tendance globale qui ressemble à un retour aux sources du Web. On parle de « La mouvance statique » ou de la « JAMStack » mais aucun de ces noms ne caractérise vraiment ce qui n’est pas moins qu’une nouvelle façon d’architecturer des applications web.

De grands rouages métalliques emboités

Aux origines du Web

Note : cet article a d’abord été publié sur le blog de Dareboost (abandonné).

Lorsqu’un utilisateur tente d’accéder à une page Web, son navigateur envoie une requête au serveur qui l’héberge. Soit le serveur retourne immédiatement la page telle qu’elle est stockée, soit le serveur la génère en exécutant du code, à la demande.

Bien que le Web ait été conçu comme un enchevêtrement de fichiers statiques, les langages de programmation côté serveur sont apparus très tôt et sont maintenant largement utilisés. Selon W3Techs, plus de 80 % des serveurs qui utilisent un langage côté serveur tournent en PHP. Dans la mesure où les hébergeurs offrant des serveurs qui n’exécutent pas au moins un langage sont pratiquement introuvables, il y a fort à parier qu’une écrasante majorité de sites web sont aujourd’hui générés dynamiquement.

Pourtant, la génération dynamique de réponses HTTP présente des inconvénients importants en termes de performance web. Une page web dynamique est délivrée par un serveur web, qui charge un langage d’exécution, qui analyse la requête HTTP, interroge souvent une base de données (parfois localisée sur un autre serveur dans le datacenter) et des services tiers, alimente un modèle logique qui se révèle à travers un agrégat de vues pour générer une réponse HTML. Ces opérations prennent du temps, donc logiquement, le Time To First Byte est plus long.

Un graphique Dareboost Dareboost sur lequel on peut voir plusieurs indicateurs. Les pics de TTFB coincident avec les pics de Speed Index.

Un TTFB elevé pénalise le Speed Index d’une page.

Afin d’optimiser les temps de réponse, de nombreuses solutions de mise en cache sont apparues au fil des ans. Avec ces solutions, le premier utilisateur qui requête la page continue de subir le coût de génération mais le résultat est stocké sur un ou plusieurs serveurs proxy et parfois synchronisé sur différents endroits, partout dans le monde. Ces pages « mises en cache » sont ensuite utilisées pour répondre à toutes les requêtes considérées identiques, ce qui assure des temps de réponse rapides et uniformes. Il est possible de trouver des solutions de mise en cache logicielles (comme Varnish) mais également des plateformes et des infrastructures (les Content Delivery Networks). À chaque fois, le principe est le même : transformer ce qui est dynamique en pages statiques. Chassez le naturel…

Mais l’utilisation de contenus statiques présente d’autres avantages !

Si vous voulez livrer vos pages statiques, vous devez les avoir compilées à l’avance. Ce fait, aussi banal qu’il puisse paraître, change tout. En effet, la compilation constitue le principal avantage du statique : déplacer la complexité de l’environnement de production vers le processus d’intégration.

Si vos pages sont servies par un serveur web sans avoir besoin d’être générées à la volée, vous n’avez pas besoin d’exécuter un langage côté serveur. Sans ce langage, de nombreux vecteurs d’attaque disparaissent. On ne peut pas vous voler des données confidentielles en injectant du code malveillant si vous n’avez ni base de données, ni langage d’exécution côté serveur.

Ne pas exécuter de code sur le serveur signifie également que la consommation CPU est très faible pour chaque réponse HTTP, ce qui améliore considérablement votre capacité de montée en charge. Attention toutefois : comme nous le verrons, le déploiement est un facteur clé et peut prendre du temps CPU.

Autre avantage : votre infrastructure sera plus résiliente. Imaginons qu’une erreur advienne, cela serait nécessairement pendant la génération. Vous pourriez alors la détecter avant le déploiement (par des tests automatisés, par exemple). Les problèmes techniques résultant d’une mauvaise contribution n’ont donc plus d’impact sur le site consulté par les visiteurs. Au pire des cas, c’est-à-dire si la compilation échoue, le contenu ne sera pas livré et le contenu du site ne sera pas à jour.

Ces avantages ne sont que la partie visible de l’iceberg. La tendance statique vous permet de transformer complètement la façon dont un site est publié. Pas étonnant que Smashing Magazine ait déjà migré (EN) !

La statique est une modalité de distribution. Quelle est sa stack technique ?

Un générateur de site statique (SSG) est un logiciel exécuté localement ou en tant que service. Il produit (et parfois déploie) un site Web statique en utilisant certaines sources de données pour le modèle et la configuration, ainsi que des templates contenant de la logique métier.

Le marché des SSG est en plein essor, avec un nouveau produit lancé toutes les deux semaines. La plupart d’entre eux génèrent un site Web à partir d’un ensemble de fichiers, souvent écrits avec une syntaxe légère comme Markdown ou Asciidoc. La responsabilité de la conversion en HTML est attribuée à la fois à un moteur de templating (Liquid, Go Template, Nunjucks) - responsable de la logique - et à un moteur de rendu (kramdown, commonmark, blackfriday, Asciidoctor…) responsable de la transformation du balisage en HTML. Les SSG ne sont rien de plus que les orchestrateurs techniques de la génération du site web. Par conséquent, ils sont principalement un terrain de jeu pour les développeurs front-end qui en connaissent les rouages.

En effet, les SSG sont des outils techniques et non des substituts aux CMS. Toutefois, ils deviennent vraiment intéressants quand vous suivez la piste de leur alimentation par des sources de données externes. Parce qu’alors, nous pouvons introduire des CMS qui ne seraient pas utilisés pour le rendu HTML, mais seulement pour stocker et exposer les données. On les appelle les CMS Headless.

Un CMS Headless est constitué :

  • d’un système de stockage de données ;
  • d’une interface CRUD ;
  • d’une API pour accéder au données. « What is a Headless CMS? (EN) », Chris Coyier

Et vous pouvez fabriquer des CMS Headless à partir de vos solutions habituelles. Wordpress, par exemple, a une API REST. Côté Drupal, il y a tout un groupe de travail qui travaille sur le Headless. Là encore, le marché est en plein essor avec de nombreux nouveaux logiciels et services.

Mais pourquoi diable voudrions-nous séparer l’environnement contributif et l’outil de production? Pour une meilleure séparation des préoccupations.

L’équipe de développement, libérée du fardeau de la maintenance d’une base de données, peut se concentrer sur l’évolution technique de la plate-forme et le pipeline de production des ressources statiques tandis que l’équipe de contribution, de son côté, peut affiner les contenus.

Les contributeurs peuvent travailler sur des fichiers plats faciles à stocker et à modifier. Leur seul langage commun avec les développeurs devient les métadonnées passées dans chaque fichier, souvent écrites avec Front-Matter. Ils peuvent utiliser un outil dédié à l’édition ou le service en ligne de leur choix, même certains qui facilitent la collaboration. Ils peuvent également bénéficier du versionning de fichiers pour consulter l’historique de leurs fichiers, fusionner plusieurs versions ou créer des branches pour écrire du contenu qu’ils ne veulent pas publier tout de suite.

Un diagramme des flux de contribution et de développement d'un site qui montre clairement la séparation des préoccuppations entre développeurs et contributeurs.

Le flux de contribution du CMS statique de Carrot (une agence numérique), tel que décrit sur leur blog.

Après la contribution des contenus, la génération du site web et le déploiement sont souvent opérés par le même composant de l’infrastructure. Pour évaluer la performance de cette étape, il faut surveiller la performance du serveur de compilation durant la génération et du déploiement (durée, consommation CPU, mémoire). Mais ce n’est pas tout : pensez à surveiller également l’infrastructure ciblée (composée d’un ou plusieurs serveurs), car les tâches de copie peuvent être gourmandes.

Nous ne sommes plus alors dans un système où la métrique principale de montée en charge est le nombre de visiteurs simultanés. Les DevOps doivent complètement changer leur façon de penser pour créer un système capable de s’adapter plutôt à la fréquence de génération et de déploiement demandée par les contributeurs.

Là encore, de nouveaux acteurs sont apparus. Le plus connu et probablement le plus efficace d’entre eux est sûrement Netlify. Son interface claire et simple aide à rattacher un dépôt de code source en quelques clics. Netlify va ensuite générer et déployer votre site web pour chaque commit, à la volée.

Un CMS Headless, un SSG et un orchestrateur de déploiement : nous avons maintenant notre stack back-end complète. Pourtant, nous produisons toujours un site web statique sans contenu personnalisé. La demande de dynamisme et de personnalisation des utilisateurs n’ayant jamais été aussi forte, ne faisons-nous pas fausse route ?

Statique ? Pas tant que ça.

Nous avons vu que cette stack statique produit un balisage très standardisé. Afin d’introduire du dynamisme et de la personnalisation, nous devrons importer des données – fournies par le biais d’API – et les traiter du côté client – donc utiliser Javascript.

Cette nouvelle stack « JavaScript + API à couplage léger + Markup HTML » a un nom : JAMStack et le marché affiche déjà plusieurs acteurs de premier plan, chacun d’entre eux disposant d’une gamme de services bien spécifique : Stripe pour le paiement, Algolia pour la recherche instantanée, Disqus ou IntenseDebate pour les commentaires, Snipcart pour le e-commerce, Cloudinary ou Twicpics pour la gestion des médias, Formspree ou Staticman pour les formulaires… Notez que tous ces produits ne sont pas conçus pour la JAMStack à proprement parler : vous pouvez parfaitement utiliser les fulgurantes API d’Algolia côté serveur.

JAMStack est un véritable changement de paradigme. Le site Web servi au visiteur devient plus que jamais une coquille dans lequel des services, qu’ils soient auto-hébergés ou tiers, sont dynamiquement injectés. Il est même possible de s’appuyer sur plusieurs services pour un seul objectif et passer de l’un à l’autre en cas d’indisponibilité ou pour maximiser la performance.

Et puisque vous déportez une grande partie de vos efforts côté Front, pourquoi ne pas aller plus loin et le construire avec un framework Single Page App (SPA) comme Vue, Angular ou React ou le transformer en Progressive Web App (PWA) complète, conçue pour être « offline first » ? Rien de tout ça n’est inhérent à la JAMStack, mais facilité par le changement de paradigme de développement.

Pour l’utilisateur, en revanche, la différence est imperceptible. Essayez de rechercher un produit sur ce site. Avez-vous l’impression d’utiliser un site différent par rapport à un site développé en PHP ?

Pour les contributeurs, le changement de paradigme est total puisqu’il sépare la plateforme de contribution de celle qui héberge le site Web, leur laissant une plus grande liberté dans leurs usages. Certains d’entre eux préféreront utiliser des logiciels qui intègrent des outils d’aide à l’écriture (correcteur de langue, suggestions de vocabulaire, intégrations documentaires). D’autres trouveront leur bonheur auprès de plateformes de contribution en ligne. En supposant que le stockage du contenu soit indépendant de la solution utilisée, chacun d’entre eux pourra utiliser son outil préféré sans interférer avec les autres.

Forestry.io editing interface

Interface de contribution de Forestry.io. Les contenus sont sauvegardés dans les fichiers d’un dépôt git et peuvent être également modifiés avec un éditeur de texte.

Mais certains produits vont plus loin et transforment la contribution en expérience de première classe. Les contributeurs peuvent alors bénéficier d’outils de saisie sur mesure, avec des options de contribution riches et une intégration multimédias, sans impact sur le flux de publication ou la performance du site web ciblé.

GIF: Prismic.io slices

Prismic.io est l’une des plates-formes de contenu les plus personnalisables (ici, des « slices » réutilisables). Les contenus comme les gabarits sont contribués sur la plateforme. Pendant la compilation, le SSG requête l’API de Prismic.io pour récupérer les informations.

Statique ou dynamique ? Du pareil au même.

Bien que l’approche JAMStack présente de nombreux avantages, dont la sécurité, la performance, la montée en charge et la manière dont on développe et contribue, elle implique également de nouveaux risques qu’il serait dangereux d’ignorer.

Premier danger : se perdre dans l’offre pléthorique de CMS Headless, générateurs de sites statiques et plateformes de services. Prenez le temps d’évaluer vos besoins car chaque solution a ses avantages et ses inconvénients. Jekyll, par exemple, est un SSG bien connu, développé en Ruby, bien documenté mais assez lent. Hugo, en revanche, est un SSG beaucoup plus rapide mais aussi plus complexe à manier pour un novice. Si vous ne publiez pas du contenu à très haute fréquence, le temps de génération est-il un critère de choix si important, à résultat équivalent ?

Pensez également à inspecter les conditions d’utilisation des services tiers que vous envisagez d’utiliser. Chez Dareboost, nous avertissons souvent nos utilisateurs contre les abus de scripts tiers. Si vous avez besoin de commentaires et utilisez Disqus, acceptez-vous pour autant d’injecter dynamiquement leurs publicités ? Heureusement, si vous avez suivi nos conseils sur les Content Security Policies, vous ne devriez pas vous être trop dérangés 😉.

Un autre risque, et pas le moindre : même si votre site Web est moins sujet aux problèmes de sécurité, il peut quand même être attaqué au travers de ses appels à des API. Vous devez absolument vous assurer que les scripts que vous utilisez n’ont pas été altérés et que chaque échange avec un service tiers est sécurisé via HTTPS. Assurez-vous également que vos API auto-hébergées sont conformes aux bonnes pratiques de sécurité et n’hésitez pas à inspecter minutieusement les garanties contractuelles des services tiers dont vous dépendez.

Enfin, pensez à choisir vos API en fonction de la pérennité des organisations qui les exposent. Si vous transférez la responsabilité de vos fonctionnalités clés à des services tiers, vous feriez mieux de vous assurer qu’ils perdurent dans le temps et maintiennent un niveau de qualité constant. Une bonne façon de surveiller ces services est de recourir à l’exécution régulière de Parcours Utilisateurs qui sont capables de simuler les interactions fonctionnelles avec votre site web.

Un nouvel horizon

Une fois que vous avez bien appréhendé les risques spécifiques et mis en place les workflows appropriés, le JAMStack présente de nombreuses opportunités.

Le coût de migration d’une solution Headless CMS ou SSG vers une autre sont souvent très réduits. Vous pouvez facilement passer d’une contribution locale sur fichiers à une infrastructure de contenu comme Netlify CMS, Forestry, Contentful ou Prismic, ce qui vous permet d’évaluer rapidement la solution qui répond le mieux à vos besoins. Reste que la création d’un site statique prend du temps et nécessite une architecture capable d’orchestrer plusieurs solutions.

Aujourd’hui, cela peut sembler complexe mais rappelez-vous votre premier site dynamique: choisir un hébergeur, maîtriser FTP, jonglez avec les logs du serveur web… ça n’était pas facile à apprendre non plus. Vous découvrirez cette nouvelle façon d’organiser votre projet étape par étape. Pour les utilisateurs expérimentés de la JAMStack, cela devient naturel.

D’autant qu’en dépit du risque de centralisation qu’elles constituent, les plates-formes unifiées comme Netlify offrent un catalogue impressionnant de services : génération et déploiement de sites web, enregistrement DNS, gestion des certificats et formulaires SSL, fonctions lambdas, Content Delivery Network, etc.

De quoi permettre à votre équipe de se concentrer sur le développement du Front-End et l’optimisation des performances Web. Avec un Time To First Byte aussi bas, l’équipe peut pleinement se concentrer sur l’UX grâce à la mesure du Speed Index et la maitrise des interactions utilisateurs.


Mes remerciements à Erin Symons, Frank Taillandier et toute la communauté jamstatic.fr, Bud Parr, Nicolas Hoffmann et mes collègues Philippe Guilbert et Damien Jubeau pour leur temps et leurs conseils.


Ressources additionnelles

Vidéo : optimisez vos MP4 pour de meilleures performances

Le format MP4 représente plus de 75 % des vidéos diffusées sur Internet aujourd’hui. Cependant, il est souvent mal utilisé, ce qui peut dégrader l’expérience utilisateur. Voyons ensemble comment améliorer ça.

Graphique de courbes

Évolution des usages des différents types de formats video sur le Web. Source : Données HttpArchive requêtées via BigQuery.

Note : cet article a d’abord été publié sur le blog de Dareboost (abandonné).

Que vous soyez un acteur du Luxe désireux de diffuser des vidéos de très haute qualité ou une plateforme d’information à la recherche d’une proposition de contenu accrocheuse, la vidéo est devenue en quelques années un élément incontournable du Web. Mais l’ajout d’une vidéo à un site peut être complexe.

L’encodage le plus largement utilisé et supporté aujourd’hui est sans aucun doute H.264, servi dans un fichier MP4. Ce format est supporté par la plupart des logiciels de manipulation vidéo : Handbrake, MPEG Streamclip, OpenShot… même VLC ! Mais peu d’entre eux offrent une fonctionnalité d’export d’une vidéo optimisée pour le Web.

Pourtant, on ne diffuse par une vidéo sur Internet comme on la lit sur un ordinateur de bureau. Il faut faire attention à plusieurs choses.

Capture du logiciel VLC

Interface de conversion de VLC

Note : les exemples qui suivent feront un usage intensif de ffmpeg, l’un des outils de manipulation vidéo les plus populaires parmi les développeurs. Mais la plupart des optimisations décrites devraient être disponibles dans votre logiciel de manipulation vidéo préféré.

Réduire le poids des fichiers: le juste équilibre entre qualité et performance

Une vidéo trop lourde entraînera une augmentation du poids total de la page. Or n’oubliez pas que certains fournisseurs Internet vendent des forfaits dont la bande passante totale est limitée. Rendre vos pages inutilement lourdes ne rendra donc pas service à vos visiteurs.

Pour réduire le poids de votre vidéo, vous devez vous demander comment elle diffuse son contenu sur le réseau. Même si la taille de votre fichier semble déjà raisonnable, il est peut-être possible d’en améliorer le bitrate pour une diffusion optimale.

Qu’est-ce que le bitrate ? Pour faire simple, le bitrate est la quantité de données nécessaires pour encoder une seconde de vidéo. Plus vous allouez de données par seconde, meilleure est la qualité mais plus le fichier est lourd.
Je n’ai pas de formule magique à partager qui permettrait de calculer le bitrate parfait. Je voudrais plutôt vous inviter à vous interroger au cas par cas sur la qualité nécessaire.

Par exemple, vous pouvez évaluer le bitrate nécessaire en fonction des changements brusques présents dans la vidéo : plus le contenu est fixe, moins vous aurez de données à allouer à chaque seconde de la vidéo. À l’inverse, si la vidéo contient beaucoup de mouvement, le débit requis, à qualité visuelle équivalente, augmentera.

Vous pouvez facilement anticiper le poids d’une vidéo après l’encodage en utilisant soit un bitrate constant sur l’ensemble de la vidéo, soit un encodage à plusieurs passes pour un bitrate variable. Voici une comparaison entre un extrait original de 10 secondes d’une séquence du décollage d’Endeavour et un encodage à deux passes avec ffmpeg. La vidéo à gauche pesait 85 Mo, celle de droite pèse 1,2 Mo après optimisation :

Cet exemple montre ce qui peut techniquement être fait pour améliorer le poids d’une vidéo, mais nous pouvons aussi extrapoler des optimisations à partir des objectifs métier de la vidéo. Il est assez courant, par exemple, de visiter des sites dont la page d’accueil affiche une large zone avec un message de bienvenue, occupant l’ensemble de la fenêtre. Parfois, derrière cette zone, qu’on appelle « Hero Container », une vidéo de fond est diffusée.

Ces vidéos ne sont ni destinées à être véritablement visionnées, ni utiles pour la conversion. Il s’agit souvent d’améliorations subtiles, destinées uniquement à embellir les pages et pas à distraire les visiteurs et visiteuses. Souhaitez-vous vraiment que cette vidéo soit de la plus haute qualité possible ? En utilisant un effet de flou comme l’effet « iirblur » de la librairie frei0r (EN) », vous pouvez flouter votre contenu original, ce qui vous permet de gagner de précieux kilo-octets.

Avec ffmpeg :

ffmpeg -i origin.mp4 -vf frei0r=iirblur:0.4 -a:c copy blurred.mp4

L’option -vf frei0r=iirblur:0.4 indique à ffmpeg de flouter avec un coefficient de 40 % tandis que l’option -a:c copy lui indique de garder la piste audio telle quelle.

Résultat :

Autre optimisation possible : la piste audio. Si votre vidéo n’est pas destinée à jouer du son, pourquoi garder cette piste ? N’hésitez pas à la retirer :

ffmpeg -i origin.mp4 -an -vcodec copy muted.mp4

L’option -an indique à ffmpeg de supprimer la piste audio tandis que l’option -vcodec copy lui dit de garder la piste vidéo telle quelle. N’oubliez pas d’expliciter également l’absence de son au navigateur en utilisant l’attribut muted de l’élément <video>.

Même si votre vidéo est légère, votre travail n’est pas terminé. Vous devez maintenant vous concentrer sur le mode de diffusion de la vidéo, qui est assez souvent le streaming.

Démarrer la lecture avant d’avoir téléchargé tout le contenu

Voici comment fonctionne le streaming : lorsqu’une lecture vidéo est demandée, le navigateur va chercher le fichier pour trouver les métadonnées vidéo. Les métadonnées vidéo MP4 comprennent des éléments tels que les caractéristiques d’affichage, l’échelle de temps et la durée. Sans ces informations, le navigateur ne peut pas démarrer la lecture.

Si votre serveur est configuré pour accepter le Service d’Octet, ce qui signifie qu’il a inclus un en-tête Accept-Ranges dans sa réponse HTTP initiale, le navigateur va chercher le fichier morceau par morceau au travers de plusieurs requêtes de contenu partiel (code HTTP 206). Dès qu’il trouve les métadonnées vidéo, il peut démarrer la lecture tout en téléchargeant le reste du fichier.

Capture des ChromeDevTools, onglet "Network"

Dans cet exemple, le navigateur exécute trois requêtes avant d’obtenir les métadonnées et de commencer la lecture.

Si votre serveur ne prend pas en charge ces « Range-Request », le navigateur n’a pas d’autre choix que de télécharger le fichier complet. Si votre vidéo est en lecture automatique, la bande passante disponible pour télécharger d’autres ressources, par exemple celles nécessaires au rendu de la page, sera réduite. Le temps requis pour l’affichage augmentera, ce qui dégradera l’expérience utilisateur.

Où sont stockées mes métadonnées vidéo ?

Un fichier MP4 se décompose en plusieurs unités de données appelées atomes. Les métadonnées sont contenues dans l’atome « movie », également appelé moov. Des logiciels comme MP4creator ou AtomicParsley permettent de visualiser les atomes d’un fichier MP4.

Utilisation d'AtomicParsley en ligne de commande

Dans l’exemple ci-dessus, l’atome moov vient après l’atome mdat (4e ligne)

Il existe plusieurs méthodes pour déplacer l’atome moov en première position. Un logiciel comme Handbrake offre une option « Optimiser pour le Web » (documentation d’Handbrake). Dans d’autres logiciels, cette option est appelée « MP4 Fast Start ».

ffmpeg peut rapidement corriger une vidéo grâce à l’option -movflags faststart, qui exécute une seconde passe et déplace l’atome moov au début du fichier (documentation de ffmpeg):

ffmpeg -i origin.mp4 -acodec copy -vcodec copy -movflags faststart fast_start.mp4

Si vous voulez en savoir plus sur l’atome moov, ne manquez pas « Understanding the MPEG-4 Movie Atom (EN) » de Maxim Levkov.

Des sources multiples pour une performance ciblée

Bien que H.264 soit le codec le plus largement utilisé et supporté, il n’est pas nécessairement le plus efficace à chaque fois. Nous avons déjà vu que la balise <image> accepte plusieurs sources, ce qui lui permet d’offrir des images WebP aux utilisateurs et utilisatrices de Chrome. L’élément <video> peut également accepter plusieurs sources. L’équivalent de WebP pour les vidéos est WebM.

ffmpeg est capable d’encoder des fichiers en WebM, à condition qu’il ait été installé avec l’option --with-libvpx. Voici un exemple d’encodage à deux passes avec un bitrate cible de 1 Mo, en utilisant l’encodeur VP9 (documentation de l’encodeur VP9). Sur Windows, il faut remplacer /dev/null par NUL :

ffmpeg -i source.mp4 -c:v libvpx-vp9 -b:v 1M -pass 1 -f webm /dev/null && ffmpeg -i source.mp4 -c:v libvpx-vp9 -b:v 1M -pass 2 output.webm

À partir de la vidéo optimisée de la navette Endeavour présentée au début de l’article, qui pesait 1,2 Mo, cette commande génère un fichier WebM de 715 Ko, soit une réduction de poids de 40 %. Dommage que WebM ne soit pas plus largement supporté !

Quelques conseils supplémentaires

Faites attention à l’autoplay. Non seulement son usage est perçu négativement par de nombreux utilisateurs s’il n’est pas utilisé correctement (d’une manière subtile et non-bloquante, derrière un arrière-plan par exemple) mais en plus la lecture de la vidéo consomme toujours une certaine bande passante, ce qui ralentit le téléchargement d’autres ressources.

Pour jouer des vidéos en Full HD ou maximiser l’UX, utilisez des solutions dédiées. Il existe une grande variété de solutions SaaS ou en déploiement sur site pour gérer, encoder et diffuser du contenu. Ces solutions, qu’elles soient spécialisées dans la diffusion, la fourniture d’une plate-forme vidéo en ligne (OVP) ou la gestion de contenu vidéo d’entreprise (ECVM), proposent souvent une fonctionnalité appelée Adaptative Bitrate, ou débit adaptatif. Si vous avez accès à un réseau de qualité : la vidéo est claire et les couleurs sont riches. Si votre réseau perd subitement en capacité, la vidéo s’adapte en sacrifiant un peu de qualité, pour préserver la fluidité de la lecture. Pour réaliser ce tour de force, un script JavaScript détecte la bande passante courante de l’utilisateur et le fait basculer dynamiquement entre plusieurs versions d’une vidéo encodée avec différents bitrates, assurant une expérience utilisateur optimale dans n’importe quel contexte. Si vous êtes intéressé, regardez du côté de Brightcove, Kaltura, Qumu, etc.

Souvent, la meilleure solution est de retirer la vidéo. N’ayez pas peur de ne pas afficher vos vidéos dans certaines situations, surtout si elles sont décoratives. Une media-query CSS bien placée protègera vos utilisateurs mobiles d’une mauvaise expérience. Envisagez également de prendre en charge le Client Hint « Save-Data » (EN), une instruction explicitement donnée par le navigateur au serveur pour que ce dernier lui communique une quantité de données réduite.

En résumé

  • Réduisez le poids de vos vidéos en utilisant des stratégies d’optimisations qui dépendent du contenu et de l’objectif de vos vidéos.
  • Optimisez le streaming en encodant vos vidéos de manière à servir les métadonnées au plus tôt.
  • Proposez des alternatives à MP4, comme WebM, qui peuvent être plus performantes.
  • Faites attention à l’autoplay, envisagez des solutions dédiées pour le Full HD et n’hésitez pas à ne pas proposer de vidéos quand le contexte le demande.

Merci à Ravana Renoncé et Rick Viscomi pour leur aide.

Comment différer l’exécution d’un script ?

Les artistes ne sont pas les seul à redouter les pages blanches, les internautes aussi. Leur frustration peut les pousser à abandonner votre site plus tôt qu’ils ou elles ne l’auraient voulu. Pour éviter ça, plusieurs techniques d’optimisation du rendu existent. Comme différer l’analyse et l’exécution des fichiers JavaScript.

Un jeu d'échec avant le début d'un partie. Zoom sur les noirs.

Note : cet article a d’abord été publié sur le blog de Dareboost (abandonné).

Les navigateurs modernes sont conçus pour afficher les pages plus rapidement. Par exemple, ils analysent la page au fur et à mesure qu’elle est envoyée par le serveur, recherchant les URL des ressources qui sont nécessaires pour afficher la page (images, CSS mais plus spécifiquement, fichiers JavaScript). C’est ce qu’on appelle « preload scan » dans Chrome et Safari, « speculative parsing » dans Firefox et « lookahead download » dans Internet Explorer. Cette fonctionnalité permet au navigateur de commencer à récupérer les ressources tout en construisant sa propre modélisation du code HTML, le Document Object Model (DOM) et sa propre modélisation du code CSS, le CSS Object Model (CSSOM).

Dans la mesure où JavaScript est à la fois capable de modifier le contenu HTML et le style des éléments, le navigateur arrête la construction du DOM à chaque fois qu’il récupère un nouveau fichier JavaScript, au cas où. Il attend ensuite d’avoir fini de construire le CSSOM pour exécuter le script. Pendant ce temps-là, comme le DOM et le CSSOM sont la fondation du rendu visuel de la page, le navigateur n’affiche rien tant qu’ils ne sont pas construits.

Dans cet article, nous allons nous intéresser à ce qui peut être fait en JavaScript pour améliorer les délais d’affichage.

Capture de l'onglet Performance des Chrome DevTools. Une chronologie du chargement affiche les différentes étapes en couleurs. Une grande zone jaune est entourée de bleu. La première image n'apparait qu'à la fin.

Même si la construction du DOM (en bleu) se produit majoritairement avant l’exécution du JavaScript (en jaune), elle ne se termine qu’après. Dans cette configuration "par défaut" du chargement d’un script, le DOM est fini d’être construit très tardivement. L’affichage est retardé.

Distinguer JS critique ou non-critique

Pour accélérer le rendu, vous devez décaler au maximum le parcours et l’évaluation des fichiers JavaScript. Facile à dire, plus difficile à faire.

En effet, il y a fort à parier que vos fichiers JavaScript contiennent des portions de code de différents types. Parmi elles, certaines doivent être chargées le plus tôt possible. C’est le cas des portions de JS orientées métier (les analytiques, par exemple), des librairies ayant un impact visuel important ou des scripts tiers que vous ne pouvez pas différer.

L’ensemble de ces éléments constitue votre « JavaScript critique ». Groupez ce code dans un fichier identifiable simplement, nommé communément « critical.js ». Comme pour tout fichier JavaScript, le navigateur devra le récupérer, le parcourir et l’analyser avant d’être en mesure de l’exécuter.

Même si vous appliquez toutes les optimisations connues (nettoyage du code inutile, minification, compression, mise en cache côté client et côté serveur), le navigateur aura toujours besoin de parcourir et d’évaluer le code JavaScript. Comme cette étape prend un temps considérable, vous devez vraiment garder votre script critical.js aussi réduit que possible.

Tous les autres scripts peuvent être retardés, rendus asynchrones, ou déplacés en bas de page. Dans certains cas, vous pouvez leur appliquer plusieurs de ces comportements à la fois. Jetons un coup d’oeil à ces différentes techniques.

Déplacer les scripts non-critiques au bas de la page

Un moyen très simple et intuitif de différer l’analyse des fichiers JavaScript par le navigateur est de placer les déclarations à la fin de la page HTML, juste avant le tag </body>. Ainsi, le navigateur n’aura aucune connaissance des scripts tant qu’il n’aura pas quasiment achevé la construction du DOM.

Bien que cette technique semble convenir à la majorité des cas, elle présente un inconvénient majeur : elle retarde non seulement l’évaluation des scripts, mais aussi leur téléchargement, ce qui exclut son utilisation pour les scripts volumineux. Si vos ressources ne sont pas desservies par HTTP/2 ou ne proviennent pas d’un domaine externe, vous devrez également ajouter un substantiel temps de résolution au temps de récupération déjà important.

Évidemment, puisque cette technique intervient à la fin de la construction du DOM, nous vous recommandons encore une fois de ne pas recourir à des scripts qui utilisent document.write, car le navigateur aurait à le reconstruire complètement.

Capture de l'onglet Performance des Chrome DevTools. Une chronologie du chargement affiche les différentes étapes en couleurs. L'intégralité du bleu est avant le jaune. Une première image apparait très tôt dans le chargement.

En repoussant les scripts en fin de page, la complétion de la zone d’affichage est bien plus rapide mais n’est pas définitive (une partie du contenu est altéré par l’exécution du JavaScript)

Et si on injectait une balise <script> dynamiquement ?

Comme mentionné ci-dessus, retarder le téléchargement d’un script n’est pas toujours une bonne idée. Ce que l’on veut parfois, c’est rendre le script asynchrone : le script est immédiatement récupéré sans que cette phase ne bloque la construction du DOM. Une fois disponible, la construction du DOM est interrompue pour que le navigateur puisse analyser et évaluer son contenu.

Pour obtenir ce comportement, il est nécessaire de ne pas déclarer ce script dans la source de la page, mais d’utiliser un autre script qui l’injecte directement dans le DOM. Cette technique, appelée « dynamic script tag », est l’épine dorsale de la plupart des services tiers.

L’un des principaux avantages de cette technique est que vous pouvez choisir quand le script sera injecté. Si vous voulez l’injecter immédiatement, vous pouvez utiliser une IIFE (Immediately Invoked Function Expression) :

<script>
   (function () {
       var e = document.createElement('script');
       e.src = 'https://mydomain.com/script.js';
       e.async = true; // See the following explanation
       document.head.insertBefore(e, document.head.childNodes[document.head.childNodes.length - 1].nextSibling);
   }());
</script>

Mais vous pouvez aussi retarder l’injection pour qu’elle ne se produise que lorsqu’un événement spécifique est déclenché. Voici comment injecter un script lorsque le DOM est prêt :

<script>
   // IE9+
   function ready(fn) {
       if (document.attachEvent ? document.readyState === "complete" : document.readyState !== "loading") {
           fn();
       } else {
           document.addEventListener('DOMContentLoaded', fn);
       }
   }
   ready(function () {
       var e = document.createElement('script');
       e.src = '[https://mydomain.com/script.js](https://mydomain.com/script.js)';
       e.async = true; // See the following explanation
       document.head.insertBefore(e, document.head.childNodes[document.head.childNodes.length - 1].nextSibling);
   });
</script>

Si vous êtes surpris par l’utilisation d’un insertBefore complexe à la place d’une plus simple appendChild, je vous invite à lire « Surefire DOM Element Insertion », de Paul Irish.

Aussi intéressante que puisse paraître cette technique, elle a aussi ses inconvénients. Tout d’abord, les scripts injectés de cette façon ne sont plus évalués séquentiellement dans l’ordre de leur injection. Vous ne pouvez donc pas y recourir pour injecter plusieurs scripts qui dépendent l’un de l’autre.

Deuxièmement, les balises de script dynamiques ne sont pas totalement asynchrones. Comme expliqué dans l’introduction, le navigateur s’assure que la construction du modèle objet CSS est terminée avant d’exécuter le code JS du script injecté. Le script n’est donc pas exécuté immédiatement. Afin d’expliquer au navigateur que le script peut être chargé sans attendre la construction du CSSOM, vous devez ajouter l’attribut async au script.

Mais attention : un script, même avec un attribut async, est toujours considéré comme une ressource de la page. L’événement window. onload sera donc retardé par son exécution. Si vous avez d’autres scripts qui dépendent de cet événement, anticipez un retard.

Capture de l'onglet Performance des Chrome DevTools. Une chronologie du chargement affiche les différentes étapes en couleurs. L'intégralité du bleu est avant le jaune. Une première image apparait très tôt dans le chargement.

Bien maitrisé, le tag dynamique est une des techniques les plus efficaces avec un DOM construit rapidement et un affichage quasiment immédiat. Attention cependant à l’absence d’ordre d’exécution des scripts !

async, defer, ou les deux

async et defer sont deux attributs standardisés par HTML5. Ils permettent de modifier le comportement par défaut du navigateur lors du chargement d’un script.

Si l’attribut async est présent, alors le script est récupéré aussitôt que possible, puis exécuté. L’ordre de déclaration des scripts async n’est pas préservé: les scripts sont exécutés dès qu’ils sont disponibles. Notez cependant que même si la récupération du script n’arrête pas la construction du DOM, son exécution l’interrompt.

Capture de l'onglet Performance des Chrome DevTools. Une chronologie du chargement affiche les différentes étapes en couleurs. L'intégralité du bleu est avant le jaune. Une première image apparait très tôt dans le chargement.

Ici, à nouveau, un chargement très progressif. En revanche, comme pour le script dynamique, on perd l’ordre d’exécution des JS.

Si l’attribut defer est présent, le script sera récupéré aussitôt que possible, mais le navigateur attendra que l’arborescence DOM soit terminée avant de l’exécuter. Comme la plupart des navigateurs implémentent maintenant un preloader, le comportement d’un script ayant uniquement l’attribut defer est très similaire à celui d’un script placé à la fin du contenu HTML.

Capture de l'onglet Performance des Chrome DevTools. Une chronologie du chargement affiche les différentes étapes en couleurs, les unes sous les autres. On voit l'étape bleu et l'étape jaune se dérouler en simultané.

Cette autre mode de visualisation permet de bien comprendre la simultanéité de l’évaluation du DOM (en bleu) et du script (en jaune). Même si l’exécution du script est plus tardive, c’est toujours ce temps-là de gagné.

Quant à utiliser async et defer ensemble, ce n’est pas très utile, sauf pour un cas d’utilisation, la rétro-compatibilité :

L’attribut defer peut être spécifié même si l’attribut async est spécifié, pour que les navigateurs Web existants qui ne prennent en charge que defer (et non async) tombent dans le comportement defer au lieu du comportement de blocage par défaut. Extrait de HTML 5.1 2nd Edition, W3C Recommendation 3 October 2017, traduit par Boris Schapira

Chargement de fichiers JavaScript : récupérez le contrôle, même sur vos scripts tiers

Nous avons vu que les techniques ne manquent pas quand il s’agit de rendre la récupération et l’exécution des scripts JavaScript asynchrone. Néanmoins, certains scripts ont encore besoin d’être déclarés synchrones comme les scripts de test A/B, qui bloquent parfois intentionnellement le rendu pour masquer le contenu à l’utilisateur jusqu’à ce que le script l’ait personnalisé. Comme ces scripts modifient souvent l’aspect visuel du site, il est censé bloquer le DOM et le CSSOM pendant leur exécution.

Cependant, même dans cette situation, vous n’avez pas à perdre le contrôle. Nous vous encourageons à choisir une solution qui tient compte des performances web. Certains acteurs sérieux comme Google Optimize, Kameleoon ou Optimizely limitent le temps alloué à la récupération et à l’exécution de leurs scripts. En cas de dépassement de cette durée, le navigateur interrompt la récupération ou l’exécution du script A/B. N’hésitez pas à réduire ce délai au minimum pour assurer la qualité de l’expérience de vos visiteurs.

Optimiser les images et réduire leur poids : formats, outils et RWD

« Réduisez le poids de la page » : voici l’un des conseils les plus couramment délivrés dans les rapports Dareboost. Selon les tendances mesurées par HTTP Archive, les images représentent 53 % du poids moyen des pages web, qu’elles soient consultées sur ordinateurs de bureau ou périphériques mobiles. Lorsque vous cherchez à réduire le poids de votre page Web, l’optimisation des images remonte donc logiquement dans le top de vos priorités.

Sur un carré blanc sont disposés plusieurs pixels en camaïeu de bleu, au dessus de la diagonale, de manière progressive

Note : cet article a d’abord été publié sur le blog de Dareboost (abandonné).

À chaque image son format

Il n’est pas toujours simple de trouver le format d’image le plus adapté. Prenons par exemple notre logo. Nous pourrions l’enregistrer en PNG, en JPEG, en WebP ou en SVG. Le poids des images serait très différent. Un test empirique nous permet de le constater :

PNG 6 Ko ; JPEG 38 Ko ; WebP 9 Ko ; SVG 2,5 Ko (1,3 gzippé)

Dans ce cas précis, le format le plus adapté semble être SVG, suivi de près par PNG. Il s’agit en effet d’une image dont les couleurs sont unies, non-animée, représentant des formes géométriques. Autant de facteurs qui tendent à favoriser ces formats.

Prenons un second exemple, avec cette fois la photographie d’une fusée qui décolle. SVG s’avère incapable de représenter cette image correctement (nous expliquerons pourquoi un peu plus loin). Voici ce que nous obtenons, à perception visuelle équivalente, pour les formats JPEG, PNG et WebP :

PNG 171 Ko ; JPEG 33 Ko ; WebP : 13 Ko. Pas de différence notable.

Ici, les résultats sont radicalement différents. Pour représenter toute la complexité d’une photographie, le format WebP se démarque nettement. Malheureusement, il n’est supporté que sur Chrome et Opéra, nous lui préférerons donc souvent le format JPEG.

A savoir : pour chacun de vos tests de performance avec Dareboost, notre outil d’analyse vérifie systématiquement si le format PNG n’est pas utilisé pour des images trop complexes où d’autres formats seraient plus indiqués.

Au moment de l’enregistrement en JPEG, la plupart des logiciels demandent quelle qualité conserver, car il s’agit d’un format d’encodage avec pertes. En choisissant une qualité inférieure à 100%, il est ainsi possible d’économiser de précieux octets en modifiant uniquement certains points de l’image. Essayons avec notre image, en qualité 80%. Le résultat est très intéressant avec un gain de poids de plus de 50%, alors que seuls quelques points de l’image ont été modifiés en profondeur.

JPEG d'origine : 33 Ko. JPEG optimisé : 16 Ko. Entre les deux, très peu de modifications.

Comme les exemples ci-dessus le montrent, choisir un format n’est pas anodin et tous les formats ne sont pas adaptés à toutes les images. Tout cela mérite quelques explications.

Comment choisir le bon format d’image ?

Certes, au final, toutes les images s’affichent à l’écran de la même manière : un rectangle composé de plusieurs points de différentes couleur. Mais ce n’est pas forcément comme ça qu’elle sont enregistrées dans la machine. Et chaque format de fichiers image s’appuie sur différentes techniques d’encodage des informations visuelles.

Que représente mon image ?

Certains formats de fichiers encodent les images de la même manière qu’elle s’affiche à l’écran : comme des matrices de points de couleur. Chaque point de couleur est codé sur plusieurs octets (bits) et positionné au sein d’une carte (map) en fonction de ses coordonnées. C’est pour cela que ces formats sont parfois appelés «  bitmap  ». Divers algorithmes de compression viennent ensuite réduire l’espace pris par ces informations sur le disque. On parle, pour ces formats, d’images «  matricielles  ». Leur avantage : ils peuvent encoder n’importe quelle photographie et certains d’entre eux, comme le format PNG, ont des fonctionnalités avancées comme l’optimisation de la palette de couleurs ou la transparence.

Malheureusement, ce processus d’encodage doit définir en premier lieu les dimensions de la matrice, c’est-à-dire la résolution de l’image, avant d’y positionner les points. Du coup, si vous agrandissez une image matricielle JPG, PNG ou WebP existante, vous perdrez grandement en qualité.

D’autres formats de fichiers n’ont pas ce défaut, car ils encodent les images comme un ensemble de formes géométriques. Ils définissent une image à travers les lignes, les points et les polygones qui la compose. Chaque fois que l’image doit être affichée, l’ordinateur la redessine en suivant cette spécification de dessin virtuel. Ces images vectorielles sont très adaptées pour le rendu des formes simples, des logotypes et des graphiques de données. Comme ils ne sont pas dépendants de la résolution, ils sont particulièrement adaptés aux conceptions Web Responsive. Les images SVG et les polices d’icônes sont des formats vectoriels. Revers de la médaille : les graphiques vectoriels sont assez peu adaptés aux photographies.

Réduire le poids des images en sacrifiant des informations

Il est possible d’aller plus loin dans l’optimisation en acceptant de perdre quelques informations en route. L’enjeu est bien sûr de perdre le strict nécessaire, tout en maintenant un niveau de qualité intéressant. C’est ce qu’on appelle la phase d’optimisation avec perte.

Pour les images vectorielles, svgo est aujourd’hui un outil de référence pour lequel il existe même une interface en ligne : svgomg. L’outil est capable de réduire la quantité de code en nettoyant des métadonnées qui sont inutiles pour l’affichage (par exemple, les informations concernant l’outil qui a servi à générer le fichier) mais aussi en réunissant plusieurs formes géométriques ou transformations qui leurs sont appliquées en une seule. Pour réduire le poids d’une police d’icônes, la logique est la même, à ceci près que vous pourrez également réduire son périmètre d’action en sélectionnant uniquement les caractères utilisés pour fabriquer votre jeu de caractères sur-mesure. Plusieurs sites, comme Icomoon, permettent de créer sa propre webfont.

Comme nous l’avons vu dans l’exemple de la fusée, des optimisations avec ou sans pertes sont possibles également sur les images matricielles. Comme chaque format d’image a ses propres caractéristiques (par exemple, la transparence du support PNG), chaque algorithme a un mode d’action différent et un impact visuel spécifique.

Voici quelques formats de fichiers et certains outils d’optimisation adaptés, dont certains sont inclus dans les outils graphiques comme Photoshop ou GIMP :

  • PNG: Zopfli-png, PNGOUT, OptiPNG, AdvPNG, PNGCrush, PNGQuant
  • JPG: JPEGOptim, MozJPEG, Jpegtran, Guetzli

FileOptimizer (Windows), ImageOptim (Mac) ou Trimage (Linux) sont des logiciels qui réunissent plusieurs algorithmes en un seul endroit. Ils vous permettront de tester ces optimisations avec différents niveaux de perte et exportent directement une image optimisée. Ils sont même capables de déterminer quand une image PNG peut être enregistrée en PNG-8 (une variante de PNG à 256 couleurs seulement) plutôt que PNG-24 pour gagner quelques précieux octets.

Pourquoi ne parle-t-on pas de GIF ?

GIF est un format très contraint (il ne peut décrire que 256 couleurs) qui supporte la transparence et l’animation. Utilisé depuis des années pour encoder des logotypes, des pictogrammes et de courtes animations, il est temps que GIF, disons-le clairement, prenne sa retraite..

Vous pouvez trouver des fonctionnalités estampillées GIF dans tous les réseaux sociaux ou applications de messagerie instantanée, mais ce n’est pas vraiment la réalité. En fait, beaucoup de ces services utilisent des formats vidéos, avec des fichiers bien plus légers ! Nous reviendrons sur ce sujet dans un prochain article.

GIF: Capture des Chrome DevTools où l’on voit une vidéo être jouée comme un GIF et à côté, le code HTML de cette vidéo.

Si vous avez néanmoins besoin du format GIF, sachez qu’un outil de compression en ligne de commande existe aussi : gifsicle. Il peut être très utile pour manipuler les contenus GIF : réduire la palette de couleurs, redimensionner, couper et rogner… J’utilise parfois gifsicle pour encoder de courts enregistrements de mon écran et les intégrer dans des emails, car beaucoup de clients mail ne peuvent toujours pas lire les vidéos intégrées aux emails.

Servir la bonne taille de fichier en fonction du contexte

Choisir le bon format de fichier n’est pas suffisant pour garantir que vous servirez l’image optimale dans tous les contextes d’usage.

Imaginons que vous utilisiez une image d’une largeur de 2680 pixels pour décorer le background d’un site pensé pour une consultation depuis un ordinateur de bureau à écran haute résolution (HiDPI, ex-Retina™). Sur un appareil mobile de plus faible résolution, en 3G, non seulement le navigateur chargera une quantité importante de données superflues mais, pour que l’image rentre dans la largeur du téléphone, il devra également la redimensionner avec son algorithme interne. Le résultat final sera dégradé, sans parler de la vitesse d’affichage… Ce qu’il aurait mieux valu faire, c’est produire plusieurs versions de cette image, dans différentes résolutions et laisser le navigateur choisir l’image à télécharger en fonction de son contexte d’exécution.

On appelle «  Images Responsives  » ces techniques qui consistent à produire, pour la même zone d’une page Web, plusieurs images adaptées aux contextes possibles de navigation. Pour les images d’arrière-plan et décoratives, vous pouvez utiliser les media-queries CSS.

Pour les images non-décoratives, la spécification picture a ajouté, en 2014 (oui, trois ans déjà !), l’attribut srcset à l’élément <img>. Le srcset est une collection d’URLs pointant vers plusieurs versions d’une même image de résolutions différentes (mais toujours le même rapport largeur/hauteur). Il confie au navigateur la responsabilité de choisir la version de l’image à télécharger, en fonction du contexte courant. Malheureusement, sans avoir téléchargé les fichiers CSS de la page Web, le navigateur ne peut pas comprendre l’espace relatif occupé par l’image dans la fenêtre, donc l’attribut sizes doit également être défini.

Si vous voulez proposer, en plus de votre image optimisée, des formats supportés par un nombre limité de navigateurs (comme WebP) ou si vous voulez gérer différents rapports largeur/hauteur en fonction du contexte (une question de direction artistique), vous pouvez encadrer votre image par un élément picture et plusieurs éléments source :

Capture de code

Extrait de code d’image responsive du Guardian

Avec tous les médias possibles, les questions de direction artistique, de tailles, de densité de pixel et de support de formats, le balisage HTML des images responsives peut aboutir à un résultat assez impressionnant. Mais n’oubliez pas que vos réponses HTTP doivent être gzippées. La différence de 500 o entre ce balisage et un simple élément img sera au final largement compensée par le gain sur le poids de l’image servie.

À noter que même si le support des éléments HTML nécessaires est assez récent, une librairie fiable et reconnue permet un support sur des navigateurs plus anciens : picturefill.

Automatiser, automatiser, automatiser

Choisir le bon format d’image, générer des miniatures, utiliser parfois des formats alternatifs plus adaptés suivant le contexte (comme WebP) et donc générer encore d’autres miniatures…

Réaliser manuellement ce travail sur une quantité importante d’images de base de grande qualité relève du titanesque. Très peu d’outils, qu’ils s’agissent des CMS ou des plateformes e-commerce, intègrent des fonctionnalités abouties sur la gestion d’images. Même les solutions de Digital Asset Management, dédiées normalement à la gestion des ressources visuelle et dont cela devrait être une des prérogatives, sont souvent inutiles.

Quelques solutions existent tout-de-même, comme Cloudinary qui est un service tiers accessible en SaaS ou Thumbor, qui s’installe sur un de vos serveurs. Discutez avec votre équipe de développement Web pour déterminer le meilleur outil et n’oubliez pas d’expliquer les problématiques aux contributeurs et de les former à la solution retenue.

N’oubliez pas non plus de toujours conserver les images d’origine (celles qui sont de la meilleure qualité disponible) et de bien réfléchir aux optimisations, notamment avec pertes, que vous souhaitez appliquer.

Par exemple, sur un site e-commerce, les visuels produits sont plus critiques que les images décoratives, donc vous ne voudrez pas perdre trop de qualité. De même, si vous êtes dans le marché du Luxe, vos visiteurs attendent une qualité d’image irréprochable. Il faudra donc être très fin dans la configuration des optimisations. Parfois, comme ce fut le cas chez Flickr, le bon réglage peut prendre plusieurs mois.

Le Lazy Load quand c’est possible (avec ou sans effet visuel)

Une autre façon d’améliorer les performances d’une page Web, consiste à se passer des images inutiles lors du chargement initial. Par exemple, vous pouvez retarder le chargement de toutes les images qui ne sont pas affichées dans la zone visible de la page Web (Lazy Loading). Il y a beaucoup de bibliothèques JS pour faire cela mais toutes ne seront pas compatibles avec votre code existant : demandez son avis à votre équipe de développement ou suggérez-leur une librairie sans dépendance comme Lozad. Une fonctionnalité de Lazy Loading est également disponible sur Apache et nginx : ModPageSpeed Lazyload.

Un des problèmes du Lazy Loading est que la zone dédiée à l’image reste souvent vide jusqu’à ce que, brutalement, l’image apparaisse. Il faut donc déterminer quand et comment charger les images ainsi retardées pour que l’utilisateur soit le moins possible témoin de ce phénomène : après le chargement initial (onload) de la page Web ? Lorsque l’utilisateur fait défiler le contenu et s’apprête donc à rendre visible la zone concernée ? Le Lazy Loading doit être discuté avec les concepteurs UX qui peuvent avoir des idées sur la façon de l’animer pour le rendre moins abrupt.

Certains sites Web occupent la zone de l’image avec un contenu standard aux couleurs de la marque. D’autres utilisent la couleur majoritaire de l’image ou même une silhouette de l’image réelle en SVG.

GIF: Chargement progressif d’images : pendant que les images se charge, une silhouette floue occupe l’espace.

Réduire le nombre d’images avec une pile d’images

Sur les réseaux où la latence est importante, on peut rapidement gagner du temps en réduisant le nombre d’images à télécharger. Plutôt que d’inclure chaque image dans un fichier image séparé, les images peuvent être regroupées dans un seul fichier. Les Sprites d’images sont un exemple de cette technique appliquée aux images matricielles. Les polices d’icônes ou les symboles SVG sont l’implémentation équivalente pour les images vectorielles.

Bien que l’idée soit séduisante, sa mise en œuvre peut se révéler complexe. Utiliser un sprite image est une technique utile si vous utilisez vraiment toutes les images empilées sur la page Web où la ressource est chargée, ce qui est assez rare. De plus, si vous devez remplacer un seul élément de la pile, le sprite entier doit être invalidé dans le cache du navigateur.

Enfin : le problème initial, la latence, n’est pas une fatalité. En HTTP/2, un protocole dans lequel les connexions sont optimisées pour télécharger simultanément plusieurs ressources, la technique perdrait tout son sens. Du moins, en théorie.

Fin ?

Oh que non !

L’état de l’art de la gestion des images responsives est loin d’être parfait. Au lieu d’envoyer beaucoup d’informations au navigateur et lui laisser choisir la bonne image en fonction du contexte, pourquoi ne pas demander au navigateur de passer le contexte lors de la requête initiale puis calculer toute la contextualisation côté serveur ?

C’est ce à quoi réfléchissent certains membres du What Working Group dans la spécification Client Hints. Le support est encore très limité mais le concept est en cours de normalisation à l’IETF. Cela ressemble beaucoup à une initiative du début du début des années 2010, appelée Responsive Web Design + Server Side Components, aka RESS, qui essayait déjà de déporter une partie de la mécanique d’adaptation du contenu côté serveur.

L’essai sera-t-il transformé cette fois ? La gestion des images nous réserve encore bien des surprises !

Fiabiliser les connexions sécurisées avec HSTS (HTTP Strict Transport Security)

Si vous fréquentez [le blog de Dareboost], il ne vous aura pas échappé qu’il est urgent de passer au HTTPS. L’échéance est d’autant plus forte que les géants du Web ont déjà tiré leurs coups de semonce en affichant des alertes sur certaines pages en HTTP dans Google Chrome et Mozilla Firefox. Bientôt, ce seront tous les formulaires qui seront concernés.

Cela étant dit, avoir un site accessible en HTTPS ne suffit pas à basculer l’ensemble de son trafic automatiquement vers cette nouvelle version.

Le long d'un aiguillage ferroviaire, un feu bicolore indique si un train peut passer.
Note : cet article a d’abord été publié sur le blog de Dareboost (abandonné).

Mise en place d’une redirection : une technique qui présente des limites

Une des manières les plus efficaces de rediriger le trafic vers la version HTTPS de votre site est la mise en place d’une redirection permanente (code 301, avec un entête HTTP Location indiquant la page destination). Utilisateurs comme moteurs de recherche visitant le site HTTP seront ainsi redirigés automatiquement vers la version HTTPS.

Cela suffit-il ? Malheureusement non. Car cette redirection ne corrigera pas, pour la plupart des utilisateurs, l’action d’origine les ayant amenés à interroger cette URL non-sécurisée. Certains auront tapé directement l’URL en HTTP, d’autres auront cliqué sur une icône de leur barre de favoris, d’autres encore auront suivi un lien situé sur un site tiers. L’erreur étant humaine, vous n’êtes pas, vous-même, à l’abri de laisser traîner un lien interne en HTTP dans votre site Web HTTPS. Dans tous ces cas, la redirection ne suffit pas à garantir la sécurité du trafic de vos visiteurs et ajoute à la navigation le coût d’une requête supplémentaire, affectant ainsi la performance.

De plus, subir une redirection vers une version sécurisée implique que l’on a d’abord cherché à joindre une page non-sécurisée. Durant cette requête initiale, la navigation est susceptible d’être capturée. Si un individu mal intentionné a accès au réseau de votre visiteur, il sera en mesure d’intercepter le trafic et, pire encore, de le détourner pour acquérir des données de navigation. La liste des situations à risque est longue : bornes Wi-Fi publiques, connexion internet fournies par les compagnies de transport (qui sont parfois les premières à injecter des contenus dans le trafic non-sécurisé), réseau privé compromis, etc.

Que l’on parle de sécurité ou de performance, il est donc nécessaire d’éviter autant que possible cette redirection.

HSTS pour forcer le trafic vers HTTPS

HTTP Strict Transport Security (HSTS) est une directive, dont la spécification complète se trouve dans la RFC 6797. Elle se présente comme un entête de réponse envoyé par le serveur au navigateur lui déclarant que le domaine interrogé est destiné à être visité uniquement en HTTPS.

Le navigateur enregistre l’information et, si à l’avenir l’URL non-sécurisée est interrogée, il effectuera automatiquement une redirection interne (code 307) vers la version HTTPS. Comme HSTS ne concerne que les appels futurs, la mise en place de redirections 301 sur les appels HTTP reste pertinente.

La directive dispose une durée de validité exprimée en secondes dans le paramètre max-age. Une valeur à 300 ordonne au navigateur de mémoriser l’URL sécurisée pendant cinq minutes. Une valeur à 63072000, pendant deux ans.

Il est recommandé d’implémenter HSTS avec une faible durée de rétention, puis d’augmenter progressivement. À chaque étape, attendez a minima le temps paramétré dans max-age puis détectez les requêtes infructueuses et surveillez les métriques de votre domaine. Corrigez les problèmes constatés.

Voici un exemple d’implémentation avec Apache, pour une rétention de 5 minutes :

Header always set Strict-Transport-Security "max-age=300; includeSubDomains;"

Le paramètre includeSubDomains permet de forcer le HTTPS pour l’ensemble des sous-domaines : attention, si certaines de vos ressources sont uniquement accessibles en HTTP, mieux vaut ne pas activer cette option !

En cas d’erreur, sachez cependant qu’un retour en arrière est possible en modifiant votre directive HSTS avec un max-age à 0.

A max-age value of zero (i.e., max-age=0) signals the UA to cease regarding the host as a Known HSTS Host, including the includeSubDomains directive (if asserted for that HSTS Host). RFC6797, Section 6.1.1

Récapitulons. La directive HSTS permet, en complément d’une redirection 301, de sécuriser le trafic futur d’un visiteur pendant une période donnée, sur un contexte de domaine défini (domaine courant ou domaine et ensemble des sous-domaines). Reste toutefois un problème de sécurité : l’accès initial du visiteur à la version non-sécurisée.

Un trafic totalement sécurisé et fiable avec HSTS Preloading

Pour sécuriser davantage l’ensemble du trafic des sites sécurisés, le projet Chromium maintient une liste des domaines « valides HSTS », c’est-à-dire :

  • disposant d’une version sécurisée à l’aide d’un certificat valide ;
  • ayant mis en place des redirections 301 de HTTP vers HTTPS ;
  • dont tous les sous-domaines sont sécurisés ;
  • proposant une directive HSTS (y compris sur la redirection 301) d’une validité minimale de 18 semaines (10886400 secondes) un an (31536000 secondes)1, incluant les sous-domaines et spécifiant l’attribut preload.

Un site éligible pourra alors rejoindre le registre HSTS Preloading embarqué dans Chrome, Firefox, Opera, Safari, IE 11 et Edge. Toute requête non-sécurisée vers ce domaine bénéficiera alors d’une redirection interne (code 307) avant même que ne démarre la requête.

Une capture des Chrome DevTools

Redirection interne lors d’une tentative d’accès à Facebook en HTTP dans Chrome 60.

Attention : contrairement au chapitre précédent, modifier la directive pour revenir en arrière en cas d’erreur de votre part ne suffira pas. Des domaines peuvent être supprimés du registre, mais il faut des mois pour que tous les utilisateurs concernés voient leur navigateur mis à jour avec cette nouvelle liste. Ne demandez donc pas à être inclus à HSTS Preload à moins d’être sûr que vous supporterez HTTPS pour votre domaine et tous ses sous-domaines à long terme.

Protégez vos utilisateurs avec HSTS

La directive HSTS existe depuis plusieurs années. Elle permet de sécuriser le trafic futur de vos visiteurs et, couplée à l’inscription dans le registre HSTS Preloading, de fiabiliser même leur première connexion. Sa mise en place doit être faite avec précaution, car elle impose la sécurisation de l’ensemble des sous-domaines du domaine concerné. Une fois mise en place, elle fiabilise durablement le trafic sécurisé des visiteurs, améliore la performance en supprimant des redirections 301 et, dans la mesure où ce trafic sécurisé est valorisé par l’algorithme de Google, améliore le référencement.

Bonus : avec HSTS Preload, protégez votre domaine des attaques de type SSL strip

Celles et ceux qui suivent l’actualité du Web auront remarqué le danger représenté par Krack Attacks, une démonstration de piratage du protocole WiFi WPA2. Une des étapes de l’attaque consiste, pour le logiciel malveillant, à intercepter les requêtes SSL émises par l’internaute, les réaliser lui-même puis répondre le résultat en HTTP. Un simple instant d’inattention suffit alors pour qu’un pirate s’empare d’informations privées. Si votre domaine est indexé dans la liste HSTS Preload, alors le navigateur refusera de basculer en HTTP pour le visiter, protégeant ainsi vos visiteurs.

Lectures complémentaires

  1. La valeur était de 18 semaines lorsque j’ai écrit l’article. Elle a été repoussée à une année entre le 11 et le 16 octobre 2017. Merci à @Thibault_Walle de me l’avoir signalé en commentaire. ↩

Enfermés dans un sous-sol

Alors que je m’apprête à tourner une page professionnelle, je ressens le besoin de partager des anecdotes de ma vie de consultant. Celle-ci, rétrospectivement, me fait rire. Mais je faisais moins mon fier en 2011…

Ce projet e-commerce était relativement simple mais la stack technologique choisie par le client en amont du projet était peu mature. Bien que les langages utilisés soient robustes, le projet reposait sur des solutions récentes qui n’avaient jamais, ou très peu, été confrontée à la réalité du terrain.

Nous n’avions jamais travaillé sur ces solutions donc nous avons décidé de monter rapidement en compétence en incluant dans l’équipe des sous-traitants expérimentés. Durant la réunion de lancement, le partage des tâches avait été acté. Certaines composantes du projet, notamment liées aux responsabilités légales et bancaires, restaient à la charge du client.

Tomber et se relever

Plusieurs mois plus tard, force est de constater que nous avions tous été trop ambitieux.

Le recrutement de personnes expérimentés ne s’étant pas passé comme prévu, nous avions perdu trois semaines sur le planning de développement. Le client n’avait pas encore souscrit de terminal de paiement, donc nous ne l’avions évidemment pas intégré. L’éditeur de la solution, enfin, ne corrigeait les bugs remontés que dans les nouvelles versions majeures, nous obligeant à migrer plusieurs fois ce qui n’était pas évident dans la mesure où d’autres projets étaient installés sur les mêmes serveurs et ces migrations entrainaient des incompatibilités.

Bref, nous avons dépassé la date de livraison initialement prévue.

Réunion de crise, toutes les parties actent l’échec et s’accordent pour se donner un mois, manches relevées, pour corriger le tir. L’éditeur redescend ses correctifs sur notre version, le client accélère la commande du TPE, nous embauchons un sous-traitant supplémentaire sans discuter le tarif. Un mois plus tard, au lendemain de la souscription du TPE, le site est en ligne.

Un rendez-vous mystérieux

Quelques semaines plus tard, mon commercial et moi recevons une invitation pour discuter des fonctionnalités du prochain lot. L’adresse est inconnue, sur Paris, et le rendez-vous est, de manière surprenante pour ce type de réunion, programmé très tôt. Je prends le train la veille pour être sûr d’être à l’heure. Tandis que Paris s’éveille, je rejoins mon commercial devant les locaux d’une très grande structure de banque-assurance française qu’on appellera DUPONT.

Nous attendons notre interlocuteur quelques minutes. Il arrive dans la hall avec trois autres personnes que nous n’avions jamais croisées auparavant, puis nous emmène dans une petite salle de réunion, au deuxième sous-sol. Nous nous installons silencieusement. Notre contact chez le client nous lance des regards inquiet. Je comprends qu’il n’est pas à l’initiative de ce qui va se passer et que quelque chose cloche.

Un des trois hommes nous tend une feuille.

Avant de parler des nouvelles fonctionnalités à développer, nous allons faire un rétroplanning du projet.

Sur la feuille sont reprises toutes les principales dates du projet. En face de chaque date se trouve un commentaire nous inculpant :

xx/xx/XXXX : élement non livré, échéance non respectée xx/xx/XXXX : élément non livré, échéance non respectée

Je suis abassourdi.

D’une part, la plupart des éléments listés n’étaient pas de notre responsabilité. D’autre part, nos retards allaient de pair avec d’autres, en dehors de notre champs d’action. Même si nous avions livré notre code plus tôt, le client n’aurait toujours pas souscrit son TPE et nous n’aurions pas mis en Production. Mon commercial, rouge de colère, se tient à deux mains au dos de sa chaise, crispé, dents serrées. La situation est inédite et incroyable.

Un autre homme embraie :

Nous sommes avocats spécialisés, détachés par DUPONT pour aider votre client à faire valoir ses droits. Nous souhaitons un nouveau lot de développement et vous allez le réaliser gratuitement.

Hors de question. Mon commercial exprime son désaccord d’un calme ardent. J’explique pour ma part que ce document n’a aucune valeur. Nous n’avons jamais enfreint nos obligations d’information et de conseil.

— Là n’est pas la question. Nous avons les moyens de faire couler votre entreprise et nous le ferons.
— Vous seriez prêts à mettre 120 personnes sur le carreau ?
— Oh, vous savez, dans l’informatique, vous retrouverez vite un emploi.

J’en eus froid dans le dos. C’en était trop pour mon commercial qui se leva, menaçant, et m’ordonna de faire pareil. Merci, au revoir, le temps que je comprennes ce qui s’était passé, nous étions déjà dehors, en route vers le métro. J’étais encore sous le choc.

— Tu crois qu’ils peuvent faire ce qu’ils ont dit ?
— Non, aucune chance. Ils sont juste aux abois parce qu’ils ne doivent plus avoir d’argent.
— Je ne comprends pas.
— Ils doivent avoir un partenariat avec DUPONT. Comme ils n’ont plus de fonds, ils ont dû demander à DUPONT de faire pression pour voir s’ils pouvaient obtenir quelque chose. C’est un mouvement stupide : nous ne développerons rien de plus. Ils peuvent toujours se brosser pour avoir leur nouveau lot.

On n’a jamais entendu parler d’eux à nouveau. Le site n’a jamais connu d’évolutions ou de nouvelle contribution. Le pied de page mentionne toujours un copyright en 2011…

Évaluations

[…] enseigner en école était de loin l’expérience de transmission la plus contre-intuitive, et donc la plus fascinante pour moi.
« Enseigner le développement web à 85 étudiants sans s’arracher les cheveux ✌️ », Adrien Joly

Adrien écrit avec beaucoup de justesse ce qu’il a appris en enseignant. Son article donne envie d’en savoir plus et je ne peux pas m’empêcher d’y entendre des échos de ma propre expérience.

Quelle que soit la taille de la classe (de 8 à 40 élèves), le type de cursus (en temps plein ou en alternance) ou l’année d’enseignement (de BAC+1 à BAC+5 ou auprès de professionnels en formation continue) :

  • même si on veut tous être Robin Williams, il est difficile de se passer de réaliser un enseignement classique avec des cours magistraux ;
  • les élèves ne sont souvent pas, ou mal, formé à la prise de notes. Elles et ils se dispersent très vite sur les réseaux sociaux si on leur en laisse l’occasion ;
  • être né avec Internet ne signifie pas savoir s’en servir, ou avoir le recul pour comprendre et mettre en perspective ce qu’on y lit. Il faut donc reprendre tout ce qu’on considère soi-même comme une base ;
  • le cours et les exercices ne suffisent pas : les élèves ont besoin de supports. Adrien fournit son cours. Je le fais aussi, a posteriori, en ligne. Je me rends compte, cependant, que la plupart du temps ce sont les supports de TD qui sont les plus demandés. Les élèves sont parfois d’apprentis artisans : elles et ils ont besoin de répéter pour acquérir la mémoire du geste.

Mes expériences

J’ai enseigné, ces dernières années, plusieurs matières. En vrac : ASP.NET ; le développement Windows Phone ; le Lean Canvas ; l’introduction aux CMS .NET et PHP ; le PHP ; les SGBDR via l’usage de MySQL ; le framework Symfony ; le RWD ; la gestion de projet CMMi ; la gestion de projet Agile ; l’accessibilité Web ; le versionning avec git et, une première cette année, l’obtention de la certification Opquast.

Au fil de ces cursus, j’ai tenté différents types d’évaluations qui me permettent de remplir mes obligations de prof (« une note toutes les trois heures »).

Des QCM « rigoureux »

  • succès binaire (pas de ½ ou ¼ de points) ;
  • des questions liées entre elles (si l’élève ratait une question mais en réussissait une autre sur le même sujet, je ne mettais aucun point, considérant qu’il s’agissait de chance)

C’était le type de questionnaires avec lesquels j’avais été moi-même formé en cursus d’ingénieur ESIEE. J’ai rencontré un franc échec avec des notes très basses et un très faible écart type (comprendre : c’était une vraie boucherie). J’ai rapidement arrêté.

Des TP notés avec la connaissance du sujet en amont

J’ai proposé cela une année, sur la base d’un exercice non-corrigé que j’avais contribué sur Traindrop. Le résultat ne m’a pas satisfait : les disparités entre les élèves ne représentaient pas leur niveau mais plutôt :

  • leur disponibilité : les élèves occupés par une activité autre (par exemple, de l’entrepreunariat pour payer l’École ou leur loyer) n’avaient pas autant de temps à consacrer au projet ;
  • leur capacité à s’organiser en groupes sociaux : les élèves constitués en groupes soudés s’échangaient les réponses (ce qui était assez facile à voir une fois leur code passé dans mon Sonar1). Les élèves plus isolés n’avaient pas accès au même niveau d’informations. Ils trichaient moins mais avançaient moins vite ;
  • collectivement : leur faible investissement sur le projet (parfois, même les points vus en cours n’étaient pas traités).

Des rédactions (oui, oui)

Vous postulez chez { insérer ici une société au site plus ou moins adapté à la navigation sur mobiles ou tablettes }. La responsable vous demande de rédiger vos recommandations argumentées sur les pistes d’amélioration que vous envisagez sur le Front du site web. Vous soulignerez les problèmes identifiés, les solutions possibles et les modalités de la direction de projet qui en découlent.

J’ai proposé un sujet de ce type deux fois. La première fois, j’avais pas loin de 35 élèves et j’ai mis trois mois à corriger. Donc premier point : envisagez d’avoir du temps et une grille de notation posée en amont avant de vous lancer dans la correction.

L’examen, s’il est très instructif, présente également ses limites : les élèves ne sont pas rompus aux usages de la communication en entreprise. Ils se perdent souvent dans les circonvolutions d’un niveau de français soutenu plutôt que d’aller à l’essentiel. Au final, j’ai moins pu juger du niveau de compréhension des élèves que de leur niveau de synthèse. L’exercice reste pertinent, mais trop consommateur de temps de correction pour être pratiqué à grande échelle et doit être complété par d’autres modes d’évaluation.

Mes modes d’évaluations favoris

Aujourd’hui, j’évalue souvent les élèves avec des QCM faciles mais réguliers. Google Forms2 est très pratique pour ça, puisque depuis cette année, on peut pré-affecter des points aux questions. La correction est ainsi immédiate.

Je demande aux élèves de pratiquer une veille sur le sujet en cours. Je leur impose un ou plusieurs oraux « de veille ». Elles et ils doivent choisir une source de leur choix (je fournis des références pour les moins à l’aise) et la présenter au reste de la classe en cinq à dix minutes : auteur, contexte, objet, critique, pistes de lecture pour approfondir… Chaque présentation est, en général, suivie d’une série de questions et réponses pour encourager la curiosité et l’esprit critique des élèves. Je n’organise pas de tours de passage mais je préviens en amont que ma notation sera dégressive : les premiers à passer auront facilement plus de 18/20 mais que j’attends de chaque nouveau passage qu’il ait au moins le même niveau d’analyse que le précédent, voire qu’il aille plus loin. Le dernier à passer aura donc beaucoup plus de travail à fournir pour avoir une bonne note.

Quand nous profitons de plusieurs jours consécutifs sur le même sujet, nous basculons en mode projet. Comme tout est fait pour assurer aux élèves une grande autonomie (je pilote les apports pédagogiques en affectant tel ou tel ticket à une équipe qui n’aurait pas abordé la notion en question), j’en profite pour mener en dehors de la classe des interviews en face-à-face, pendant lesquelles je tente d’évaluer la compréhension de l’élève.

Enfin, nous pratiquons des évaluations pratiques en pair-à-pair pour lesquelles j’applique le protocole suivant :

  1. toute la classe découvre le sujet ;
  2. nous élaborons collectivement les critères objectifs qui constituent la grille de notation. Idéalement, chaque critère ne doit pas être noté sur plus de deux points ;
  3. les élèves traitent l’énoncé ;
  4. nous faisons passer les « copies » (souvent, les fichiers) vers les correcteurs (affectés aléatoirement) et l’évaluation a lieu. Les élèves me l’envoient par e-mail ;
  5. j’évalue a posteriori et compare mes notes aux notes envoyées par les élèves. Quand ma note diverge fortement, j’écris une réponse au correcteur pour qu’il sache pourquoi.

Idéalement, il faudrait le faire deux fois : la première fois, les élèves prennent conscience de la difficulté que représente une notation. Ils se rendent compte qu’on ne note pas entre 10 et 20, mais bien entre 0 et 20, et que sortir de la zone située entre 8 et 12 sur 20 est difficile.

En réalité, nous sommes souvent limités par le temps que cela consomme sur le volume d’heure du cursus. Cependant, je note toujours une différence de comportement après l’exercice. Il n’y a rien de plus difficile que de noter objectivement un ou une camarade.

Et vous, comment notez-vous ?

  1. SonarQube est un outil d’inspection continue de la qualité de code. Je m’en sers surtout pour sa fonctionnalité de détection de code dupliqué, qui permet de découvrir assez rapidement les « petits raccourcis » que prennent des étudiants en « s’empruntant » du code. ↩

  2. Je serais ravi d’utiliser un autre service que Google pour cet usage. Je surveille les évolutions de FramaForms pour, justement, me défaire de cette dépendance. ↩

Où est le WeChat occidental ?

Il devient de plus en plus évident que la Chine est train de changer la façon dont Internet intègre le quotidien. Ce changement a un nom : WeChat. Quel impact pour le Web en occident ?

Note : cet article a d’abord été publié sur le blog de Clever Age.

WeChat réinvente les usages du Web

WeChat n’est pas un réseau social comme un autre, c’est un point de connexion avec les services qui entourent l’utilisateur : découverte de produits, dialogues en B2B, B2C ou C2C, prises de rendez-vous, informations, paiement… les possibilités sont assez larges et c’est bien normal : l’application agit comme un centre regroupant de multiples services, des micro-applications, qui proposent chacune des services spécialisés simples à identifier. Pour résumer, WeChat est un centre de services s’exécutant au dessus du système d’exploitation de l’appareil mobile.

Pourquoi n’a-t-on pas la même chose en Occident ?

Facebook n’est pas à sa première tentative, sans que la magie n’opère, car les réponses à cette problématique sont nombreuses.

D’abord notre marché est plus contraint. Bien que la Chine soit limitée dans son accès au monde extérieur par la présence du Great Firewall1, son marché intérieur est assez, voire très libéral. La protection de la vie privée y est balbutiante, les normes de contrôle très réduites et les réglementations laxistes, quand elles existent (au contraire de l’Union Européenne, qui suis exactement le chemin inverse)2.

Autre élément de réponse : les barrières à l’entrée constituée par les App Store. Le système de rémunération applicatif d’Apple, mis en place il y a près de 10 ans et copié par Google pour Android, est aujourd’hui très bien implanté et génère plusieurs milliards de dollars de revenus. Il offre aux éditeurs la possibilité de commercialiser leur production et d’inclure des modalités d’achat à la volée au sein de l’application via des App Stores. Le gestionnaire de l’App Store assure la rotation de l’offre, la cohérence de l’expérience utilisateur et touche une commission.

La rigidité des App Store

Le système des App Store, aussi satisfaisant qu’il soit, atteint ses limites. Il noie l’utilisateur sous une offre pléthorique qui manque de contexte. Le nombre de Stores alternatifs explose dans un certain nombre de marché émergents, où l’on trouve, par exemple, des Stores offrant des applications adaptées à des matériels bas de gamme sur lesquelles les applications « classiques » ne tournent pas.

Une main tenant un téléphone de face. On y voit de nombreuses applications Android listées dans un menu.

La découverte des services est également problématique sur un système centralisé de ce type. En regroupant l’offre d’applications, les App Store la rendent moins contextuelle, moins locale, moins ciblée. La découverte d’applications est alourdie et la proposition de service est, in fine, moins efficace. WeChat fonctionne mieux en proposant des services locaux, basés sur l’utilisateur et son réseau. Plutôt que de chercher dans un App Store, il est courant que les utilisateurs de WeChat scannent directement un QR Code qui leur donne accès au service dont ils ont besoin immédiatement.

L’alternative est déjà dans votre poche

Comment égaler l’application WeChat ? C’est déjà (presque) fait. Nous disposons déjà d’applications capables d’en héberger d’autres, de créer des interconnexions entre services et contenus Web, d’offrir des services sans passer par les App Store et les contraintes qu’ils imposent. Vous pensez à Facebook ? Raté. Je parlais de nos navigateurs.

Google, fort de la position hégémonique de son navigateur Chrome, a pris le train en marche en adhérant massivement aux applications web « comme des vraies », allant jusqu’à inventer le concept de Progressive Web App, quitte à disrupter son propre modèle économique là où Apple freine encore des quatre fers. Alphabet, sa maison-mère, a en effet compris comment faire des PWA des applications à part entière, y compris au niveau de l’expérience utilisateur (Twitter Lite, par exemple, est une version PWA de Twitter qui n’a pas grand-chose à envier à l’application native).

Vers la fin des App Store ?

Même en prenant en compte ces possibilités, la disparition des App Stores poserait encore certains problèmes :

  • disparition de la « présence de marque », c’est-à-dire de la capacité pour les utilisateurs de retrouver leurs marques préférées dans un annuaire de services ;
  • absence d’un module applicatif donnant les mêmes capacités de paiement à une PWA que ce qu’on trouve sur un App Store.

Rien de plus facile, pour Apple ou Google, que de transformer leurs annuaires applicatifs en annuaire de PWA. Ils pourront garder des mécanismes de contrôle automatisé de la qualité (comme Lighthouse) mais déléguer le rôle de répertoire aux éditeurs.

Quant aux QR codes, qui ne recontrent pas nécessairement leur succès en occident, il y a fort à parier pour qu’ils soient complétés par d’autres modes de découverte : géo-localisation fine, conciergerie numérique plus ou moins intégrée à un système de Chat Bots… des sujets sur lesquels Google est également en pointe avec Google Now, Google Allo…

Reste enfin le sujet du paiement

Géraldine aime la course à pieds, et voudrait commencer un suivi précis de ses trajets de course. Ne sachant pas quelle application installer, elle fait une recherche sur Google et trouve un site spécialisé.

À sa troisième visite, son navigateur lui signale que le site est disponible en tant qu’application, et lui propose de l’installer, ce qu’elle fait. Au sein de cette application, elle trouve un outil de suivi des trajets qui correspond à ses besoins.

Quelques mois plus tard, l’application lui signale qu’en analysant ses données de courses, elle a détecté une chance assez importante de foulée supinatrice et lui propose, en partenariat avec une grande marque de sport, de nouvelles chaussures de courses adaptées. Géraldine procède au paiement dans l’application, qui utilise sont profil Google pour récupérer ses coordonnées postales et bancaires, sans aucune friction.

Une personne fine est assise sur le sol, en tenue de sport. L'objectif se focalise sur sa chaussure droite, qui semble être une chaussure de running.

Un scénario mêlant Web, application et achats de manière transparente pour l’utilisatrice.

Ce sujet va cristalliser l’avenir du Web ces prochains mois, voire ces prochaines années. C’est un des sujets d’études « chaud » du W3C. Les PWA seront rapidement le cheval de Troie de librairies proposées par les éditeurs de systèmes d’exploitation pour faciliter et encadrer le paiement en échange d’une commission, sur la base d’un standard comme la Payment Request API. Le marché est conséquent et la lutte sera féroce avec d’autres acteurs qui n’ont pas l’intention de se faire damer le pion.

Il n’est pas impossible que Google attaque ce marché par le biais d’AMP3 : en entrant par la porte de la performance Web, cette alternative à HTML est une façon détournée de prendre le contrôle du Web et de ses processus de développement économique (s’assurant au passage de meilleures capacités d’indexation, à des coûts plus faibles, ce qui ne fait pas de mal quand la donnée est la matière première de son business et que la bande passante est un de ses plus gros centre de coût). Le paiement est d’ailleurs en bonne position dans la feuille de route.

Autant d’indices concordant laissant à penser que les PWA s’intégreront progressivement à l’offre applicative de Google Play.

TL;DR : Google est sur les rails, et il va vite

WeChat révolutionne le Web et le mobile en Chine mais la transposition de son modèle en Occident n’est pas triviale. Beaucoup s’y sont essayé (à commencer par Facebook) sans y parvenir. Il y a fort à parier que la pression chinoise amorce une nouvelle évolution logicielle du Web, par le biais des navigateurs, des PWA, des moteurs de recherche et de la conciergerie de services géo-localisée, quatre domaines dans lesquels Google (Alphabet) excelle aujourd’hui.

Cette nouvelle révolution ne pourra pas se produire sans de vraies avancées concernant la standardisation des modalités de paiement, un sujet sur lequel le W3C travaille activement.

  1. Dont nous parlions dans notre article « S’implanter en Chine : état des lieux ». ↩

  2. Nous en parlions plus en détails dans notre article « Réglement Général sur la Protection des Données Personnelles : petit guide pour les entreprises ». ↩

  3. Lire à ce sujet : « AMP Project booste le chargement des pages web » ↩

À l’aventure

J’ai tourné et retourné dix fois la manière dont j’allais écrire ça, mais je n’arrive pas à trouver « la » bonne manière. Tourner une page de sa vie n’est jamais facile…

Des fourmis dans les pieds

Ça faisait longtemps que nous avions envie de bouger. Début 2015, nous avions pensé à l’Australie, où ma belle-sœur et d’anciens collègues partaient vivre. Le Canada nous bottait bien aussi. Nous cherchions un endroit où parler anglais, parce que nous le parlons tous deux assez bien (enfin, pour des français) et que nous avions besoin de voir autre chose.

Petit à petit, nous avons fait le deuil de cette aventure. Mon fils aîné a eu besoin d’un accompagnement plus poussé au niveau orthophonique comme au niveau psychomoteur : ajouter un déracinement aurait probablement été trop difficile pour lui et pour nous. Nous avons oublié nos projets et nous sommes investis encore plus dans nos emplois respectifs (oui, nous sommes tous les deux comme ça).

Fin août 2016, j’ai su que Clever Age rachetait X2i, une entreprise toulousaine. J’en ai parlé à ma femme et nous nous sommes dit que c’était peut-être une opportunité à tenter : l’occasion de se déplacer sans aller trop loin, de trouver facilement l’accompagnement nécessaire pour notre grand garçon, sans que nous soyons obligés de quitter tous les deux nos emplois.

L’idée faisait son chemin depuis quelques semaines quand elle décida d’en parler à son employeur. Elle voulait être honnête, lui dire qu’elle avait besoin d’un nouveau souffle professionnel. Par un jeu de circonstances, ce jour-là, elle est revenue du travail en m’expliquant qu’elle avait, à son tour, entendu parler d’une opportunité interne. Du genre qu’on ne laisse pas filer. Quelque chose de difficile, d’ambitieux, quelque chose pour lequel il faudrait que nous nous investissions ensemble, acceptant de faire des concessions. Quelque chose d’important pour elle. Quelque chose… à quinze minutes au nord de Périgueux.

Angoisses et doutes

J’ai toujours été intéressé par ma carrière. J’ai fait ce qu’il fallait pour avoir de grandes entreprises sur mon CV, pour travailler dans les contextes les plus délicats et montrer ma capacité d’implication. Si nous saisissions cette opportunité, il fallait tirer un trait, au moins temporaire, sur tout ça. Son travail risquerait de lui prendre beaucoup de temps, y compris parfois le soir et le week-end. De mon côté, il était donc nécessaire que mes horaires soient plus réguliers, que je limite mes déplacements professionnels, que je quitte mon équipe bordelaise, que j’arrête de donner des cours à l’ECV…

Il a fallu quelques mois pour que les enjeux relatifs à son potentiel nouveau poste se précisent. J’étais à la fois très excité à l’idée de passer un peu plus de temps avec mes garçons mais aussi très angoissé, au point de m’en réveiller parfois la nuit. J’avais peur de ce qui se passerait si je perdais le sentiment d’accomplissement que me procure mon emploi, la manière dont ma communauté me regarderait si je n’étais plus « Boris, de Clever Age ». Et être le parent sur lequel repose en grande partie la logistique familiale est très difficile. C’est peut-être le truc le plus difficile au monde… tout en étant le moins gratifiant.

J’étais emballé et très fier de ma femme mais j’avais peur.

L’égoïsme de l’homme

Début mars 2017, Sébastien Dugué, le responsable de l’agence Clever Age de Bordeaux, est venu me parler de mon très prochain entretien annuel. Il m’a laissé entrevoir une nouvelle opportunité de faire encore davantage de conseil — une des missions dans lesquelles je me réalise le plus aujourd’hui (en liaison avec Olivier Martinerie) à Paris. Un tiraillement de plus dans une décision qui n’était déjà pas facile !

Ce soir-là, je me suis levé vers 1h et ne me suis pas recouché avant 5h. Je me rappelais les deux grossesses de ma femme et des doutes que j’avais lu dans ses yeux : serait-elle la même quand elle reviendrait au travail ? Serait-t-elle aussi « capable » ? Lors de la deuxième grossesse, elle était au chômage. S’ajoutait donc aussi un questionnement personnel sur son projet professionnel et l’angoisse de tirer notre foyer vers le bas en ne ramenant pas d’argent alors que nous avions bientôt une bouche de plus à nourrir.

Je me suis rappelé de nos conversations de l’époque, sa propre angoisse. J’ai soudain réalisé tout le ridicule de mon dilemme : ce que je ne voulais pas vivre, qui me faisait peur au point d’être parfois inacceptable, ma femme l’avait déjà vécu deux fois, avec courage, sans que cela n’handicape son potentiel professionnel.

Un bol en céramique parsemé de jointures d'or qui laissent paraitre qu'il a été au préalable brisé

Un exemple de kintsugi. Au lieu de cacher les cicatrices d’un objet brisé ou fragilisé, le kintsugi les valorise. Au lieu de n’avoir qu’une existence dans l’instant, l’objet s’enrichit d’une histoire qui raconte ses faiblesses et le rend unique.

Trois jours plus tard, décidé, je suis allé voir Sébastien pour lui remettre une lettre.

Objet : Démission

Cher Sébastien,

Je te présente officiellement, par ce courrier, ma démission du poste de CONSULTANT que j’occupe chez Clever Age depuis le 15 janvier 2010.

J’ai bien noté que les termes de notre convention collective prévoient un préavis d’une durée de trois mois. Cependant, j’aimerais prolonger ce délai jusqu’au 31 juillet 2017. J’espère que cela facilitera la transition et offrira suffisamment de temps pour trouver des remplaçants sur l’ensemble des missions que j’assure aujourd’hui pour l’entreprise.

Je profite de cette lettre pour te renouveler, ainsi qu’à Clever Age, mes remerciements pour les opportunités qui m’ont été offertes pendant toutes ces années à Bordeaux et ailleurs en Europe, le cadre de travail de l’agence bordelaise et la confiance que tu m’as témoigné et me témoigne encore dans l’accomplissement de mes missions.

J’ai ensuite appelé Olivier, pour le remercier également de l’opportunité que je venais de refuser. Enfin, j’ai laissé un message sur le répondeur de Frédéric Bon, le Président de Clever Age. Ce fut la demi-heure ma plus longue depuis la naissance de mon fils aîné et probablement un des moments de ma vie où j’ai dû faire preuve du plus de détermination. Plusieurs mois plus tard, j’ai encore une grande émotion en l’écrivant.

Et la suite ?

Depuis mars, je continue bien sûr à travailler pour Clever Age dans le cadre de mes missions mais je prends aussi du temps, pour préparer mon départ et veiller à ce qu’un certain nombre de choses que j’y faisais se déroulent, comme elles doivent, sans moi. On ne peut pas passer sept ans à expliquer à ses clients que la réversibilité est une valeur capitale et partir ensuite comme un voleur. J’ai démissionné de mon rôle de Délégué du Personnel, j’ai passé les rênes du blog de veille à une de mes collaboratrices les plus rigoureuses et, petit à petit, je transmets la gouvernance de mes projets à d’autres, en occupant des tâches à moindre responsabilité.

Je n’ai pas encore cherché d’emploi sur Périgueux, mais cela ne m’a pas empêché d’être curieux sur les entreprises implantées là-bas et, plus globalement, en Dordogne. J’ai également suivi deux ateliers au Node sur la fixation des prix et le développement d’une activité d’entrepreneur « au cas où ». Autant profiter de ce que Bordeaux peut offrir de meilleur tant que j’y suis encore.

L’isolation géographique ne m’inquiète pas. J’ai, depuis longtemps, pris conscience que mon identité était indissociable du Réseau et que je serais un peu chez moi partout, tant que j’aurais une connexion. Que les gens soient physiquement proches de moi ne renforce pas mes relations avec eux et mes amitiés les plus sincères sont virtuelles.

Une forêt

par Nejc Košir (<a href="https://creativecommons.org/publicdomain/zero/1.0/deed.fr" title="Description de la licence Creative Commons 0">licence CC0)

Sept ans, c’est long. Il restera sûrement toujours un peu de Clever Age en moi, cette entreprise dans laquelle je me suis tant investi et qui me l’a bien rendu. Mes collègues bordelais me manqueront, mais aussi les nantais, les lyonnais, les parisiens, les montpelliérains de Clever Institut, les visites en Suisse, les conf-call avec Hong-Kong ou Singapour. Hasard du calendrier, je quitte Clever tandis que par le biais d’un autre rachat, un ami d’un autre temps rejoint le navire depuis le Québec. Puisque je vous dis que le monde virtuel est tout petit !

Je me sens comme celui qui attaque le dernier chapitre d’un livre qu’il a beaucoup aimé et dans lequel il a corné les pages les plus mémorables pour pouvoir s’y plonger, par nostalgie, un autre jour. J’ai plusieurs pistes pour de futures lectures, mais je compte bien profiter de celle-ci jusqu’à la dernière ligne.

Le rendez-vous

Le souvenir du mois dernier en a appelé un autre, tout aussi mémorable…


Aujourd’hui, c’est le grand jour !

J’accompagne une équipe interne d’une Grosse-Organisation pour la présentation officielle d’un projet auprès du Grand-Patron. L’interface est ultra-léchée, avec une vraie démarche de navigation et d’organisation des données et un travail poussé sur l’univers graphique. La moitié de la boite a participé à l’éloboration de l’UX et de l’UI.

Le moment est crucial : le site n’est destiné qu’à un usage interne, pour les hauts cadres de l’entreprise et niveau cadre, on ne peut pas faire plus haut que lui. Son avis sur le projet est crucial, pour ne pas dire que la petite dizaine de gens présents avec moi appelle ce projet « Le projet Grand-Patron ».

Après plusieurs escaliers et de nombreux couloirs, nous arrivons dans l’antichambre de son bureau. Une table basse, quelques larges fauteuils, des magazines qui vantent tous l’organisation en question. J’ai du mal à croire qu’il y a un salon expressement dédié à attendre avant d’être reçu dans cet unique bureau. Je suis un peu intimidé.

GIF: Lenny, du dessin annimé Les Simpsons, est concentré.

Je reste concentré, en attendant que la porte s’ouvre.

Tandis que nous attendons, deux travailleurs sortent des bureaux situés dans le couloir adjacent et se dirigent vers la photocopieuse. Ils sont jovials, se tancent. Ils ne nous ont pas vu, mais nous les regardons, faute d’avoir mieux à faire. Leur discussion est parsemée de rires, puis tourne véritablement au jeu. Le premier se retrouve à poursuivre le second dans le couloir mais le perd de vue quand il se cache derrière une autre photocopieuse. Depuis l’antichambre, j’observe avec un œil perplexe.

GIF: Ron Winsley se demande se qui se passe.

Comme dirait Ron : quel est le fuck ?

Nous attendrons plus de 30 minutes avant que la porte du bureau ne s’ouvre et que le Grand-Patron aparaisse, le téléphone portable vissé à l’oreille. Il nous regarde depuis l’encadrure de la porte sans avoir l’air gêné de son retard. Il congédie son interlocutrice, puis s’adresse à nous pour nous expliquer qu’il faut qu’on attende encore un peu parce qu’il est absolument débordé et qu’il n’a pas eu le temps de résoudre un problème urgent.

Aussitôt dit, aussitôt fait, il téléphone à sa femme devant nous et engage une discussion très mouvementée sur l’importance qu’elle aille faire les courses au plus vite, car sinon ce sera à lui de les faire le soir-même. Nous attendons toujours. Ils enchainent sur l’état de santé d’une tante, puis sur des récipissés fiscaux à déposer quelque part.

L’appel terminé, nous nous lançons des regards.

GIF: Un jeune garçon, visiblement content d’être filmé par la caméra du stade où il se trouve pour assister à un match, entâme une danse très… particulière.

Ça va être notre tour !

Mais non.

Grand-Patron part à la recherche de son adjoint en nous disant de bien vouloir patienter.

Il revient accompagné. Nous reconnaissons la personne qui s’était cachée derrière la photocopieuse. Il a encore les joues toutes roses de la bonne tranche de rire de trente minutes plus tôt. Visiblement, cette fois, sa cachette était meilleure car il a fallu dix longues minutes à Grand-Patron pour le retrouver, dans un couloir de dix mètres.

On nous fait signe d’entrer dans le bureau. Je tends la main vers nos hôtes pour échanger une poignée de mains. Grand-Patron, la regarde fixement en gardant les bras le long du corps. Une seconde flottement lui suffit à se dire qu’il s’ennuie et bien que mon bras soit toujours tendu dans sa direction, il se met en marche et entre dans le bureau en me frôlant. L’air qu’il déplace en avançant m’assène une gifle de mépris. Super premier contact.

GIF: Des visages de jeunes femmes capturés en slow motion, tandis qu’un souffle très fort est envoyé de face

À ce niveau de vent, les pupilles se dilattent.

L’adjoint s’empresse de prendre sa place, saisit ma main et la sert vigoureusement en se présentant longuement, prenant soin d’insister sur la longue collaboration entre nos organisations et son rôle central ayant vocation à devenir primordial dans les mois ou années qui viennent. « Arg, encore un Iznogoud », me dis-je en décalant mes pieds pour éviter que ses canines n’abîment ma chaussure.

Le bureau est gigantesque et richement décoré. Je n’ai jamais vu un bureau aussi grand pour une seule personne : j’ai vécu avec ma femme dans des appartements plus petits. Sur les commodes et les tables, des piles de papiers bien rangés s’alignent dans un agencement trop ordonné pour que quiconque soit allé un jour fouiller dedans. Les toiles aux murs et les bois nobles utilisés pour le mobilier sont savament éclairées par les imposantes surfaces vitrées qui entourent la pièce. Ce n’est pas un bureau, c’est un espace de richesse au milieu du ciel.

GIF: Une cascade au milieu d’un paysage montagneux ensoleillé

Il ne manque qu’une cascade, le long d’un mur, pour que j’ai envie de passer mes prochaines vacances dans ce bureau.

Nous nous installons autour d’une table de réunion, faisons un tour de table et démarrons la présentation. Un projecteur est disponible, mais on m’a expliqué avant qu’il n’était pas pertinent de l’utiliser : des captures d’écran ont été imprimées sur cartons plume pour « mieux » présenter l’interface. On n’y perçoit pas tout le travail ayant été fait sur l’ergonomie de navigation mais, au moins, ça rend bien. J’aurais préféré valider les interactions en amont avec un prototype dynamique mais l’entourage de Grand-Patron m’avait refusé cette opportunité.

C’est quelqu’un de pressé. Il n’a pas le temps de « jouer » avec des produits qui ne sont pas finis. Ça ferait trop « gadget ».

Nous présentons donc rapidement les gabarits Front Office et les modalités de contribution tandis que Grand-Patron regarde des messages sur son téléphone. Impossible de savoir s’il nous écoute. L’adjoint, lui, boit nos paroles mais au vu des questions qu’il soulève, je comprends vite qu’il n’a pas été briefé et découvre complètement le projet.

Soudain, Grand-Patron lève la tête :

— Les données, elles viennent d’où ?
— De ce Back Office qui sera mis à disposition pour les saisir.
— Non mais merci, hein. Mais chez nous, elles viennent d’où ?

Je suis pris de court par la question. Je regarde autour de moi et établis un contact visuel avec la personne qui, jusqu’à présent, me fournissait des données pour nos tests. Le format des données fournies était très standardisé. Pour moi, il était évident qu’il s’agissait d’un livrable issu d’un processus interne.

— Pour l’instant, on est partis des chiffres de la direction XXXX, représentée par Mr YYYYYY ici présent.
— Les chiffres de la direction XXXX ? Vous ne parlez quand même pas des saloperies qu’on balance dans nos communiqués internes ?
— Et bien, euh… si.
— Ah non mais ces chiffres-là, ils sont faux, tout le monde le sait. On les signe, on les annonce en interne, mais ils sont faux. On le sait, les concurrents qui nous observent le savent, tout le monde le sait !

GIF: Lindsay Lohann est surprise.

Je suis sur le cul.

Malaise chez les collaborateurs. Personne ne semble vouloir répondre. Étant le seul à ne pas être directement concerné, je sors l’équipe de son embarras en embrayant rapidement sur la capacité d’adaptation du projet aux différents périphériques de consultation.

— Ah donc je peux y accéder sur mon téléphone ? Parce que jusqu’ici, ce n’était pas possible.
— Assurément, nous avons développé une interface compatible avec les smartphones récents, mais aussi les tablettes. En réalité, l’interface s’adapte à la largeur disponible…
— Oui, bon, tout ça c’est très bien… mais est-ce que je vais pouvoir le voir sur mon téléphone ? Oui, ou non ?
— Oui, je pense pouvoir dire que oui. En réalité, nous avions pris les devant en demandant quel était votre téléphone à vos collaborateurs et ils nous ont donné la version précise de votre iPhone. Tous nos tests ont été faits sur ce modèle, spécifiquement.
— Ah non mais je ne m’en sers pas de l’iPhone. Je me sers de celui-là.

Il sort de la poche de sa veste un Nokia sorti entre 2004 et 2006, écran LCD, clavier physique, 2G et pas de navigateur ou de système de gestion d’applications.

Il ne capte pas très bien mais il tient longtemps sans être rechargé !

GIF: Sheldon, de The Big Bang Theory, panique et souffle dans un sac en papier

Je suis en totale panique.

L’ensemble du projet tombe à l’eau. Je regarde autour de moi, espérant que quelqu’un me sauvera à mon tour et détournera la conversation vers un autre sujet. J’oublie qu’ils sont tous bien plus terrifiés que moi. Personne ne dit rien. Un silence pesant s’installe pendant une minute qui me semble durer une éternité.

Grand-Patron comprend, s’emporte sur le temps qu’on lui fait perdre et nous demande de sortir.

GIF: Cary Grant demander à ce qu’on sorte

Son ton autoritaire nous fait déguerpir rapidement.

Alors que je m’apprêtais à fermer la marche, cependant, il m’attrape la manche et me parle de manière très calme :

— Vous… quand vous vous êtes présentés, vous avez bien parlé dans vos références de l’entreprise ZZZZZZ ?
— Oui, c’est un de mes clients…
— Et vous connaissez le Directeur ?
— Oui, nous avons travaillé ensemble sur…
— Très bien, dites-lui qu’il est le bienvenu dans mon bureau quand il le souhaite. N’hésitez pas à revenir avec lui, nous demanderons à Corinne de réserver une bonne table.

Il dégaine son sourire le plus forcé tout en me poussant dans le dos pour mieux refermer la porte derrière moi. Le temps que je comprenne ce qui se passe, c’est déjà fini.

Toute l’équipe semble anesthésiée, groggy. Après un silence lourd de honte et de gêne, j’interroge les autres :

— Les données, elles sont vraiment fausses ?
— Non, il exagère, elles sont « presque » vraies.
— Presque ⁈ Et l’iPhone, pourquoi vous m’avez dit qu’il avait un iPhone ?
— On savait qu’il ne s’en servait pas trop, mais on espérait que ça allait changer. Attendez, on va demander à sa secrétaire…

Je les suis dans le couloir, jusqu’à un bureau recouvert du sol au plafond de dossiers. Une femme semble bûcher sur une tâche impossible. Elle lève la tête et se rend immédiatement disponible pour nous. Visiblement, elle a l’habitude d’être interompue.

GIF: Big Ang ne rigole pas avec le taf

Droit au but.

— Corinne, il s’en sert, de son iPhone, Grand-Patron ?
— Quoi ⁈

Elle me regarde. Je hoche la tête et exprime le « bonjour » et le « pardon de vous déranger » que les autres ne semblent être décidés à lui offrir. L’autre collaborateur enchaine aussitôt.

— Oui, oui, bon… Il s’en sert, de son iPhone ?
— Il n’a pas d’iPhone. Il n’a jamais eu d’iPhone, il a un Galaxy S. Tu veux la facture ?
— Non, on s’en fout de la facture… il s’en sert ou pas, de son Galaxy S ?
— Je crois bien qu’il m’a envoyé un SMS une fois. Ah, non, un MMS ! Je me souviens, il était très fier de lui, il avait compris comment joindre une photo. Vous savez, il n’est pas trop branché technologie, ordinateur, tout ça. C’est tout juste s’il se sert de son PC. C’est moi qui lui lit ses emails à voix haute.

GIF: Stehen Colbert a besoin de 4 mains pour se lamenter

FIN.

Entretien d’embauche : évaluer les savoir-être

Lors de la réalisation d’un entretien d’embauche, il est souvent nécessaire d’estimer les compétences techniques d’une candidate ou d’un candidat. Cependant, l’évaluation technique est loin de valider à elle-seule la pertinence du recrutement d’un futur collaborateur. Il existe des personnes très compétentes qui sont incapables de travailler avec des personnes novices et d’autres qui sont, à l’inverse, de très bonnes facilitatrices et ont un rôle à jouer dans une équipe sans détenir d’expertise particulière.

Au fil des années, j’ai donc établi une grille d’évaluation personnelle qui me permet de mieux cerner les candidat, en dehors de leurs simples compétences techniques. Je m’en sers comme base d’analyse et la relis avant et après chaque rendez-vous pour ensuite pouvoir écrire un compte-rendu d’entretien de qualité aux personnes qui m’ont demandé de m’en occuper.

Avertissement : je ne suis pas responsable des ressources humaines, rien n’est absolu ou gravé dans le marbre et j’ai déjà donné des avis favorables sur des personnes qui ne rentraient absolument pas dans ces critères. Dans l’absolu, je recommande toujours de faire l’entretien à deux ou d’inviter la candidate ou le candidat pour un second entretien avec une autre personne sans lui transmettre mon avis en amont pour éviter de l’influencer.

Quelques signes que le ou la candidate « joue le jeu »

  • Tenue correcte
  • Posture
  • Calme
  • Qualité d’écoute

Un entretien, qu’on le fasse par Skype ou en face-à-face, est constitué d’un ensemble de règles culturelles et consensuelles auxquelles un candidat doit savoir se plier. J’ai totalement conscience qu’en soi, c’est stupide. Cependant, c’est un signal fort quant à la capacité du ou de la candidate à s’adapter à d’autres situations codifiées à l’avenir, situations qui sont encore nombreuses dans le monde professionnel.

S’exprimer

  • Expression claire (à l’oral ou par écrit)
  • Vocabulaire adapté au contexte et précis
  • Discours sincère, authentique
  • Capacité de synthèse, concision

Peu importe le poste occupé, tout le monde a besoin de savoir s’exprimer d’une manière ou d’une autre, à l’écrit ou à l’oral. De nombreuses choses seront perçues ou perdues dans l’échange en fonction de ces capacités. Il faut donc que l’expression, qu’elle soit orale ou écrite, soit précise, concise et agréable.

Travailler en équipe

  • Évite les jugements, exprime de la bienveillance
  • Apprécie la vie en groupe, le dialogue
  • Exprime un sens du « commun », de l’intérêt général
  • Ouvert à l’égalité, à la diversité

Un candidat ne connait pas, a priori, l’organisation du travail et les profils de ses futurs collaborateurs. Même s’il a le profil d’un travailleur ou d’un travailleuse autonome (je reviendrai sur les profils dans un autre article), il doit montrer qu’il est capable d’observer, de prendre du recul, d’être patient avant de juger…

Curiosité, exhaustivité

  • Se pose des questions sur le poste, le secteur, le marché…
  • Cherche à s’informer sur les savoir-faire
  • S’informe sur l’organisation du travail

Les tâches confiées et l’équipe à qui elles sont confiées ne sont qu’une partie du travail. L’organisation du travail, à la fois dans la méthode que dans les réglementations internes, constitue une part importante de la vie de l’entreprise. Je serais assez peu enclin à embaucher une personne qui ne serait pas sensible à son environnement ou exprimerait, dès l’entretien, peu d’intérêt pour le collectif.

Capacité à affirmer des positions

  • Développe des points de vue personnels
  • Assume ses choix, se prononce clairement
  • Illustre, argumente et remet en question
  • Reconnait ses limites

Pour enrichir l’équipe un candidat doit aussi être capable d’émettre une analyse non-stéréotypée et de l’assumer par des explications claires et convaincantes. Je détermine souvent ce point en posant à la personne des questions qui divisent la communauté. Le point de vue du candidat ou de la candidate m’intéresse alors peu, c’est la qualité de l’argumentation que j’analyse. Un aveu de méconnaissance du sujet est également une bonne chose, si tant est que le candidat ou la candidate propose ensuite d’émettre des hypothèses construites.

Capacité d’investissement

  • Capacité à prendre des décisions et les assumer
  • Maitrise de l’effort (ténacité, endurance, mais aussi remise en cause et repos)
  • Investissement dans un projet
  • Prise de recul sur la valeur ajoutée des autres individus

Ces points nécessitent presque toujours de faire parler la personne de ses projets précédents pour savoir si elle sait prendre du recul sur sa propre pratique du métier et son rapport aux autres collaborateurs et collaboratrices. Cela permet d’évaluer le dynamisme mais aussi la sagesse, l’ambition mais aussi la capacité à participer à un projet dans ce qu’il constitue de patrimoine commun.

Capacité d’innovation (?)

  • Capacité à identifier le cadre
  • Capacité à proposer des alternatives

C’est encore un des points que j’ai le plus de mal à évaluer car j’ai souvent moi-même l’impression de manquer de fantaisie. L’idée ici est d’estimer la capacité du candidat ou de la candidate à sortir des sentiers battus et, surtout, comment il ou elle le fait et provoque la réflexion chez les autres. Il y a plusieurs façons d’y parvenir et il existe une grande littérature sur le sujet, donc je ne vais pas m’attarder dessus ici.

Positionnement personnel par rapport au positionnement de l’entreprise

  • S’est renseigné sur l’entreprise, connait ses valeurs
  • Explique clairement son intérêt propre
  • Se projette dans l’avenir dans une construction commune

Cette dernière partie est souvent la plus délicate pour le candidat ou la candidate car il ne connait jamais aussi bien l’entreprise qu’après la présentation qu’on lui en fait en début d’entretien. Il ou elle doit donc rapidement définir ce qui, dans les valeurs présentées, fait écho à son propre jeu de valeurs et expliciter ce à quoi il adhère et, c’est nécessaire, ce qu’il compte apporter.

De vrais gens, derrière

Il y a parfois des souvenirs, des échanges, qui font de vous le professionnel que vous êtes. En voici un lié à la Qualité…

Au mois de mai, les ruelles de Paris étaient éclairées d’un printemps ensoleillé. Je rejoins la salle de formation en sifflotant. Pour une fois que je suis l’étudiant, et pas le formateur !

Dans la salle, trois autres participants que je ne connais pas. L’un d’entre eux me regarde étrangement au moment de nous saluer mais je chasse ce détails rapidement pour concentrer mes pensées sur la formation, intense. Quelques heures plus tard, nous partons déjeuner et en profitons pour faire plus ample connaissance.

Manifestement, il me connait. Des indices dans ses propos semblent témoigner d’une légère hostilité à mon égard. Je me triture le cerveau sans arriver à retrouver de qui il s’agit.

Agacé de ne pas retrouver son nom, je finis par lui poser la question.

— Écoute, j’ai l’impression que tu me connais mais… enfin… on s’est rencontrés ?
— Non, je te connais mais tu ne me connais pas.
— Ah, mais, euh… j’ai fait quelque chose de mal ? J’ai été désagréable avec toi ?
— Non, enfin… sans le savoir. Et encore, c’est pas ta faute. Il y a quelques années, je travaillais dans une société qui produisait des encarts publicitaires et toi chez XXXX, un des plus gros clients de notre régie.
— Oui, c’était un de mes clients. Je m’occupais d’améliorer la performance Web.
— Ça, je ne sais pas. Mais nous recevions des alertes régulières pour des évolutions dans nos formats. Supprimer les document.write, améliorer les temps de réponse, réduire des images, ne plus reposer sur des librairies tierces…

Il marque un temps d’arrêt et continue :

Pendant plusieurs mois, tous les tickets les plus pénibles portaient ton nom. Quand on en voyait arriver un nouveau, on rigolait jaune. Je crois que j’ai fini par te détester, alors qu’on s’était jamais vu. On avait trouvé ta photo sur Internet, elle était imprimée et pointée sur le mur. Sur la cible des fléchettes… Désolé.


La Qualité implique souvent de relever des problèmes d’implémentation et, quand il s’agit de code tiers, de demander aux responsables de corriger. Jamais, avant cet échange, je ne m’étais autant rendu compte de l’existence de ces personnes, de ces gens qui ne sont pas forcément formés à la qualité et ne comprennent pas, au moment où elles reçoivent les demandes, les motivations sous-jacentes.

Je n’ai pas arrêté de créer des tickets mais je le fais toujours avec la plus grande bienveillance. Je continue à être poli et essaie désormais d’inclure des références vers des référentiels permettant à mon interlocuteur de comprendre ma motivation.

Il existe peut-être encore, quelque part, quelqu’un qui me déteste même s’il ne me connait pas.

Scrumbuts et Cargo Cult

Les Scrumbuts désignent l’ensemble des entorses à Scrum auxquelles les équipes recourent lorsqu’elles n’arrivent pas à appliquer correctement cette fameuse méthodologie Agile.

We use Scrum, but…

Les équipes concernées prennent donc sur elles, parce qu’elles pensent bien faire, de modifier la méthodologie pour faire disparaitre cette incompatibilité, ce point de friction et ainsi aller de l’avant. Cela commence une petite entorse, puis une autre… À chaque fois, des excuses justifient la modification « maison » :

— On est en Scrum mais on ne fait pas la mêlée quotidienne. Si quelqu’un a quelque chose à signaler, il envoie un mail.
— On est en Scrum mais nos sprints durent six semaines, car la majorité d’entre nous est à temps partiel !
— On est en Scrum mais comme on communique bien tout le temps, on n’a pas besoin de faire de rétro.
— On est en Scrum mais l’équipe est divisée en deux groupes qui ne se parlent pas.
— Bien sûr qu’on fait du Scrum, on a des post-it plein le mur [mais c’est à peu près tout] !

Quand je rencontre une entreprise me disant qu’elle a échoué à mettre en place Scrum, je me demande dans quelle mesure sa mise en place était « adaptée » par l’entreprise à son besoin.

Pensée magique

Le Cargo Cult désigne l’attitude des habitants des archipels Vanuatu (et, plus largement, de Mélanésie), témoins de l’installation des américains sur leur sol pendant la seconde guerre mondiale et, surtout, l’arrivée des avions et des navires de ravitaillement qui leurs livraient de nombreuses marchandises. Eux qui n’avaient jamais connu de système économique comparable, de production industrielle, ne pouvaient pas deviner que ces produits étaient le fruit de la production d’autres hommes. Pour eux, ce ravitaillement était magique, divin.

Ils se mirent, peu à peu, à reproduire ce qu’ils voyaient, adoptant des comportements qu’ils observaient dans l’espoir de voir arriver de nouveaux bateaux ou avions. Certains se sont mis à couper des fleurs pour les mettres dans des vases pendant que d’autres ont carrément construit de fausses cabines radio ou de fausses pistes d’atterissage, espérant que cela ferait revenir les cargos.

Ce phénomène anthropologique est souvent utilisé en informatique pour moquer les développeurs qui copient du code d’autres et le réutilisent sans pleinement maitriser son impact1.

Il a clairement une attitude similaire dans de nombreuses structures qui cherchent à adopter l’Agile, choisissent Scrum, puis enchainent les Scrumbuts.

Agile contraint

L’Agile porte souvent très mal son nom. Prenons Scrum (qui n’est qu’une des dizaines de façons de faire de l’Agile) : chaque rôle, chaque règle, chaque temps est défini pour apporter un certain bénéfice à l’équipe et lui permettre de déjouer des situations problématiques bien connues. Chaque Scrumbut est une entaille à ce mécanisme, une épine dans le pied de l’équipe qui l’empêche de marcher et qui détruit à chaque pas la confiance que l’équipe pourrait avoir placé dans la méthodologie.

Quand vous multipliez les Scrumbuts, souvent parce que vous pensez que cela permet de « mieux adapter » Scrum à votre entreprise, vous négligez en réalité les apports de la méthodologie et espérez qu’en reproduisant quelques artefacts qui vous arrangent (souvent, les plus visibles et qui coûtent le moins cher), vous en tirerez les même avantages que ceux qui vous en disent du bien.

Sortez de ce Cargo Cult ou vous gâcherez de manière irrémédiable le potentiel Agile de vos équipes.

Deux post-its, comparant l'Agile façon Cargo Cult et les vraies livraisons successives

"<a href="https://www.flickr.com/photos/psd/9588038559" title="Lien vers la photo sur Flickr">Doing Agile, being Agile", par <a href="https://www.flickr.com/photos/psd/" title="Profil Flickr de Paul Downey">Paul Downey — <a href="https://creativecommons.org/licenses/by/2.0/" class="photo-license-url" rel="license cc:license" target="_newtab" >Certains droits réservés

  1. Si vous ne l’avez jamais vue, je vous conseille la conférence « Le culte du cargo » par Thomas Zilliox à Sud Web 2013. ↩

Tellement à apprendre

Un de mes collègues a partagé une synthèse de différents outils Devops qu’il a trouvé sur LinkedIn… J’ai mis en exergue les outils que j’avais déjà utilisé dans le cadre de projets.

Un graphique, principalement en noir et blanc, présentant différents outils Devops classés en catégories : collaboration, compilation, tests, déploiements et maintenance opérationnelle. Sur les 150 outils listés, une cinquantaine est en couleur, pour être démarquée.

Infographie réalisée par James Bowman dans son article "Continuous delivery tool landscape"

Je connais à peine ⅓ des outils de l’infographie1, mais l’exercice est intéressant.

Il me permet de mieux diagnostiquer mon degré d’autonomie

Je ne pense absolument pas que la maitrise de l’ensemble de ces outils soit nécessaire mais leur regroupement en phases de projet (de la collaboration initiale à la production) me permet de constater que mes compétences actuelles me donnent une bonne autonomie. C’est toujours très délicat de s’auto-évaluer car je ne connais pas deux personnes, dans mon entourage numérique, qui font exactement le même métier, qui offrent exactement le même niveau de service ou de technicité à leurs partenaires, clients ou employeurs. On se rabat donc sur ce qu’on trouve !

Il me permet de mettre le doigt sur des lacunes opérationnelles

Je le savais avant, mais l’exercice le souligne encore davantage : je suis plus attiré par les tâches d’accompagnement du développement que par les tâches de maintenance opérationnelle, notamment quand elles impliquent de gérer des fermes de bases de données ou d’orchestrer des services dans le cloud. Il s’agira de combler ces lacunes ultérieurement en prenant soin de monter en compétence sur ces points ou de m’entourer des bonnes personnes.

Il souligne à quel point les chefs de projet sont versatiles

Je suis très éloigné d’avoir la maitrise complète d’un seul de ces outils. Au mieux en ai-je survolé les possibilités, avec un objectif très déterminé, en prenant uniquement dans l’outil ce qui satisfaisait mes besoins du moment. Le simple fait, cependant, d’avoir manipulé autant d’outils en quelques années montre à quel point la gestion des développements Web implique une connaissance large des problématiques et de comment y répondre. Je sais pas comment le dire autrement que comme ça : je suis vraiment très heureux d’avoir face à moi, chaque jour, d’aussi nombreux défis.

Il ne présente qu’une toute petite part de nos compétences

Les gestions des développements et de la maintenance opérationnelle des sites Web présente de très nombreux défis que certains de ces outils permettent de confronter. Cette infographie ne présente cependant qu’une partie des enjeux car des pans entiers ne sont pas abordés : les cadriciels de développement, les outils de gestion de données de tous types (CMS, PIM, DAM, MDM et compagnie), les outils de stub, mocks et dummies, les outils de protection ou de détection des intrusions, les gestionnaires d’APIs et de configurations, les outils d’analyse de la qualité de code, de la qualité opérationnelle, de l’accessibilité, les compilateurs, les gestionnaires de notifications, les systèmes de queue… et c’est uniquement ce qui me passe par la tête en rédigeant l’article.

Ajoutons à ça que plus je vieillis j’acquiers d’expérience, plus j’ai le sentiment que les principales difficultés ne sont pas tant liées aux outils qu’à la gestion des personnes, des besoins et de leurs possibles évolutions. Évolutions qui nécessitent de trouver les bons formats de collaboration et les architectures de code adaptées et, après, les outils.

J’ai encore tellement à apprendre.

  1. Si ce genre d’infographies vous intéressent, vous devriez également apprécier IT Landscape for sysadmins d’Alen Krmelj et The Periodic Table of Devops Tools de XebiaLabs. Pierre me signale également The Web Developer Roadmap - 2017 qui n’est pas orienté que Devops, mais apporte des choses aussi. ↩

Digital

J’évite souvent ici de parler de digital, préférant utiliser le terme numérique. Cependant, force est de constater qu’un secteur entier s’appelle aujourd’hui comme cela, et que digital et numérique sont souvent perçus très différemment.

Le numérique définit l’ensemble des équipements électroniques non-analogiques et les interactions que l’on peut avoir avec eux. Le terme est souvent associé à une valeur scientifique, mathématique, entrepreneuriale1 qui nous pousse à parler plutôt, lorsqu’on imagine certains projets, de digital.

Si on regarde bien, on en parle beaucoup dans le Web mais surtout, et c’est finalement le plus important, quand on parle des usages et des usagers. C’est à mon sens là que le digital se différencie du numérique : dans la valeur d’usage.

Nous passons d’une société matérialiste à une société expérientialiste.

expliquait Carine Lallemand, chercheuse en expérience utilisateur, pendant BlendWebMix 2015. La bascule de numérique vers digital traduit cette évolution dans les métiers où le contrôle de l’expérience devient la clé de voûte du succès.

  1. Une réflexion de fond serait à mener sur ce lien que semble faire le monde occidental entre innovation, technique et entreprise. Il y a là quelque chose qui tient de l’impérialisme économique de la Science devant la Culture… ↩

Comparaison numérique

Depuis plusieurs années, je suis perturbé de voir à quel point nos représentations numériques sont des projections très imparfaites de nous-mêmes. Nous partageons rarement nos vies, nous partageons ce qui nous a plu, ce qui nous fait vibrer et, éventuellement, les moments douloureux mais uniquement ceux dans lesquels nous sommes accompagnés ou dont nous nous sommes remis.

Nos lecteurs, qui par le biais des réseaux sociaux sont nos amis, notre famille, nos collègues… pensent alors que nos vies sont formidables, que nous sommes debouts dans les épreuves, que nous sommes bien entourés et ne vivons que des choses dont l’impact est positif… et peuvent s’en sentir eux-même attristés, seuls, isolés, invisible.

La vie n’est pas aussi belle.

Les vrais moments durs, les moments pénibles, les moments où on sert les dents en espérant que ce sera différent le lendemain, les moments de détresse où l’on ne se reconnait plus et où on se sent perdu… sont rarement des moments que nous avons envie de partager en dehors d’un cercle intime.

Cependant, ces moments arrivent. Ils m’arrivent à moi, ils arrivent aux personnes connues, ils arrivent aux gens que vous croisez dans la rue, ils arrivent à tout le monde. Ne l’oublions jamais.

(Web) Apps : il n’y a pas de balle en argent

Je suis encore tombé récemment sur un article qui annonçait calmement la fin des applications mobiles, en disant que le RWD et les Progressive Web Apps (PWA) étaient la réponse à l’ensemble des besoins des organisations, chiffres d’installation des applications à la clé. Comme le disait Frederick Brooks, il n’y a pas de technique miraculeuse (No silver bullet) en génie logiciel. L’utilisation des chiffres n’est pas si évidente que ça et il existe de nombreux pièges qui peuvent nous inciter, par intuition, à conclure de manière erronée quant à la réalité.

Faisons ensemble un petit tour d’horizon des biais de logique liés à cette pratique.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Web ou natif ?

Imaginons que l’on mesure la satisfaction des utilisateurs d’applications de tous types : des applications natives pures, des applications cross-platform, des applications semi-hybrides à la React Native, des PWA « installées » sur Android 6, des PWA non-installées et des Web App non-progressive. Avec ces mesures, nous serions en mesure de réaliser un graphique avec en abscisse la mesure de satisfaction et en ordonnée, le degré de rapprochement avec les applications natives :

Un graphique présentant des points éparses avec une tendance vers plus d'applicatif = plus de satisfaction

Notre premier graphique présentant la satisfaction des utilisateurs en fonction de leur rapprochement technique avec les applications natives

Difficile de déduire quelque chose de précis, mais on peut déterminer une tendance globale si on réalise la moyenne de la satisfaction de chaque groupe d’applications : plus on se rapproche du natif, plus on semble avoir des chances de dégager de la satisfaction.

En fonction du type d’application ?

Imaginons désormais que l’on observe la satisfaction en fonction du type d’application, c’est à dire, simplement, en fonction de la catégorie dans laquelle vous placeriez chaque application sur une place de marché d’applications.

Le même graphique qu'au dessus sauf que désormais, les types d'applications sont présentés. Les tendances dépendent entièrement du type.

Alors, c’est moins facile, là, non ?

Les tendances semblent clairement moins évidentes.

On se rend rapidement compte que les catégories affichées sont très limitées. Pas de réseaux sociaux, par exemple. Nous avons donc ici une vision extrêmement parcellaire du marché, qui peut considérablement modifier la pertinence des conclusions précédentes. Ce biais est très courant dans les études que je lis ça et là. Faites-y attention.

Supposons que ça ne soit pas un problème pour nous (on s’intéresserait exactement à ces types d’applications) et continuons l’analyse.

Suivant la catégorie, les satisfactions relatives au côté applicatif ne sont pas du tout comparables : les meilleurs outils de productivité et jeux, par exemple, semblent être proches du natif. En revanche, les applications de cuisine ne semblent pas du tout en tirer partie. En creusant un peu les besoins concernés, cela fait sens : les outils de productivités ont souvent besoin d’accéder aux fonctionnalités de manipulation de fichiers du système et les jeux ont besoin de puissance et d’une bonne maîtrise de la programmation parallèle, il est donc normal qu’ils soient développés au plus proche du système d’exploitation.

On a le sentiment qu’en appliquant des raisonnements de bon sens sur l’ensemble des catégories, on devrait pouvoir trouver des tendances. Un jeu serait alors toujours meilleur en natif, un site de cuisine n’en tirerait aucun avantage… mais rapidement, on se rend compte que cela ne marche pas pour toutes les catégories. Le e-commerce, par exemple, ne semble pas affecté par le type d’applications…

Et les budgets ?

Et si les applications ne bénéficient pas du même niveau d’investissement en fonction de leur type et de leur plate-forme de développement ? Allons creuser de ce côté-là en visualisant également le budget de chaque type d’application.

Le même graphique qu'au dessus que la taille des points est relative au budget. Même si plus d'applicatif semble vouloir dire que le budget est plus important, il existe des exceptions

Toujours pas évident, hein ?

Les applications natives semblent coûter plus cher, ce qui est compréhensible : il faut développer pour deux ou trois système là où les développements cross-platform ou Web adressent plus facilement de multiples matériels. Sauf que non, on trouve aussi un haut budget dans une application de bureautique semi-hybride. Impossible de savoir s’il s’agit d’un investissement choisi ou des conséquences d’un mauvais choix de technologie couplé à un entêtement1.

Autre tendance visible : on trouve des hauts budgets dans les applications e-commerce. Mais cela ne permet pas de savoir si ce sont les applications e-commerce qui coûtent plus cher à développer ou si ce sont les budgets qui sont, de base, plus importants parce que le retour sur investissement est plus prometteur.

Mais alors, les chiffres ne disent rien ?

Les chiffres sont très difficiles à interpréter car les causes et les effets s’entremêlent quand on commence à mélanger une technologie sous-jacente et un besoin fonctionnel. Nous sommes en plein paradoxe de Yule-Simpson2 : peu importe les groupes constitués (prix, objectif, satisfaction…), les corrélations observées en combiné ne sont pas cohérentes avec ce qui s’observe dans chacun des groupes. Il manque des informations qui influencent l’ensemble des facteurs.

Un très bon exemple est l’application impossible : cette application dont vous savez qu’elle va demander l’ensemble des compétences, des équipes, des accès aux fonctionnalités natives pour une UX parfaite. Vous mobilisez vos équipes, le développement est long et coûteux et… ça rate. L’application ne marche pas. Vous avez un parfait exemple de l’application qui coûte cher à développer, que vous n’auriez jamais tenté en hybride mais qui vient plomber les statistiques et donne l’impression que le natif n’était pas la bonne solution. En réalité : on demande rarement la même chose à une application pour laquelle le natif a été choisi et à une application pour laquelle le développement s’est tourné vers de l’hybride.

Un autre bon exemple est celui de ce client qui avait besoin d’un très grand contrôle sur l’interface de son application mais ne voulait pas croire à la pertinence d’un investissement sur du développement cross-platform, arguant que ⅔ des utilisateurs mobiles n’installent jamais d’applications autre que des réseaux sociaux… sauf que son application était destinée à une cible B2B incitée à installer l’application pour des besoins administratifs. Cette cible et cette stratégie d’acquisition spécifiques rendaient les statistiques citées complètement invalides.

Une vision d’ensemble

Pour prendre de bonnes décisions, il faut aborder l’ensemble de chaque projet : spécifications fonctionnelles et technique, analyse de la cible (en âge, CSP, emplacement, culture…), niveau d’information et de compétence des équipes, plate-forme de développement existante ou acquise, pérennité du développement, chiffre d’affaire espéré, stratégie de déploiement et de maintenance…

Pour l’instant, aucun algorithme Big Data n’est capable de prendre le recul nécessaire par rapport à un besoin que, souvent, le commanditaire lui-même ne sait pas formaliser. Il reste nécessaire de passer du temps à affiner ce besoin, le cadrer, et déterminer au cas par cas les solutions qui ne peuvent pas être que techniques.
Si vous avez envie de dire que les PWA sont prometteuses et qu’il est temps de vous y intéresser, allez-y (j’y crois moi-même énormément). De là à dire qu’il faut abandonner les applications natives et les places de marché dans tous les cas, il y a un pas que je ne franchirai pas.

En cas de doute, faites-vous conseiller par des gens qui ont de l’expérience, qui sont compétents et indépendants des technologies employées. En cas d’absence de doutes : encore plus.

  1. Il est courant de voir des acteurs de tout niveau d’information se refuser à abandonner une technologie qui est pourtant manifestement inadaptée à un projet. Cela n’a rien d’étonnant et ce n’est pas simplement de la mauvaise foi. Il s’agit d’un mélange de biais comportementaux très connus : le biais des coûts irrécupérables et le le biais de confirmation. ↩

  2. Un paradoxe statistique très perturbant, très bien décrit par David Louapre dans l’épisode 7 de Science Étonnante. ↩

Gagnants

La semaine dernière, nous avons été appelés par NaturaBuy, une société qui est sur le point de recruter un nouveau membre pour son équipe Web. Cette société m’a indiqué qu’elle souhaitait faire passer l’examen Opquast certified à ses deux derniers candidats. « Short list - Opquast certified pour le recrutement », Opquast

J’aime cete idée de faire monter un candidat en compétence lors d’un recrutement. Cela peut séduire et attirer des candidats vers des postes/régions où le recrutement est difficile. Ensuite, cela fait grandir l’ensemble des candidats concernés et est donc meilleur pour le marché au sens large. Enfin, cela permet d’évaluer un candidat dans la seule vraie dimension qui compte dans nos métiers : sa capacité à apprendre.

Quand on connait le coût parfois exorbitant d’un recrutement, je trouve que c’est de l’argent bien investi.

Résolutions
Retour sur 2016

En ce début d’année 2016, j’ai décidé de prendre quelques bonnes résolutions. Il est temps de voir où j’en suis alors que 2017 se profile démarre.

Dégager plus de temps en dehors du travail

Je voulais avoir plus de temps en dehors du travail, sans savoir vraiment comment faire. J’envisageais notamment d’arrêter de donner des cours chez Ingésup. C’est à ce moment-là que Caroline m’a approché pour enseigner à l’ECV Digital. Une classe de moins de dix élèves, tous alternants, sur des journées entières plutôt qu’une heure à droite ou à gauche… c’était une proposition séduisante !

Je ne voulais pas refuser mais, en même temps, je n’avais plus de congés sur lesquels donner des cours1. J’ai donc entamé une discussion avec mon employeur, Clever Age, par le biais de mon responsable d’agence Sébastien Dugué et de la responsable RH, Hélène Gat. Leur réaction a été immédiatement positive et ils m’ont soutenu en me proposant un avenant à temps partiel (à 92%, pour être précis) ! Parfait !

Sauf que… l’idée de dégager du temps en dehors du travail était principalement motivée par mon envie de passer du temps avec mes garçons. Nous avons donc discuté avec ma femme, qui avait aussi besoin de réévaluer son emploi du temps, pour intégrer davantage de constance dans nos rythmes avec les petits chats.

Désormais, je dépose les enfants presque tous les matins à l’école, à pied le plus souvent. Cela nous permet de partager le petit-déjeuner et de discuter sur le trajet. Le week-end, nous avons introduit davantage d’activités extérieures (notamment des picnics, y compris sous tente jusqu’à la moitié de l’automne). Enfin, nous avons supprimer les routines liées à la télévision2 et introduit à la place un rituel impliquant un long métrage en famille en fin de week-end.

Constat : résolution tenue !

Formaliser mes processus

En 2015, j’exprimais une volonté de mieux formaliser mes processus de travail. Cela consistait à la fois à questionner mes outils et leurs usages mais aussi à critiquer ma méthodologie pour la faire évoluer.

J’ai ainsi commencé à me renseigner sur les pratiques de mes collègues chefs de projet mais aussi sur le monde de l’Agile que je connaissais de loin, pour l’avoir pratiqué plus ou moins bien, sans toujours le comprendre, depuis 2008. Cette re-découverte avec le recul de dix ans d’expérience m’a permis de mieux en analyser les paradigmes et de mieux identifier les difficultés liées à la mise en place de la variante la plus courante : SCRUM.

La méthodologie m’a, au final, moins apporté que les outils de gestion de projet qui gravitent autour car, dans les faits, nombre de mes pratiques quotidiennes étaient déjà proches de l’agilité. En revanche, mes outils de suivi ne collaient pas, plutôt issus de paradigmes CMMI. Résultat : je constatais un décalage régulier entre l’estimation du reste-à-faire en termes de charge et de valeur. J’ai donc repris de nombreuses choses et mon outillage est beaucoup plus cohérent, aujourd’hui, avec mes objectifs.

Comme souvent, en montant en compétence, je suis devenu prescripteur et j’ai commencé à observer autour de moi quels projets pourraient bénéficier de l’approche et/ou des outils. Sans forcément que j’y réfléchisse, à un moment donné, en 2016, je me suis retrouvé à encadrer des projets en Agile et à trouver ça naturel. Il faut dire que j’ai eu l’incroyable chance de ne travailler que sur des projets où c’était tout-à-fait adapté, à la fois par le contexte mais aussi, surtout, par les personnes formidables qui y ont participé.

Je suis ravi de cette évolution. Il me reste désormais à calmer le moi-intérieur qui souhaite me mettre une claque à chaque fois que je reprends un ancien projet sur lequel ce travail d’évaluation de la valeur métier n’avait pas été fait, ou mal entretenu. Dans la gestion de projet comme dans le développement, il est toujours difficile de regarder ce qu’on a produit à une autre période de sa vie…

Constat : résolution en bonne voie, qui se concrétisera peut-être par une certification un jour, qui sait ?

Mieux gérer mon énergie

En 2015, je me plaignais de n’avoir pas pris le temps de prendre du recul sur ma propre activité pour mieux planifier mes tâches de travail. La situation n’a pas changé mais j’ai pu analyser pourquoi. D’abord, le travail en équipe ou en entreprise qui ne permet pas nécessairement d’être libre de son planning ou d’éviter les interruptions. J’ai fait quelques tentatives de Pomodoro, sans succès. Ensuite, une mauvaise maitrise de mes propres fluctuations d’endurance professionnelle. En cause : ma vie personnelle (les enfants qui ne font pas leurs nuits), mais aussi la gestion de phases, que j’ai encore parfois du mal à identifier en amont, dans lesquelles toutes les demandes convergent.

Constat : échec en 2016, à prioriser en 2017.

Me tenir droit, mieux manger

Durant toute l’année 2016, ma femme et moi avons poursuivi nos efforts pour une alimentation plus saine, à la fois pour nous mais aussi et surtout pour les enfants. Notre consommation de viande a profondément chuté (au point de passer parfois une semaine sans en préparer/consommer à la maison), et nous avons découvert de nombreuses recettes à base de légume, notamment auprès de la communauté vegan qui partage beaucoup. Bien que la fin d’année est largement sombré dans le n’importe quoi (la fin d’année, donc), c’est déjà ça.

Du côté de ma posture, j’ai noté une vraie amélioration et des conséquences sur mon bien-être au travail : meilleure digestion (plus de syndrome d’endormissement après un déjeuner copieux), meilleure concentration, disparition des douleurs lombaires. Le Better Back m’a beaucoup aidé comme tuteur le temps que certains muscles dorsaux se remettent en ordre de marche, mais n’est plus utile très souvent aujourd’hui.

En revanche, mon activité physique est toujours faible : j’ai beaucoup pratiqué la trottinette quand les températures étaient plus clémentes (au point de faire 80 km en moins d’un mois pour chasser des pokémons…) mais je penne à me motiver pour des activités physiques plus intenses.

Constat : pas mal sur 2016, mais un effort à poursuivre.

Promouvoir l’égalité, lutter contre les inégalités

L’année a été très mouvementée en ce qui concerne les inégalités. Le sujet m’a beaucoup touché et j’ai fait ce que je pouvais, ici ou ailleurs, pour y remédier.

Le ménage devant ma porte

Cela a commencé par un travail intérieur pour mieux identifier mes propres biais, notamment en parlant plus ouvertement de mes réactions instinctives avec d’autres (notamment ma femme), pour mettre le doigt sur des conditionnements et douter de leur bien-fondé. La liste de mes propres biais est fort longue, du biais culturel au biais de primauté (et de halo), de l’ancrage mental à l’aversion à la dépossession… mais se renseigner sur le sujet ne permet pas de se corriger. Il s’agit d’un travail constant de doute quant à ses propres réactions…

En tant que citoyen

On va essayer de ne pas y passer trois heures : quasiment tout ce que j’ai écrit sur mon blog « Citoyen » en 2016 concernait la perception de l’Islam en France. C’est un sujet en creux en ce moment, mais qui reviendra très fortement et de manière nauséabonde rapidement, pour servir la soupe sécuritaire à la Présidentielle. Ne vous y trompez pas, le moindre accident sera l’occasion de complètement occulter l’éducation, la Culture, l’écologie…

Brace for impact.

Au travail aussi

Professionnellement, 2016 a aussi été l’année de ma redécouverte de la Qualité Web. J’ai mis à l’épreuve mes compétences dans le cadre d’examen ou d’audits et je suis content de l’avoir fait.

Chaque test réalisé dans JAWS est un constat d’humilité. Chaque navigation au clavier est un exercice de patience. Réaliser des audits complets sur le RGAA permet de se rendre compte du chemin à parcourir pour rendre le Web accessible à tous.

Passer la certification Opquast m’a également permis de confirmer ce que je faisais depuis des années, à savoir regarder le Web par les yeux des utilisateurs qui ne le maitrisent pas, ou mal, et qui se retrouvent démunis face à des produits applicatifs mal pensés. Les différents audits réalisés dans l’année m’ont permis de mettre le doigt sur des mauvaises pratiques (pas forcément volontaires, notez bien) et de rendre certains projets un peu meilleurs.

Dans mes échanges quotidiens

En 2016, j’ai également été plus vocal dans l’expression de mes valeurs, sans pour autant y adjoindre de violence, de manière à ne plus laisser se dérouler sous mes yeux des situations qui me déplaisent. Ce n’est pas évident, il faut prendre son courage à deux mains, trouver les mots justes…

J’ai également essayé d’agrandir mon cercle d’échange et d’inclusion en m’intéressant aux initiatives qui valorisent les femmes, mais également en publiant des offres de stage sur des plateformes destinées à des jeunes de lycées péri-urbains ou en ZEP pour leur donner de l’espoir concernant les métiers du numérique qui sont, à mon sens, ouverts à tous.

En chemin, j’ai rencontré ou me suis rapproché de pas mal de gens qui pensent et agissent comme moi, mais je sens que je heurte le plafond de notre bulle de verre commune. Peu de nos actions ont véritablement un impact sur des minorités et beaucoup de choses sont entravées par des conflits endogènes.

Combien de fois les femmes féministes répètent à des hommes que le souci n’est pas de savoir à quel point ils sont « des mecs biens » ? Combien d’antiracistes expriment leur lassitude ou leur mépris face aux blancs qui se prennent pour des héros parce que « moins racistes » ou ayant fait une mission humanitaire? Il existe même des termes spécifiques: Nice Guy, White Saviour, Chevalier blanc… « Social Justice Warriors, notre violence n’est pas virtuelle », Lauren Plume

J’ai en effet rencontré de grandes difficultés avec certaines personnes… violentes, je pense que c’est bien le mot, qui ont rejeté mon propos en me cataloguant immédiatement comme (rayez les mentions inutiles) mâle blanc cisgenre hétéro valide neurotypique CSP+, utilisateur de produits propriétaires, vivant dans un des pays développés les plus riches du monde et en bonne santé (avec tous mes membres).

À raison.

C’est justement parce que je suis conscient de ma chance que j’essaie de m’intéresser aux autres et d’avoir une once de bienveillance. J’ai des problèmes, bien sûr, comme tout le monde, mais je n’ai pas trop de mal à les verbaliser, les regarder en face, les accepter pour ce qu’ils sont et comment ils me façonnent. Ce sont des problèmes qui n’entravent pas ma vie et ne changent pas la façon dont les gens me regardent ou me considèrent. Ce n’est pas le cas de tout le monde et je peux comprendre que certains portent leur propre souffrance en étendard, soient en colère…

Mais rien ne m’oblige à les écouter. J’ai progressivement appris à esquiver ce genre de militants car les discussions sont alors très longues, sans intérêt autre que celui de se rouler dans la fange ensemble. À la troisième discussion où on m’a traité de violeur, de meurtrier ou de nazi parce que je n’étais pas intégralement en accord avec le discours agressif de mes interlocuteurs, j’ai lâché l’affaire.

Au lieu d’essayer de diffuser plus largement des idées, et de chercher à améliorer le monde, on se retrouve en nombre de plus en plus petit, les plus purs possibles sur le plus de sujets possibles. On a créé une espèce de secte intolérante, où le moindre petit écart à la norme établie sera mal jugé. « Amilitant », Benjamin Bayart

Je ne comprends pas leur colère, mais ne leur refuse pas. Chacun ses luttes, chacun ses méthodes. La plupart des inégalités ont été dénoncées par l’action puis corrigées par le dialogue. Il faut de tout pour (re)faire un le monde.

Pour ma part, je réserve mon énergie afin qu’elle serve d’abord ici, à ma petite maïeutique personnelle. J’ai bien sûr toujours des discussions engagées mais uniquement avec certains membres de ma famille, de mes amis, de mes collègues… un cercle rapproché de personnes avec que je sais que je peux discuter, être en désaccord, même profond, et ensuite prendre l’apéro.

Constat : très certainement des efforts à poursuivre en 2017, 2018, 2019…

  1. J’ai donné des cours sur mes congés de salarié Clever Age pendant cinq ans… vous connaissez le principe de la solution temporaire qui dure ? ↩

  2. Elle est toujours là mais ne sert qu’exceptionellement, et jamais pour les programmes entrecoupés de publicité. ↩

"J’entre dans un magasin"

Et si le e-commerce se produisait dans la vraie vie (ou comment prendre du recul sur des pratiques qui se sont imposées et semblent naturelles, mais privent la plupart du temps l’utilisateur de tout consentement) …


J’entre dans un magasin. Une personne avec un papier et un crayon me demande si ça ne me dérange pas qu’elle prenne des notes sur ce que je fais. Je lui dis que oui mais elle n’en tient pas compte et commence. Elle me suit pendant toute ma visite. Je crois l’avoir semée à la sortie mais la retrouve dans un second magasin. Visiblement, elle recoupe ses infos.


J’entre dans un magasin. Un vendeur me regarde, puis se précipite vers moi en criant :

Ah, Hélène, vous revoilà, ça fait plaisir.

Il m’a confondu avec ma femme qui était passée par là quelques minutes avant.


J’entre dans un magasin de jouets. Une autre personne rentre après moi et m’interpelle :

Hey, je sais que vous aimez les barbecues parce que je vous ai vu au rayon grillade du Auchan avant-hier. Ça vous dirait que je vous emmène dans un magasin qui vend des barbecues ?


J’entre dans un magasin. Dans un coin, il y a 30 personnes. L’une d’entre elle me dévisage et dit à son voisin :

Il a 30 ans, c’est un homme, je crois qu’il aime l’informatique.

Le voisin dit à son propre voisin :

C’est un geek de plus de 25 ans.

La troisième personne dit à la quatrième :

C’est un très certainement un vieux qui aime les écrans.

De fil en aiguille s’enchainent les amalgames simplistes et les pertes d’informations. Pendant que je fais mes courses, la trentième personne m’approche et me propose des serviettes anti-fuites.


J’entre dans un magasin. Je suis immédiatement téléporté dans un autre magasin sans mon accord.


J’entre dans un magasin de vêtements. Il ressemble comme deux gouttes d’eau au magasin dans lequel j’étais juste avant. Les produits sont disposés de la même manière, les couleurs sont les mêmes, la musique est la même. Lorsque j’interroge le propriétaire, il me confirme :

— J’ai fait appel à une entreprise. Ils m’ont dit qu’ils avaient des modèles de magasins prêts à l’emploi. C’était pas cher alors je me suis dit que c’était pas bête. C’était un magasin de quoi, l’autre ?
— De pompes funèbres.


J’entre dans un magasin pour acheter des bougies. Un des vendeurs me recommande, pour une raison qui m’échappe, des préservatifs. Poli, je n’ose pas le rembarrer et accepte même de le suivre dans le rayon pour qu’il me présente son offre. Je finis quand même par lui dire que je ne suis pas intéressé et retourne acheter mes bougies.

Ce vendeur me propose désormais des préservatifs à chaque visite, en ajoutant parce que vous aviez l’air intéressé la dernière fois, vous m’avez suivi !.


J’entre dans un magasin pour acheter du lait. Je trouve une bouteille et m’apprête à l’acheter quand je me rends compte qu’il s’agit de lait entier, alors qu’il me fallait du demi-écrémé. Je repose la bouteille et prends une autre qui correspond mieux à ma liste.

Depuis, chaque fois que je reviens dans la boutique, on me propose du lait entier en me demandant pourquoi je n’ai pas « finalisé mon achat ». Je n’aime pas le lait, je faisais une course pour un ami.


J’entre dans un magasin, accompagné de mon chef. Je veux lui montrer des modèles d’agrafeuses qui seraient parfaites pour le bureau. Un vendeur me colle aux basques.

— Monsieur Schapira, j’ai reçu une superbe livraison de rhum vieux. Une bouteille ?
— Non, merci. Ce n’est pas le moment.
— Vous êtes sûr ? Pourtant, vous avez acheté 5 bouteilles ces trois derniers mois, je sais de source sûre que vous buvez du rhum.
— C’est vrai, j’apprécie le bon rhum, mais vous voyez, là, je suis accompagné. Et puis quand même… il est 9h du matin !
— Et ?


J’entre dans un magasin. Enfin, j’essaie. Devant la porte se trouve un molosse qui me parle d’un produit qui ne m’intéresse pas. Apparemment, il faut que j’attende qu’il ait fini pour entrer. Patient, je le laisse réciter son laïus. Une fois qu’il a fini, il se pousse et je me retrouve face à une seconde armoire à glace qui me demande si je veux qu’il m’emmène dans un autre magasin de l’enseigne « où on fait ses courses plus vite ».

Je ferais mes courses plus vite si je pouvais entrer.


J’entre dans un magasin, le vendeur me demande si j’ai prévu de dîner en famille ou avec des amis ce soir et s’il peut s’inviter pour parler de son magasin.


J’entre dans un magasin et fais mes courses. Arrivé devant la caisse, je vide mon chariot sur le tapis et découvre avec stupeur des produits que je n’ai pas choisi. Je me retourne vers le vendeur qui m’explique qu’il a un collègue qui ajoute des produits dans les chariots pendant qu’on fait nos courses. Sans nous prévenir.


J’entre dans un magasin et fais mes courses. À la caisse, la vendeuse me demande si je ne suis pas certain d’être sûr de refuser qu’un livreur me dépose des publicités dans la boite au lettres de mon domicile. Je ne comprends pas la phrase, je ne sais pas quoi répondre.


J’entre dans un magasin pour acheter du papier toilette. Au moment où j’arrive devant le rayon, un vendeur se jette vers moi et me saisit par les épaules :

Un acheteur vient d’acheter du TorcheCulcul Triple Épaisseur !

et il s’en va. Il revient cinq minutes après en courant. J’ai à peine le temps de le voir passer et dire :

Vite, un autre acheteur vient d’acheter du TorcheCulcul Triple Épaisseur !

Intrigué, je me dirige vers le TorcheCulcul Triple Épaisseur. Il ne reste qu’un lot.

Mr Schapira, dernière chance pour du TorcheCulcul Triple Épaisseur ! Après, ça sera trop tard !

Cette fois, j’ai compris. Je prends le TorcheCulcul Triple Épaisseur et je repars avec. Le vendeur, satisfait, va chercher son chariot élévateur. Il a une pleine palette de TorcheCulcul en stock, à remettre en rayon.


J’entre dans un magasin. Le vendeur me dévisage de haut en bas, mais reste perplexe. Il finit par s’approcher et me demande :

— Excusez-moi, êtes vous un homme ou une femme ?
— Pardon ?
— Êtes-vous un homme ou une femme ? J’ai besoin de cette information pour vous accueillir et vous diriger vers les produits qui vous intéressent.
— Euh, je suis un homme…
— Très bien.

Je pose ensuite quelque questions et on m’aiguille vers le produit qui m’intéresse. Il est bleu avec un autocollant de super-héros. J’adore les super-héros, je décide de le prendre. À la caisse, on me demande mon nom, ma date de naissance et ma profession. Je suis un peu gêné et refuse mais il insiste. Si je veux des informations sur le produit, il faut que j’obtempère. Je lui donne donc ce qu’il demande.

Infirmier, vous êtes sûr ? Vous ne seriez pas plutôt infirmière ? Cet orthographe est plus répandue parmi nos clients.


Kintsugi

Le kintsugi (ou kintsukuroi) est un art issu d’une technique japonaise qui date du 15e siècle consistant à réparer les céramiques brisées avec de la laque saupoudrée de poudre d’or. Au lieu de cacher les cicatrices de l’objet brisé ou fragilisé, le kintsugi les valorise. Au lieu de n’avoir une existence dans l’instant, l’objet s’enrichit d’une histoire qui raconte ses faiblesses et le rendent unique.

Notre société consumériste cultive très souvent l’illusion que ce qui est neuf, lisse, identique à l’idée qu’on s’en fait… a plus de valeur que ce qui a vécu. Le kintsugi nous rappelle la beauté qui existe dans nos cicatrices, qu’elles soient visibles ou invisibles.

Un bol en céramique parsemé de jointures d'or qui laissent paraitre qu'il a été au préalable brisé

Un exemple de kintsugi

Le kintsugi se rapproche ainsi du wabi-sabi, un mouvement plus général qui s’intéresse à l’unicité,à l’existence, aux imperfections. Il y a dans cette philosophie quelque chose de simple, de sobre et de modeste qui nous manque parfois cruellement, ici, en Europe.

Un Web au Futur

Cet article a été rédigé dans le cadre de #nowwwel, une initiative lancée par Rémi Parmentier (@hteumeuleu) pour remplacer cette année les 24 jours de Web, les deux événement ayant pour but d’inciter les professionnels du Web à écrire et partager.

Si cet article vous plait, n’hésitez pas à me remercier d’une des façons suivantes (suivant votre budget et votre temps disponible) :

  • publiez une offre de stage sur Viens voir mon taf pour offrir de l’espoir à des jeunes qui pensent nos métiers inaccessibles, à tort ;
  • embauchez, recommandez, rémunérez des femmes et incitez-les à s’organiser et s’auto-promouvoir, par exemple via Girlz In Web ;
  • formez-vous à la qualité, l’accessibilité ou l’écriture inclusive pour essayer de produire chaque jour un Web plus ouvert.

Votre dernier projet parfait vient de se terminer :

  • une démarche utilisateur a été menée pour bien en définir les usages ;
  • une conception visuelle composée de diverses itérations a permis d’aboutir à une expression graphique traduisant parfaitement les intentions des parties prenantes ;
  • le site est adapté aux périphériques mobiles, aux tablettes et aux ordinateurs par le biais de différentes media-queries, d’une intégration fluide et de diverses adaptations suivant les usages supposés sur les différentes plateformes ;
  • le Front comme le Back reposent sur un socle technique solide, composé de diverses solutions spécialisées, agrémentées de nombreuses dépendances à des librairies tierces ;
  • des services tiers ont été sélectionnés et intégrés pour fournir des fonctionnalités spécifiques sans besoin de développements ;
  • enfin, le site est hébergé par une entreprise indépendante qui infogère le serveur.

De nombreuses démarches fonctionnelles et techniques ont été entreprises, à chacune des étapes citées, pour que le site soit à l’état de l’art au moment de sa sortie…

La grande illusion

L’exemple ci-dessus vous fait rêver ? C’est normal. Nous espérons que l’ensemble de nos projets se passe comme ça. Une seule chose pourrait vous chiffonner… Personne, à aucun moment, ne s’est demandé combien de temps le site allait rester en ligne.

Trois mois ? Trois ans ? Cinq ans ? Sept ans ?

Personne ne s’est interrogé sur la pertinence des choix réalisés au regard de cette durée ou la façon dont il pourrait évoluer. Ce site est parfait… maintenant.

En tant que professionnels, nous pensons souvent les sites que nous réalisons comme des objets finis répondant à des objectifs définis et immuables. Nous partons de l’expression d’un besoin à un instant donné, en oubliant souvent que pour nos commanditaires, le site n’est qu’un outil construit pour répondre à des objectifs autres. Comme tous les outils, il doit être capable de durer… et aussi de s’adapter.

Bonne impression ?

Dans la grande famille des éléments dont la satisfaction ne peut que décroître avec le temps se trouve la conception graphique. Toujours pensée pour laisser un souvenir impérissable et porter les valeurs fortes du projet, elle se transforme bien souvent en boulet au bout de quelques années.

Parfois, il s’agit d’une direction artistique très prononcée qui rend difficile l’ajout ou la modification de composants visuels (ô, designs obliques, je pense à vous). D’autres fois, la dépendance entre design graphique et design d’expérience est si importante qu’il devient impossible de modifier l’un sans affecter l’autre. Pourtant, un site n’est souvent réalisé qu’en envisageant en amont des personas qui schématisent les utilisateurs réels… dont on peut affiner le profil par le biais des analytiques. Il y a donc de fortes chances qu’il faille adapter le design a posteriori…

Quel est votre site favori ? Pensez à ce site, qu’y faites-vous ? Est-ce que vous visualisez bien les éléments-clés de sa conception visuelle ou est-ce que votre souvenir de l’expérience concerne l’ensemble du service ?
Il existe, bien sûr, des sites dont l’attrait visuel fait intégralement partie de la proposition de valeur. C’est notamment souvent le cas lorsque le visuel participe au positionnement d’une marque ou d’un secteur dans un domaine spécifique. Pour ces sites, une conception visuelle qui valorise le secteur, la marque ou la relation à l’utilisateur est primordiale.

Bien souvent, en discutant avec des clients et en les interrogeant de manière répétée sur leurs objectifs à long terme, ils concluent que l’aspect du site n’a pas besoin de laisser un souvenir impérissable : l’aspect exceptionnel, celui qui va laisser une impression incroyable… est souvent demandé pour séduire le sponsor.
La valeur de ce design à long terme (plusieurs années) est très réduite et un design moins original, plus modulable et pouvant s’adapter à différentes chartes graphiques au fil du temps, est en réalité bien plus pertinent, même si moins impressionnant le jour de la mise en Production.

Technologies

Autre problème lié au design graphique, où plutôt à sa déclinaison : la prise en compte du parc matériel dans la conception du Responsive Web Design. Problème : nous sommes assez nul quand il s’agit de prévoir le parc matériel du futur. Certains se sont emballés pour les Pocket PC, les netbooks, le retour des téléphones à claviers (ouais, ok, il n’y avait que Nokia à y croire, mais quand même), les tables basses (coucou Microsoft), les montres, la réalité virtuelle. Rares sont les innovations qui perdurent et nous sommes aujourd’hui sur un marché massivement dominé par les smartphones.

Même en sachant cela, il est très difficile d’envisager l’avenir. Ayant cherché récemment un smartphone avec un écran de quatre pouces, j’ai découvert que ce segment avait quasiment disparu au profit de modèle plus grand. Je me rappelle pourtant bien, il y a cinq ans, quand mes amis se moquaient de l’énorme taille de mon OnePlus One. Tout change.

Indépendamment de la taille, il est très difficile d’envisager, à court ou moyen terme, les résolutions des matériels. Après plusieurs années à clairement séparer les usages mobiles et de bureau en fonction des résolutions, nous constatons que les résolutions des smartphones d’aujourd’hui sont de plus en plus proches de celles des ordinateurs, avec en plus une gestion de la densité de pixels imprévisible (qui dépend, en réalité, des capacités de productions). Bref, le matériel permettant de consulter le Web, c’est le bordel.

En bref, le passé nous apprend que nous ne sommes absolument pas compétents pour deviner les évolutions du parc Web à plus de trois ans. Pourtant, nous continuons à imaginer nos points de rupture en fonction des matériels et des analytiques à notre disposition. Paradoxal, non ?

Il existe d’autres façons d’envisager le design d’un site web, comme la conception des points de rupture à partir de la taille et des ratios des images, couplée à une lecture optimisée et des tailles de polices adaptées : en bref, partir du contenu et imaginer vos points de rupture uniquement comme des adaptations sur un design fluide. Nous avons toutes les clés techniques pour ce genre de choses et la littérature existe.

Et si on construisait nos designs sur ce qu’on connait plutôt que sur d’hypothétiques futurs ?

Un colosse aux pieds d’argile

Construire une solution logicielle pour répondre à un besoin, ça commence par fournir une architecture solide. Pour cela, il est conseillé d’utiliser des outils éprouvés car quelle que soit la solution utilisée ou le langage sur lequel elle repose, votre projet embarquera, un jour ou l’autre, des dépendances (rappelons qu’un framework est une dépendance). Le choix de ces dépendances ne doit pas être opportuniste et uniquement se reposer sur la correspondance avec le besoin immédiat, vos capacités au moment de la réalisation ou vos envies personnelles de vous « amuser » avec une nouvelle proposition (patience, nous allons y revenir).

Il vous faut également imaginer l’avenir de cette dépendance.

  • Sera-t-elle maintenue sur la durée ? Existe-t-elle depuis longtemps ?
  • Est-elle utilisée par de nombreux utilisateurs et qu’en pensent-ils ?
  • S’il s’agit d’un projet jeune mais qui fait parfaitement le travail, existe-t-il un projet plus ancien qui le ferait également, moyennant quelques développements supplémentaires ? Passer par cet autre projet apporterait-il quelque chose (par exemple : la communauté du projet plus ancien est-elle plus grande et la littérature plus importante) ?
  • Cette dépendance est-elle open source ? Est-elle régulièrement mises à jour, avec une prise en compte de la compatibilité descendante et une roadmap lisible ?
  • Est-elle soutenue ou maintenue par plusieurs personnes ? Par qui la gouvernance est-elle détenue ?
  • Sont-elles faciles à prendre en main pour un nouveau venu ? Quelle est la quantité de documentation qu’il vous sera nécessaire de produire pour lui mettre le pied à l’étrier ?
  • Une fois le projet en Production, les dépendances sont-elles versionnées quelque part, de manière à pouvoir les retrouver si elles venaient à disparaitre ?

La manipulation des dépendances est également un point d’attention :

  • Qu’utilisez-vous pour lister vos dépendances, pour les mettre à jour ?
  • Ce produit/projet étant lui-même une dépendance, répond-t-il à toutes les questions ci-dessus ?

La maïeutique de ces questions peut sembler abstraite, alors autant expliciter : vos outils de développement et la manière dont vous vous en servez font partie intégrante du projet.
Que se passera-t-il dans quatre ans, quand une développeuse ou un développeur voudra installer les dépendances que vous n’aurez pas listé et qu’elle ou il ne trouvera plus rien ? Pour Noël, soyez sympas : évitez à cette personne d’être obligé d’aller décompiler vos ressources obfusquées pour deviner ce que vous avez utilisé et comment. Est-ce que vous êtes obligés d’utiliser un outil de gestion des dépendances ? Non, de la documentation, c’est bien aussi. Pensez-y, c’est parfois tellement plus simple !

Penser à la quatrième dimension

Le bon code, c’est le code que je comprends. « Le bon code », CommitStrip

La structure de votre code n’a pas qu’une incidence sur votre projet. Un bon code est avant tout un code facile à comprendre et pour cela, il faut connaître les bonnes pratiques et les patterns régulièrement utilisés, mais aussi prendre sur soi pour éviter les couches d’abstractions inutiles.

Oui mais attends, il n’y a rien de pire que de refactoriser un code avec du copier-coller partout.

Je préfère cinq copier-coller qu’une Factory sur laquelle repose un service injecté dans quatre modules différents. Je me suis toujours beaucoup méfié de l’acronyme DRY et je vous encourage à toujours lui préférez KISS quand les deux sont possibles : souvent, une petite répétition vaut mieux qu’une énorme usine à gaz.

Ça a l’air simple mais ça ne l’est pas : certains d’entre vous ont un très bon niveau et ce qui peut leur sembler naturel ne l’est pas forcément pour les autres. Sachez donc adapter la complexité de votre code au projet. Un projet important à plusieurs centaines de jours×personne nécessitera une toute autre architecture que celle à mettre en place pour un projet réalisé en deux mois !

N’oubliez pas : un projet de qualité est aussi un projet à Bus Factor élevé, donc à réversibilité importante. Cela peut passer par la documentation mais souvent, cela passe par la simplicité du code !

On évite donc au maximum les conventions mal partagées (donc pas si conventionnelles que ça), les abstractions de code dans la configuration (pour être sûr que le futur développeur ne pige rien), les surcharges par héritages de modules mal balisés (Putain, mais elle vient d’où cette classe ⁈)… Bon, je m’arrête là, vous savez de quoi je parle. Mais si. Allez, pensez à vous-même, il y a six mois, deux ans, cinq ans… quand vous ne pigiez pas le code de votre collègue plus expérimenté. Voilà. Là, gardez cette pensée.

Essayez d’écrire du code pour ce « vous » du passé. Ça servira à quelqu’un dans le futur.

Résistons aux tentations et à l’excitation

Notre secteur est particulièrmeent dynamique. L’innovation est partout et nous l’expérimentons chaque jour. Il est même possible d’en faire des jeux à boire.

Résultat : beaucoup d’entre nous se lancent sur de nouvelles technos pour s’amuser, et c’est une très bonne chose. Cela ne veut pas dire qu’il faut absolument la mettre dans vos projets en Production ! L’utilisation d’une techno ou d’un paradigme doit faire le choix d’une vraie réflexion, pas être un caprice. Nous avons tous des dizaines de side-project pour tester, prototyper, confronter ces technos (et notre connaissance) à des cas d’usages du réel.

Quelques exemples dont j’ai complètement conscience du potentiel trollesque :

  • Les frameworks SPA sont normalement faits pour faire… des applications ! Le web étant principalement constitué de documents, inutile d’en voir partout. Si vous décidez d’en utiliser un, sachez pourquoi et exploitez-le. Un pile Front-End, ça se mûrit, même chez les meilleurs. Ce n’est pas grave si vous n’êtes pas encore prêt pour la dernière nouveauté.
  • Les frameworks CSS/JS de composants : un composant bien écrit, bien documenté, validé par la communauté des développeurs et des fabricants de navigateurs au travers de réflexions et d’usages, ça s’appelle un standard. Travaillez sur les standards, apprenez à vous en servir à leur plein potentiel, bossez sur l’accessibilité pour obtenir un regard critique (comme de vous demander quels sont les cas d’usages de <dt> et <dl>, par exemple).
  • La mode récente à la containerisation et à l’utilisation de microservices est très sensée et peut s’expliquer par énormément de facteurs, la plupart étant liés à l’explosion des infrastructures distribuées, y compris sur des phases de développement (les containers permettant d’effectuer des tests automatisés de haute volée). Sur des petits projets, c’est clairement de la complexité pour pas grand-chose. Et ne venez pas me dire que vous avez mis en place la stack en « pensant à plus tard ». Soyez lucide sur votre projet et posez-vous véritablement la question de la pertinence.
  • Node est une plate-forme très prometteuse mais les solutions répondant à des besoins métier sont peu nombreuses (voire inexistantes). La plupart des projets importants reposent sur des socles de dépendances très mouvant. Node.js lui-même n’offre des garanties que de manière très récente avec des versions Long Time Support disponibles uniquement depuis octobre 2015. Est-ce qu’il faut se lancer dessus ? Assurément. Est-ce que c’est une Silver Bullet qui viendra à bout de vos problématiques ? Probablement pas.

Si vous pensez que vous êtes prêt à utiliser quelque chose de nouveau, faites-le sur des éléments non-essentiels du projet, ou sur des projets de faible importance. Faites-le en connaissance de cause, en ayant établi une matrice des risques potentiels et faites suivre le projet par une personne de confiance qui saura vous indiquer quand vous allez trop loin dans l’obstination. Enfin, faites-le en binôme (au minimum). On n’apprend jamais aussi bien que quand on s’explique mutuellement les choses.

Ne jamais perdre l’objectif de vue

C’est peut-être une évidence, mais un projet ne finit pas au moment où on le livre : il commence. L’ensemble du travail réalisé sert un objectif qui commence à peine à être rempli au moment de la mise en ligne et continuera de vivre et d’évoluer pendant plusieurs semaines, mois, années après l’ouverture aux utilisateurs.

Contrairement à vous, vos commanditaires ne sont pas nécessairement des professionnels du Web. Ils ne peuvent pas, la plupart du temps, envisager un certain nombre d’évidences qu’il est parfois à votre charge d’expliciter.

Prenez donc le temps, en amont, de réfléchir à la pérennité de ce que vous produisez et prenez vos décisions en gardant en tête que :

  • un site, ça se maintient, par des acteurs qui doivent avoir à la fois le savoir, le savoir-faire et informations nécessaires à l’exécution des tâches qui leurs seront confiées. Pensez au futur : pensez à elles ;
  • la solution n’ayant aucun bug n’existe pas : tant que les logiciels seront créés par des humains, ils contiendront des erreurs. Privilégiez les solutions mettant rapidement des correctifs à disposition et dont la communauté est saine. Vous savez peut-être distinguer un bon d’un mauvais module. Rien ne garantit que votre successeur sera dans le même cas.
  • si le code n’est pas compréhensible en l’état, envisagez la formation nécessaire à la mise à jour technique des solutions et maintenez l’information sur cette « dette de formation » dans le temps, ainsi que les noms des personnes pouvant la combler.
  • pensez à prévenir vos commanditaires que la maintenance a un coût et que le marché n’est pas homogène. Est-ce qu’il est plus facile de trouver un développeur PHP ou un développeur .NET ? Est-ce que chaque surcoût s’associe d’un avantage qui a du sens pour le projet ? Suivant la typologie financière, technique ou culturelle du client et des types de solution recherchées, cette question est pertinente !
  • La documentation d’installation, de développement, de mise en Production vous gonfle ? Écrivez des scripts versionnés. Ils vous serviront durant le développement et feront un excellent point d’entrée pour vos successeurs.

Demain ne meurt jamais

Vous l’aurez compris : pour Noël, je voudrais que nous réalisions tous que faire un site Web aujourd’hui, c’est avant tout le réaliser pour demain, pour la personne qui s’en occupera après nous et dans l’optique que l’ensemble dure plusieurs années et soit aisément maintenu.

Pour faire quelque chose de pérenne, il faut autant comprendre le présent qu’imaginer l’avenir, mais rien ne sert de l’appeler trop fort. Il n’est pas sourd et arrivera bien assez vite.


Des ressources m’ont été proposée par Antoine Fauchié, et elles ont entièrement leur place ici. Si l’article vous a plu, n’hésitez pas à creuser en lisant :

Un stagiaire

Après une semaine, voici l’heure du départ pour notre futur ex-stagiaire.

Recevoir un stagiaire est toujours une petite découverte. On ne sait jamais si la personne sera attentionnée, attentive, curieuse ou si, au contraire, elle observera l’activité sans réaction, sans questions, sans esprit critique. Cette fois, c’était plutôt une bonne pioche !

J’ai commencé il y a quelques années. Par curiosité, je dois dire. Et puis j’ai découvert ViensVoirMonTaf, une initiative qui permet à des jeunes de découvrir ce qui, parfois, semble pour eux impossible.


Nous avons beaucoup parlé mais il est parfois difficile pour moi d’expliquer tout ce que je fais à voix haute, donc nous avons trouvé un subterfuge. Il s’est posté face à moi et j’ai configuré mon second écran en recopie, tourné vers lui. Ainsi, entre deux moments d’échange, il avait le loisir d’apprendre en autonomie tout en pouvant jeter un œil à mon écran de temps en temps et poser des questions quand il le souhaitait.

Je lui ai rapidement donné des consignes pour qu’il prenne des notes et me fasse, chaque matin, un résumé organisé de ce qu’il avait appris. Cela me permettait d’évaluer les capacités de rétention mais aussi de corriger dès le lendemain une perception qui serait erronée.

Expliquer la technique n’a finalement pas été très dur. Les concepts fondamentaux du Web ont la force d’être simples et j’avais la chance de travailler, à ce moment-là, sur un audit lié au Front-End. Il a ainsi pu comprendre rapidement les problématiques et m’a même surpris, à deux reprises, par des réflexions pleines de bons sens dont je ne le croyais, à tort, pas capable.

Mais les échanges les plus détaillés concernaient la vie de l’entreprise. Nous avons beaucoup parlé du rôle d’un consultant, de l’ambiance de travail, des missions, de l’organisation du temps, de la culture d’entreprise, des différentes entités internes (tant au niveau managérial que dans la représentativité), des salaires, des évolutions de carrières, de l’âge…


Accueillir un stagiaire de troisième et prendre le temps d’échanger avec elle ou lui est, je pense, une affaire cruciale. Pour ces enfants, d’abord, car il s’agit de leur premier contact avec le monde de l’entreprise (beaucoup n’ont pas conscience du travail de leurs parents et en sortent bien plus curieux qu’avant). Pour nous, encore plus.

Quand nous rencontrons un problème dans la formalisation d’une problématique technique en code, nous avons quasiment tous l’habitude de parler à un collègue pour essayer de dénouer la situation. Un stagiaire de troisième, c’est le canard en plastique du monde du travail. C’est en lui expliquant votre vie professionnelle que vous allez mettre rapidement le doigt sur ce qui peut la rendre compliquée ou, au contraire, géniale (ou les deux, chacun ses goûts).


Parfois, les parents des stagiaires viennent. Le premier jour, pour nous demander de prendre soin de leurs bouts de chou. Le dernier jour, aussi, parfois, pour nous remercier. Une fois, une mère s’est mise à pleurer. Son fils lui avait dit la veille qu’il avait envie de retourner au collège. Il avait découvert quelque chose et voulait désormais faire des études.

Bien sûr, tout n’est pas toujours rose. J’ai reçu des stagiaires qui venaient en survêtement. D’autres qui faisaient du bruit. Ce sont des enfants. Si nous ne sommes pas capables de partager et d’apprendre à nos enfants, à quoi sert notre société ?


Les sujets abordés

Je jette ce à quoi je pense, j’essaierai d’alimenter davantage ultérieurement :

  • Ambiance :
    • Manière dont les gens s’adressent les uns aux autres et se placent dans les bureaux.
    • Utilisation de l’anglais, du franglais, d’un vocabulaire un peu spécifique au digital (et vive les doigts).
    • Comment on se bat avec nos outils tout le temps !
  • Technique :
    • HTML (la sémantique : donne un sens aux choses qu’on écrit à l’intérieur), CSS (coordonne la présentation), JS (permet d’ajouter des comportements et des interactions ou de pallier à certains problèmes d’implémentation)
    • Suivi du tutoriel HTML/CSS OpenClassRoom pour avoir les bases (en tâche de fond)
    • Front-End (tout ce qui se voit) != Back-End (ce qui ne se voit pas)
    • « Architecture » = organiser toutes les tâches et machines dans le Back-End, pour mettre en place la logique
    • Une « machine virtuelle » : c’est quand on fait tourner un programme qui fait tourner tout un autre ordinateur dans son ordinateur. Exemple : faire tourner Windows dans un Mac.
    • Les machines de travail sont ultra-puissantes et très chères.
    • Réinventer la roue tout le temps n’est pas productif. Les développeurs passent leur temps à la fois à réutiliser des composants, des morceaux d’applications, des applications entières comme on assemble des Legos.
    • Il y a beaucoup de termes technique très verbeux, souvent des acronymes. Il faut prendre du recul. En bricolage, un outil qui enfonce des clous s’appelle un marteau. Dans le numérique, un outil qui enfonce des clous s’appelles un OQEDC (Outil Qui Enfonce Des Clous). Résultat : parfois, on s’en sort plus trop. Pourtant ça reste des marteaux.
  • Organisation du travail :
    • Le Web : un domaine, plein de métiers :
      • le(s) graphistes (illustrateurs, webdesigners…) ;
      • le(s) Front-End (le Web, le mobile, autre ?) ;
      • le(s) Back-End : en général, du PHP (langage) mais rarement seul. Souvent, on part d’un programme existant (on a cité de Drupal, eZ Publish, Wordpress) et on essaie d’étendre…
    • Gestion de projet en cascade (une étape après l’autre), en V (une étape valide l’autre), en Agile (un gros projet découpé en plein de tous petits engagements de 2 à 4 semaines)
    • Une « équipe projet »… une définition floue entre les rôles, les emplacements physique, une tribu aux intérêts commun… le rôle du CP est de coordonner tout ce petit monde en fluidifiant leurs allées et venues sur le projet.
    • Comment évaluer une entreprise : les paliers en salariés, en chiffre d’affaire, en confiance bancaire…
    • Le différentes obligations administratives d’une entreprise, les problématiques qu’elles soulève (ne serait-ce que la paie et sa complexité), les différentes fonctions support, les entités de dialogue sociale, les budgets socio-culturels du Comité d’Entreprise…
  • Impacts sociétaux :
    • L’informatique détruit des emplois en automatisant des tâches. Il est donc nécessaire, lorsqu’on transforme l’organisation d’une entreprise autour du numérique, d’envisager des reconversions par la formation.
    • On a l’impression que le Web est partout, mais ce n’est pas vrai. Beaucoup de population sont encore hermétiques ou faiblement concernées (le Web n’existe que de manière très limitée dans leur vie).
    • Les gens sont intelligents, les machines sont bêtes : une personne peut faire une erreur mais quand elle s’en rend compte, elle peut revenir dessus. Les machines ne font normalement pas d’erreurs mais quand elles en font, elles s’en fichent. Sans contrôle humain, tout peut partir en cacahuètes assez rapidement.

Enseigner et apprendre

En parlant de la difficulté d’aider un étudiant pendant un travail dirigé :

Il va falloir comprendre ce qu’il a fait, ce qu’il a voulu faire, comprendre où est son problème, comprendre comment le corriger et comprendre comment lui expliquer. Et tout ça en cinq secondes. « D’imposteur à mentor », Matthieu Bué

Enseigner, c’est l’assurance d’être perpétuellement mis au défi et donc, d’apprendre soi-même. Je n’ai jamais vécu deux fois le même cours et je pense que cela n’arrivera jamais. Il ne s’agit pas d’apprendre aux élèves ce que l’on sait faire : cela n’a aucune importance, en réalité. En plus, c’est un savoir qui est rapidement obsolète.

La clé, c’est de réussir à leur apprendre à apprendre ce que l’on sait faire mais le problème, c’est qu’ils n’apprennent pas nécessairement comme nous avons appris, donc il faut arriver à les positionner dans une dynamique de réalisation qui les investit dans leur savoir. En plus simple : ils ne retiennent que ce qu’ils font et ne doutent que de ce qu’ils font à plusieurs, en s’analysant les uns les autres.

Enseigner, c’est leur apprendre à trouver en eux les clés pour s’interroger, aller plus loin, déterminer des patterns dans leurs productions, dans les projets, dans les porte-feuilles, dans le marché, dans leur propre tête. Déconstruire son environnement pour mieux construire à l’intérieur.

Certain sont parfois désemparé par mon honneteté, quand je leur dis ce que j’attends d’eux. Il faut dire que je n’ai aucun doute sur le fait que mes élèves sont plus jeunes, plus dynamiques, plus intelligents et ont bien plus de temps libre que moi. Armés des bons outils méthodologiques et d’un jeu de compétences techniques de base, il me semblerait normal qu’ils deviennent tous, à terme, de meilleurs professionnels que je ne le suis.

Réduire le suivi

Récemment, on m’a rapporté trois anecdotes d’avant-vente comportant des demandes du prospect de réduire la quantité de jours associés au suivi du projet. Je pense que ça mérite une discussion.

Demander à réduire un coût global, je comprends. Nous avons tous des objectifs financiers et il faut que le coût des prestations rentre dans le cadre d’un budget souvent voté en amont. Les prestataires, si tant est qu’ils ont des marges de manœuvres sur le périmètre ou les délais, peuvent souvent trouver des solutions alternatives pour mieux coller à une cible budgétaire.

Demander à réduire un coût au profil, cela me semble négociable dans la limite du raisonable. En dessous d’un certain coût, il est difficile d’assurer la qualité des compétences (notez que je n’ai pas dit que c’était impossible, on trouve des développeurs excellents et peu chers, notamment quand ils ne savent pas qu’ils sont excellents) mais à l’inverse, un coût élevé ne garantit pas non plus une compétence, donc je peux comprendre que cela se discute.

Réduire les exigences de qualité peut permettre de réduire le coût, au dépend de nouveaux risques. C’est un choix qui se discute et qui peut exclure un certain nombre de prestataires qui refuseront de participer à ce type de projets risqués pour leur réputation. Mais si on sait à l’avance que la durée de vie du projet est faible ou qu’il est destiné à une cible très identifiée, je peux entendre qu’on réduise volontairement son accessibilité, son respect de certaines bonnes pratiques ou sa résistance à la régression.

Demander à réduire arbitrairement le volume de suivi, c’est en revanche se tirer une balle dans le pied. C’est expliquer clairement qu’on souhaite sacrifier la qualité, mais ne pas préciser en quoi. C’est également nier le rôle de facilitateur du Chef de Projet (ou du Scrum Master) et penser que les développeurs sauront seuls trouver les réponses à leurs interrogations sans jamais perdre de temps. C’est supposer qu’une équipe est un endroit où les conflits n’arrivent jamais et qu’aucune résolution ne sera nécessaire. C’est imaginer qu’un projet n’est pas réalisé par des femmes et des hommes, mais par des ressources qui ne commettent pas d’erreurs, ne doutent pas et comprennent parfaitement le besoin, le projet, le planning et le budget. C’est une façon de faire que je déplore car elle aboutit souvent à une moins bonne expérience utilisateur (le produit est moins bien pensé), une maintenabilité dégradée et un coût final plus elevé mais caché, car composé d’enveloppes non-budgetisées et/ou de dépassements du côté du prestataire.

La plupart du temps, la décision de tailler s’appuie sur la finesse de rédaction des spécifications : « puisque nous savons ce que nous voulons, nous n’avons pas besoin d’une personne pour assurer la conduite du chantier ». Imaginez faire pareil avec une maison, ou prendre en main votre voiture chez un concessionnaire en ayant explicitement demander à ce qu’on ne contrôle pas les freins.

Si vous avez un doute, demandez des explications sur ce qui est inclus dans ce suivi, les engagements de vos potentiels partenaires et leurs méthodes de travail. Discutez sur les types de réunions, les types de livrable, intéressez-vous à la proposition et faites des commentaires. Il y a souvent des choses à apprendre pour l’ensemble des acteurs et le projet ne pourra s’en porter que mieux.

Ma première radio

J’ai été invité par les enfants du club radio de l’association Ricochet pour parler du Web et de mon métier. Nous avons aussi parlé de qualité, d’accessibilité, de sécurité… J’ai été très surpris par la maturité des questions posées !

C’était une expérience nouvelle pour moi et, je dois dire, très effrayante. C’est une chose de parler devant des adultes en conférences ou devant des étudiants en cours, c’en est une autre de parler à des enfants qui ne connaissent pas du tout le sujet sur lequel ils posent des questions.

J’ai essayé d’être le plus vulgarisateur possible, au risque de passer pour un simplet à certains moments (et de parler beaucoup plus lentement que d’habitude). J’ai été pris de court par le direct quand un des enfants m’a annoncé qu’il faisait du Scratch en classe, et je me suis retrouvé à dire que c’était une bonne chose alors que je pense le contraire. Les aléas du direct !

Heureusement, j’ai pu préciser ma pensée avec les enfants : ils étaient insatiables de questions et nous avons échangé pendant bien 45 minutes après l’enregistrement.

Un immense remerciement à Laurent Spadotto, de la radio associative TooBordo, pour tout son investissement auprès des enfants, son accueil et son accompagnement dans la préparation de cette interview qui restera un chouette souvenir avec des gens chouettes dedans !

Un hook de pre-commit global pour ne jamais contribuer un var_dump

On commence par définir le modèle de hooks de pre-commit.

  1. Créer un dossier dans votre profil qui hébergera vos templates de création de projets (ce template sera utilisé ensuite à chaque initialisation) :

    git config --global init.templatedir '~/.git-templates'
    
  2. Créer un répertoire dans ce dossier pour stocker les hooks :

    mkdir -p ~/.git-templates/hooks
    
  3. Contribuer votre script de pre-commit dans ~/.git-templates/hooks/pre-commit. Pour interdire les var_dump, par exemple :

    #!/bin/sh
    
    VAR=$(git diff | grep -w "var_dump")
    if [ -z $VAR ]; then
    echo "Oups, tu as laissé un var_dump…"
    exit 1
    fi
    
  4. Faire en sorte que le script soit exécutable

    chmod a+x ~/.git-templates/hooks/pre-commit
    
  5. Réinitialiser chaque dépôt pour que le template soit pris en compte :

    git init
    

Si votre projet contient déjà des hooks, cette commande ne fera rien. À vous de vous responsabiliser pour aller supprimer vous-même les scripts présents dans le dossier .git avant de re-jouer git init.

Si vous voulez allez plus loin, il existe plusieurs projets proposant des hooks dédiés à des tâches définies. Par exemple, sous PHP, Grumphp.

Le toréador

Ce nouveau besoin vient de tomber. Personne ou presque ne sait comment y répondre techniquement. Heureusement, il est là : votre rock star, votre pièce maitresse, celui qui n’a pas peur de faire face à la bête à cornes : le Toréador.

Le Héros des Mythes

Ayant le sens du défi, il prend immédiatement le besoin au sérieux et y apporte des réponses d’une technicité admirable. Il propose de vous libérer, de vous enlever cette épine du pied en intervenant rapidement de manière autonome et efficace, comment refuser ? Vous n’aviez pas prévu tout cela et lui propose, de son propre chef, de vous sauver d’un décalage dans votre planning et d’efforts de compréhension ! Vous le remerciez et lui confirmez son intervention. Hercule des temps modernes enfermé dans un labyrinthe logiciel, le voici déjà qui analyse le problème et propose des pistes.

Quelles heures après, le projet a trouvé son maitre. L’intervention du Toréador a été rapide, plus rapide que n’importe qui d’autre à qui vous auriez confié cette tâche. Vous ne vous êtes occupé de rien, le toréador allant jusqu’à contacter les parties-prenantes pour leur confirmer la livraison du correctif. Le voici déjà qui repart sauver un autre projet. Qu’il est beau, qu’il est doué, qu’il est fort, le Toréador !

Les semaines passent.

Nouvel imprévu sur le projet. La problématique concerne très exactement le domaine sur lequel est intervenu le Toréador. Les retours de l’équipe sont mauvais. Personne ne comprend comment fonctionne le code car rien de ce qui a été ajouté n’a été documenté et les couches d’abstraction utilisées ne font pas partie des patterns maitrisés par l’équipe. Des processus avaient été mis en place sur la Production mais ils ne semblent pas avoir été utilisés. Résultat, l’équipe ne sait plus comment revenir en arrière ou intervenir à nouveau. Le Toréador est injoignable ou trop occupé par un autre projet pour revenir.

L’équipe discute, cherche, émet des hypothèses, teste, analyse les résultats, tente de trouver la meilleure solution et finalement, forte de plusieurs heures de luttes, parvient à remettre le projet sur les rails. Chemin faisant, ils comprennent le code du Toréador mais ne parvienne pas à légitimer sa complexité. Avec leur connaissance de l’application et du besoin du client, ils envisagent une solution plus simple. Malheureusement, les parties-prenantes s’y opposent : trop de temps a été dépensé sur ce besoin, il faut passer à la suite.

Un problème de perception

Le Toréador n’est pas si mythique que ça. J’ai eu l’occasion d’en rencontrer plusieurs dans ma vie professionnelle et il est même probable que j’ai été ou que je sois encore un jour cette personne pour d’autres. C’est comme la mort ou la stupidité : vous ne vous rendez compte de rien, ce sont les autres qui souffrent.

Le « problème du Toréador » n’est pas tant une question d’expertise qu’une question d’équilibre et de partage de la connaissance entre une équipe opérationnelle et un intervenant externe. Quand vous intervenez sur un projet, prenez toujours le temps de comprendre comment il fonctionne ou est architecturé, et prenez le temps de discuter avec l’équipe pour déterminer une solution qui corresponde à leurs processus.

Si vous arrivez et que vous livrez une solution sans formation ; si vous développez avant d’avoir demandé ou compris les grandes lignes du projet ; si vous ne niez pas quand un membre de l’équipe vous dit « le code se comprend tout seul » (faux) ; si vous ne laissez pas derrière vous des indications quelconques dans le code, dans une documentation, dans un mail… vous vous comportez en Toréador.

Si vous êtes responsable d’équipe et que vous cherchez à accélérer le temps de résolution d’un besoin par une équipe en ajoutant un collaborateur externe, prenez le temps d’expliquer vos attentes en termes de maintenance et responsabiliser le profil intervenant. Si vous cherchez à vous détacher du projet à ce moment critique ; si vous n’exigez pas de l’intervenant et de l’équipe un compte-rendu commun (ensemble, même) de l’intervention ; si vous ne prenez pas le temps d’écouter le retour de l’équipe sur cette intervention… vous attirerez à vous ce genre de situation.

Inutile d’avoir recours à un toréador quand on peut garder les vaches ensemble.

Un gitignore pour les gouverner tous

TL;DR

Ne mettez pas de règles dans le .gitignore du projet qui ne concerne pas le projet mais uniquement votre environnement ou machine.

Comment ça marche ?

Chaque projet sur lequel vous intervenez hérite de trois niveau de configuration :

  • La configuration de votre machine : git config --system --edit
  • Votre configuration utilisateur : git config --global --edit
  • La configuration du projet : git config --edit

Ces configurations s’appliquent en cascade (comme les feuilles de style) : Machine puis Utilisateur puis Projet.

Votre système d’exploitation produit parfois des fichiers indésirables (.Thumbs sous Windows, .DS_Store sous OSX et j’en passe). Il est donc pertinent que l’une de ces configurations pointe vers un listing des fichiers à ignorer pour l’ensemble de vos projets : un .gitignore qui vous correspond rien qu’à vous et permet d’ignorer tous les fichiers ou dossiers produits par votre mode de fonctionnement (IDE, outil de virtualisation… que sais-je encore).

Comment faire ?

  1. Créer ce .gitignore global. Par exemple, sous Mac, ça donnerait au moins ça. Perso, je stocke ça dans ~/.gitignore et considère que ça fait partie de mon profil utilisateur (même si ça se discute, mais c’est surtout pour être capable de retrouver facilement le fichier et qu’il soit sauvegardé en même temps que le reste du dossier par Time Machine)
  2. Ajouter le lien vers ce .gitignore global dans votre configuration :
    git config --global core.excludesfile ~/.gitignore
    

Et voilà. Vous n’aurez plus jamais besoin d’ajouter dans le .gitignore de vos projets des lignes pour ignorer ces fichiers indésirables. Notez que tout cela vaut aussi pour vos environnements de développement (ignorer les dossiers .idea si vous utilisez PHPStorm, par exemple). Pour info, il y a plein d’exemples de fichiers gitignore à cette adresse : https://github.com/github/gitignore

Backlog : analyse multi-dimensionnelle pour faciliter la valorisation des User Stories
Valorisation vs. Priorisation

Dans la constitution d’un Backlog, un Product Owner débutant et isolé peut vite être perdu et tenté de mesurer la valeur métier par une échelle de priorité. Une bonne façon de faire cela est de mettre une valeur arbitraire sur une User Story, disons 100, et d’évaluer la priorité des autres User Story en conséquence. Pourtant, valeur métier et priorités peuvent être liées, mais pas nécessairement. Si ce premier exercice de priorisation est un début, il doit normalement être complété d’ateliers permettant de mieux prioriser à l’aide des parties-prenantes. On pourra citer l’exemple de l’atelier Buy a Feature qui permet aux parties prenantes d’exprimer leur besoin en posant des billets de Monopoly sur une carte représentation des User Stories_.

Difficile de faire les deux ? Utiliser l’évaluation multi-dimensionnelle

Si ce genre d’atelier n’est pas organisable (certains clients considérant qu’il est difficile de lier ludisme, sérieux et concentration — ce qui est curieux mais pas à l’ordre de cette publication), il existe une autre façon de reprendre ces valorisation : l’approche multi-dimensionnelle.

L’idée est de se forcer à évaluer non pas une valeur, mais plusieurs.

Imaginons par exemple qu’on se concentre sur deux dimensions uniquement : nombre d’utilisateurs concernés et urgence de réalisation (attention : ces deux dimensions ne sont valables que dans un contexte où on estime que tous les utilisateurs apportent la même valeur et que les urgences de démarrage sont estimables).

D’un côté, on évalue la valeur métier sur, disons 5 points. De l’autre côté, on évalue l’urgence de démarrage sur 5 également. Ensuite, on établit une formule pour retrouver une note sur 100 (par exemple — (Métier×3+Urgence×2)×4 — et on compare avec la note initiale pour, si c’est pertinent, mettre à jour la « valeur projet » de la User Story.

Cet exemple s’arrête à deux dimensions, mais on peut en imaginer une troisième (les compétences disponibles, par exemple), une quatrième (les intérêts et agendas des parties prenantes présentes — ou non — aux démonstrations).

Bref, plus on décompose le problème en petites questions à se poser à soi-même (ou à l’équipe), plus on simplifie. On transforme quelque chose de compliqué en quelque chose de complexe.

Exemple de matrice de notation pour le métier

5 points

  • Très important pour l’ensemble des utilisateurs
  • Impact important sur la perception de la marque
  • Critique pour les objectifs du projet

4 points

  • Important pour de nombreux utilisateurs
  • Impact significatif sur la perception de la marque
  • Critique pour le fonctionnement de services spécifiques

3 points

  • Important pour un nombre modéré de citoyens
  • Impact modéré sur la perception de la marque
  • Ne correspond pas à un service rendu

2 points

  • Important pour très peu d’utilisateurs
  • Dérangeant pour la perception

1 point

  • Si ce n’est pas présent, personne ne s’en rendra compte

Matrice d’urgence de démarrage

5 points

  • On anticipe une grosse charge
  • Il s’agit d’un pré-requis fonctionnel à de nombreuses fonctionnalités
  • Il faut le faire maintenant ou jamais (par exemple, une ressource clé s’en va)

4 points

  • La charge est potentiellement importante
  • Il s’agit d’un prérequis fonctionnel à quelques autres fonctionnalités
  • Les délais d’obtention d’informations peuvent être longs

3 points

  • La charge est modérée, mais glissante (il faut commencer pour lever des questions, mais les réponses pourront prendre du temps)
  • Il s’agit d’une dépendance pour au moins deux autres fonctionnalités

2 points

  • La charge associée est faible
  • La fonctionnalité en introduit une autre

1 point

  • Extrêmement rapide
  • Toutes les informations sont disponibles

Déplacer un dépôt git

Il arrive parfois qu’on veuille déplacer un dépôt avec toutes ses branches, ses tags et son historique, par exemple pour changer de service entre Github, Gitlab, Bitbucket…

Voici comment le faire en 6 étapes :

  1. Cloner le dépôt d’origine et entrer dans le dossier
  2. Relier toutes les branches distantes à des branches locales: git branch -r | while read remote; do git branch --track "${remote#origin/}" "$remote"; done
  3. Récupérer le contenu des branches distantes dans ces branches locales: git pull --all;
  4. Ajouter le nouveau dépôt : git remote add new_origin http://…new_origin.git
  5. Pousser les branches sur le nouveau dépôt git push --all new_origin; git push --tags;
  6. Faire du nouveau dépôt ton dépôt par défaut : git remote rm origin; git remote rename new_origin origin;

Le syndrôme du marteau

Dans une mission de conseil en choix de solutions, il y a toujours une des alternatives qui se retrouve là pour des raisons politiques évidentes, tant elle est loin du besoin. J’appelle ça le syndrôme du marteau.

Ça donne quelque chose comme ça :

— Nous voudrions que vous nous aidiez à choisir une voiture et nous comptons sur vous pour nous aider à sélectionner quelques modèles. Nous vous demanderons ensuite une critique détaillée de ces modèles face à nos besoins : il est très important pour nous que le véhicule soit solide, qu’il consomme peu et qu’il permette d’aller d’un point A à un point B.
— Très bien. Nous avons interrogé nos experts et nous vous proposons, au regard de votre expression de besoin : une Audi, une Mercedes et une BMW. Lançons-nous l’étude ?
— Bien sûr mais pouvez-vous également intégrer ce produit, s’il vous plait ?
— C’est-à-dire… ce n’est pas un véhicule. C’est un marteau.
— Ah ? Pourtant nous l’avons déjà acheté et le vendeur nous a assuré qu’il pouvait également faire voiture, dentiste et chaussure.
— Euh, probablement, mais là nous cherchons une solution spécialisée, non ?
— Oui mais ne soyons pas pessimiste. Il est là, alors ce serait idiot de ne rien en faire.
— Très bien, mais sachez d’avance qu’il sera probablement mal noté par l’étude.
— Je ne comprends pas, il correspond bien à nos critères.
— Pas vraiment, non.
— Est-il solide ?
— Oui, sûrement.
— Est-ce qu’il consomme de l’essence ?
— Euh, non, en effet, mais vous voyez bien qu’il ne permet pas d’aller d’un point A à un point B.
— Vous êtes donc prêts à mettre de côté une solution dont on voit bien, en cinq minutes, qu’elle correspond déjà à ⅔ de nos besoins ⁈

GIF: Rachel Mac Adams, en robe de soirée, regard triste, prononce en anglais la phrase : ‘I’m notre trying to hurt you’ — 'Je n’essaie pas de te faire du mal'

Ça me met dans cet état.

Mais en général, au final…

GIF: Zac Efron pleurant

Je finis quand même par être obligé d’intégrer le marteau à l’étude.

Qualité Web, deuxième édition

Quel que soit votre rôle dans la chaine de valeur du Web, je ne saurais que trop vous conseiller l’achat de cet ouvrage qui vaut largement son prix et vous permettra d’en découvrir les faces cachées.

Après deux années de travail, j’ai le plaisir de vous annoncer la parution de la deuxième édition du livre qualité Web aux éditions Eyrolles. Vous pouvez depuis ce matin le commander chez votre libraire. En quelques chiffres, cette deuxième édition augmentée comporte environ 500 pages, 130 illustrations, 226 bonnes pratiques, 11 chapitres, 11 check-lists complémentaires, 70 recommandations, 1 glossaire, 1 bibliographie et toujours pas de raton-laveur (ça ne rentrait pas).
« Qualité Web, deuxième édition », Élie Sloim

D’abord, pour l’explication de l’ensemble des bonnes pratiques qui nous aident, chaque jour, à rendre le web meilleur et dont la pérennité n’est plus à démontrer.

Ensuite, pour les checklists qui vous permettront d’identifier rapidement les règles à vérifier suivant le besoin (référencement, performance, accessibilité…) ou la phase projet (développement, intégration…).

Enfin, parce que si vous n’en commandez pas des zillions, ils se sentiront obligés de tuer un raton-laveur pour mettre dans la troisième édition.

Une mort triviale

D’un côté, il est possible que nous développions une superintelligence qui soit comme un dieu au creu de notre main, nous assurant un monde d’abondance et d’immortalité. Mais d’un autre côté, il est fort probable que nous créerons une superintelligence qui causera l’extinction de l’humanité d’une manière rapide et triviale.
« AI Revolution 101 », Pawel Sysiak, extrait traduit par mes soins

Pendant mes études, je n’ai jamais été intéressé par le domaine de l’intelligence artificielle. Alors que la puissance de calcul ne cesse d’augmenter, je pense qu’il est désormais possible que nous parvenions à produire une intelligence qui égale celle de l’être humain, voire, accidentellement, la surpasse, avant ma mort.

Il est nécessaire d’ouvrir le dialogue public sur cette possibilité.

La blockchain expliquée à un enfant de cinq ans

Le concept de blockchain est suffisement peu intuitif pour que des analogies soient nécessaires. Elles doivent être simples pour faire passer des messages clairs, porteurs des principes fondamentaux : la notion d’enregistrement, de consensus de validation, d’utilisation de la méfiance entre acteurs comme garantie de confiance (car il s’agit bien de ça).

Pour mieux faire comprendre le fonctionnement et le potentiel de la technologie blockchain le Collectif Bam et Blockchain France ont utilisé la métaphore d’un scénario qui parle à tous : la corvée de vaisselle.
« La blockchain expliquée à un enfant de cinq ans », collectif Blockchain France

Comme j’ai trouvé l’analogie simple, j’ai tenté de la racontrer à mon fils de… cinq ans justement.

— … Alors, tu as tout compris ? Tu penses qu’on pourra faire ça, un jour, à la maison ?
— Oui mais Papa, à la maison, c’est la machine-vaisselle qui fait la vaisselle !

Premier obstacle : pour mettre en place un nouveau système, ne pas oublier de tuer l’ancien.

— Oui mais le lave-vaisselle peut casser. Imaginons qu’on en ait pas, on pourrait faire comme ça, non ?
— Ah, non. C’est Papa et Maman qui fait bien la vaisselle, pas moi et (prénom de son frère). Rhô, Papa, c’est mieux si c’est vous qui le fait !
— Bon admettons que Maman et moi, on vous oblige à la faire. Vous préféreriez le tube ou Papa qui vous dit quoi faire ?
— Papa et Maman. On le connait pas, le tube. Et si (prénom de son frère), il fait pas la vaisselle, c’est Papa qui va pas être content.

Deuxième frein : il est plus intuitif de faire confiance à un système centralisé et imparfait1 plutôt qu’aux acteurs. Avoir une figure centrale reste rassurant et permet d’envisager que la résolution d’un conflit n’aura pas à passer par un consensus mais par une décision rapide d’un acteur unique.

Mais si tu nous oblige, on la fera pas la vaisselle. On la fera pas jusqu’à ce que Papa et Maman la fait ou achète des assiettes nouvelles !

On n’est pas sortis de l’auberge. Finalement, même à cinq ans, les avantages ne sont pas évidents à appréhender…

  1. Je ne parle que de moi, ma femme étant, bien sûr, parfaite, comme chacun sait. ↩

Récupérer une Pull Request (GitHub) ou une Merge Request (Gitlab) en local

Votre collègue a fait une PR ou une MR et vous ne comprenez pas pourquoi elle ne passe pas le build ? Vous pouvez la récupérer en local pour l’exécuter.

Configurer

Pour cela, ouvrez votre .git/config (.git étant un répertoire caché à la racine de votre dépôt local), puis ajoutez sur le dépôt distant (remote) concerné :

  • Pour Gitlab :
fetch = +refs/merge-requests/*/head:refs/remotes/upstream/merge-requests/*
  • Pour Github :
fetch = +refs/pull/*/head:refs/remotes/origin/pr/*

En contexte, ça donne ça :

[remote "upstream"]
    url = git@gitlab.com:user/repo.git
    fetch = +refs/heads/*:refs/remotes/upstream/*
    fetch = +refs/merge-requests/*/head:refs/remotes/upstream/merge-requests/*

Sauvegardez, fermez.

Récupérer

Il vous suffit d’exécuter git fetch [remote] (en remplaçant [remote] par le dépôt distant que vous visez). Voilà, à vous les requests !

$ git fetch upstream
remote: Counting objects: 52, done.
remote: Compressing objects: 100% (45/45), done.
remote: Total 52 (delta 40), reused 10 (delta 7)
Unpacking objects: 100% (52/52), done.
From gitlab.com:user/repo
   224635d..c355b07  develop    -> upstream/develop
 * [new ref]         refs/merge-requests/1/head -> upstream/merge-requests/1
 * [new ref]         refs/merge-requests/10/head -> upstream/merge-requests/10
 * [new ref]         refs/merge-requests/11/head -> upstream/merge-requests/11
 * [new ref]         refs/merge-requests/12/head -> upstream/merge-requests/12
 * [new ref]         refs/merge-requests/13/head -> upstream/merge-requests/13
 * [new ref]         refs/merge-requests/14/head -> upstream/merge-requests/14
 * [new ref]         refs/merge-requests/15/head -> upstream/merge-requests/15
 * [new ref]         refs/merge-requests/16/head -> upstream/merge-requests/16
 * [new ref]         refs/merge-requests/2/head -> upstream/merge-requests/2
 * [new ref]         refs/merge-requests/3/head -> upstream/merge-requests/3
 * [new ref]         refs/merge-requests/4/head -> upstream/merge-requests/4
 * [new ref]         refs/merge-requests/5/head -> upstream/merge-requests/5
 * [new ref]         refs/merge-requests/6/head -> upstream/merge-requests/6
 * [new ref]         refs/merge-requests/7/head -> upstream/merge-requests/7
 * [new ref]         refs/merge-requests/8/head -> upstream/merge-requests/8
 * [new ref]         refs/merge-requests/9/head -> upstream/merge-requests/9

Conseils pour mes étudiants

Chers étudiants, ce billet vous est dédié. Nous venons de finir ensemble une nouvelle année de cours et de projets. Vous m’avez surpris, impressionné, déçu, énervé, enchanté, épaté, fait rire aussi parfois… mais surtout, vous m’avez rendu du code, présenté des documents, vous avez soutenu des présentations devant moi et je vous en remercie. Pour que tout cela soit encore meilleur l’année prochaine, je tenais à vous donner quelques conseils.

À propos de votre code

  • Évitez de rendre un code monolithique, entièrement écrit dans un nombre réduit de fichiers : un code compact est aussi difficile à lire qu’il est difficile à maintenir. Découpez, autant que possible, votre code en petits fichiers à l’objectif clair.
  • Quels que soient le langage ou la nature du projet, pensez à intégrer des fichiers README (.txt ou .md) dans certains dossiers pour expliquer les choses, à commencer par celui que vous placerez à la racine du projet. Expliquez-y pourquoi vous avez écrit ce code et comment l’utiliser (installation comprise).
  • Dans un questionnaire, faites toujours un tour des questions avant de démarrer. Ne perdez pas votre temps sur des questions difficiles avant de vous êtres assurés que des points « faciles » n’étaient plus à prendre.

Plus spécifiquement, concernant le RWD :

  • Si on passe 35h à vous dire que Bootstrap n’est pas utile quand le projet ne le nécessite pas et qu’on vous apprend trois techniques différentes pour faire mieux et sans, ne le sortez pas de votre manche à l’examen.
  • Le point de rupture n’est pas là pour embarquer un maximum de devices mais pour, au contraire, diviser la population et mieux adresser chaque partie. Un point de rupture mobile à 740px est clairement très large…

À l’écrit :

  • Travaillez le niveau de langue. N’utilisez pas « on », mais « nous ». « On a foiré le projet » , c’est moins joli que « Nous avons commis des erreurs ».
  • Attention à l’orthographe : vous avez des correcteurs sur tous les éditeurs de texte, servez-vous en.
  • L’orthographe ne fait pas tout : conjugaison, grammaire, style et… typographie (oui, les virgules ne sont pas en option ; pensez à la phrase « Venez manger, les enfants »).
  • Commencez toujours par expliquer ce dont l’utilisateur a besoin pour justifier ce que vous avez réalisé. Si vous avez du mal à basculer du besoin vers la réalisation, c’est que vous avez un problème de périmètre.
  • Faites un export PDF, n’envoyez jamais de document Word.

Équipe projet :

Vous allez faire des dizaines de projets où l’on vous demandera des fiches d’équipe. Prenez l’habitude d’en écrire, avec un design adapté. Ayez toujours de quoi faire votre petite fiche sous la main : une photo qui vous valorise et un descriptif de votre profil (savoir-faire, savoir-être, précédentes expériences).

N’hésitez pas à introduire une représentation visuelle de vos responsabilités :

  • par le biais de pictogrammes ;
  • en utilisant la matrice RACI.

Présentation

  • Si vous numérotez vos slides à la main, pensez à revoir ces numéros avant la soutenance…
  • Dans vos slides, évitez d’écrire des phrases complètes. Leur lecture distrait le public.
  • Pensez à changer de fond d’écran avant de brancher le projecteur. Vos préférences sexuelles n’ont pas vocation à se retrouver projetées en 4 × 3.

À l’oral

  • Répétez. Rien de plus énervant qu’un groupe qui se regarde dans le blanc des yeux en attendant qu’un d’entre eux se décide à dire quelque chose.
  • Corollaire du précédent point : dans les bonnes présentations, la parole se donne, elle ne se prend pas. Organisez-vous pour vous passer la parole.
  • Ne vous reprenez pas entre vous : remerciez-vous. Pas de « Je voudrais revenir sur ce qu’à dit Machin car il a tort ». Plutôt « Merci à Machin d’avoir introduit le sujet, je vais désormais y revenir en détails ».
  • Ne soyez pas trop directifs : « Nous vous remercions de garder vos questions pour la fin de la présentation » est maladroit. Préférez « Si cela ne vous dérange pas, nous répondrons à vos questions en fin de présentation. Si quelque chose vous perturbe, nous seront ravis d’y répondre. »
  • Attention au vocabulaire et au niveau de langue. À l’oral aussi, préférez « nous » à « on ». N’utilisez pas de termes connus pour dire autre chose (notamment, ne dites pas que vous avez fait preuve d’agilité si vous n’avez pas emprunté les méthodes agiles. Parlez plutôt de souplesse ou d’adaptabilité).

Un retour sur Opquast Certified®

Les référentiels Opquast et Clever Age, c’est une histoire d’amour qui dure depuis plusieurs années. Nombreux sont les consultants ayant collaboré à leur écriture et les discussions internes sont suffisamment nombreuses pour que tout le monde sache de quoi il s’agit.

Le mot &quot;opquast&quot; avec, en dessous, écrit &quot;certified&quot;. À gauche, un logo abstrait en nuances de vert.

Logo d’Opquast Certified®

En septembre 2015, Olivier annonçait sur le blog de Clever Age que chaque consultant pouvait, s’il le souhaitait, avoir un accès à la plate-forme d’entrainement Opquast Certified®. Le temps de m’organiser et j’ai répondu à son appel le mois dernier.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Retours à chaud

J’ai été surpris par la quantité d’information

Je connaissais déjà les référentiels de bonnes pratiques Opquast. Je les avais déjà utilisés pour des missions d’audit et j’avais même participé à l’élaboration de bonnes pratiques pour le référentiel WebPerf. J’ai donc ouvert le livre « Qualité Web » en me disant que je connaissais déjà probablement ce qu’il y avait dedans. Je n’ai pas honte de dire aujourd’hui que j’avais tort.

En plus du libellé, on y trouve des explications sur l’origine de chaque bonne pratique, ses objectifs, des notes sur comment la valider et mêmes des anecdotes en situation. La lecture du livre est donc à la fois plus intéressante mais aussi moins rapide que ce que j’avais imaginé. Premier conseil, donc, si vous voulez passer la certification : aménagez-vous du temps pour lire à tête reposée et prendre des notes. Le support est dense et mérite votre attention.

La « plate-forme d’entrainement » est un vrai MOOC

Avec un nom comme ça, on pourrait penser qu’il ne s’agit que d’une série de petits questionnaire pour se faire la main. C’est une erreur. Certes, les petits questionnaires sont là mais il y a aussi de nombreux articles de fonds sur la Qualité, la gestion de projet, la perception des utilisateurs… qui permettent de prendre du recul sur les objectifs et de comprendre le contexte plus global dans lequel s’inscrit la Qualité web. C’est donc bien plus une plate-forme de formation qu’un simple entraînement au passage de la certification.

Je pensais pouvoir m’organiser des sessions d’une quinzaine de minutes mais en fait, mieux vaut se réserver de vraies sessions de plus d’une heure et s’imposer comme défi de passer la certification dans un temps limité pour être certain de ne pas faire « glisser » son planning de formation.

J’ai trouvé le cursus Opquast Certified® passionnant

J’avais trois craintes en démarrant la formation :

  1. qu’il soit très orienté vers les bonnes pratiques d’intégration HTML liées à l’accessibilité ;
  2. que les bonnes pratiques soient trop manichéennes, déconnectées de la réalité ;
  3. qu’il contienne, comme souvent dans les certifications, de nombreuses choses qui n’intéressent pas directement mon métier.

Au contraire, la formation ne force pas ses arguments, avançant tout en nuances. Elle aborde une grande variété de sujet sans jamais aller trop profondément dans les détails d’implémentation, ne lassant jamais le lecteur qui ne se sentirait pas concerné. Mieux, les supports insistent régulièrement sur le recul nécessaire à l’appréciation de la pertinence des pratiques. Bref, Opquast Certified® incite à réfléchir.

J’y ai reconnu, à plusieurs reprises, mon positionnement de chef de projet : avoir des connaissances transverses sur l’ensemble des métiers mais aussi sur l’intégralité des étapes du processus d’élaboration d’un site web pour y appliquer pragmatisme et méthode, au service d’un objectif qui est très rarement technique.

In fine

Je pense (j’espère) qu’aujourd’hui, la perception d’Opquast Certified® est très bonne chez les professionnels de l’intégration web. C’est, à mon sens, réducteur. Opquast Certified® est en réalité pertinente pour tout profil se souciant de l’expérience des utilisateurs, à tout niveau de la chaîne de production. Les prérequis techniques sont très faibles mais la certification est exigeante et l’examen, relativement difficile. Je pense donc qu’elle saura s’imposer naturellement comme un étalon de l’investissement web des entreprises du numérique. Nous avons tous à y gagner.

Un certificat Opquast composé de 5 étoiles, avec écrit &quote;Expert&quote;
Certificat Qualité web - niveau Expert

Trouver une alternance

En tant qu’intervenant dans une école post-BAC, je suis sollicité par de nombreux étudiants en recherche d’une alternance. Je vais essayer de centraliser ici les retours que je leur fais :

Soyez conscient qu’il ne s’agit pas d’un stage

Pour une entreprise, prendre un candidat en alternance ou en stage, ce n’est pas la même chose. L’alternance est un pari sur l’avenir, une promesse de formation continue, le symbole d’une envie, en amont, de travailler ensemble. Ayez donc l’amabilité d’envoyer vos courriers plusieurs mois à l’avance pour laisser aux entreprises à qui vous les destinez le temps de la réflexion.

Explicitez votre planning d’alternance

Pour gérer ses effectifs, une entreprise a besoin de connaitre la répartition entre les phases d’apprentissage théorique en établissement de formation et les phases d’apprentissage pratique en entreprise. En d’autres mots : accueillir un alternant deux jours par semaine ou deux mois tous les deux mois, c’est très différent. Prenez le temps d’expliciter cette contrainte dans vos candidatures.

Insistez sur votre projet

Votre alternance a pour but de participer à votre assimilation du savoir et du savoir-faire d’un métier. Explicitez ce métier, qui constitue votre projet. Rien ne vous engage, vous aurez le temps de changer plusieurs fois d’orientation durant la suite de votre formation mais faites l’effort d’offrir à votre future employeur une projection de qui vous voulez devenir, pour qu’il puisse savoir concrètement s’il a sa place dans votre formation ou si vous allez le lâcher en cours de route.

Listez vos (véritables) compétences et votre motivation

Explicitez vos réalisations concrètes, même en projet scolaire, plutôt que la liste des savoir théoriques sur lesquels on vous a formé (et que vous avez certainement oublié depuis). Si vous ne savez pas encore quelque chose mais souhaitez apprendre, n’hésitez pas à le signaler à votre futur employeur en disant qu’au besoin, vous vous rapprocherez de vos professeurs pour qu’ils vous aiguillent sur les meilleures ressources afin de connaître les grandes lignes du sujet une fois à l’entretien.

Confiance

Un de mes clients souhaite me parler de son projet, que nous avons réalisé. Il a besoin d’y apporter des évolutions et souhaite mon avis. J’essaie de répondre à la fois avec une présentation claire des limites du projet mais aussi la proposition détaillée d’une solution potentielle, ne cachant pas les coûts associés et explicitant les complexités, y compris fonctionnelles.

Après réflexion, mon client me contacte à nouveau et m’apporte des informations supplémentaires pour que nous réfléchissions à nouveau, ensemble, à la solution à apporter. Au regard de ces nouveaux éléments, il est évident que la complexité proposée n’est plus utile. Nous établissons donc ensemble une nouvelle procédure qui leur permet d’utiliser la solution existante pour répondre, au plus vite, au besoin exprimé et reporter ultérieurement les évolutions qui peuvent attendre.

Enfin, mon client me demande de lui offrir de la visibilité sur ces évolutions. Je réunis donc les infos pour établir un planning réaliste en fonction de la charge, mais aussi de la disponibilité des équipes et la cohérence du profil des développeurs avec le projet. Le planning n’est pas forcément ce que le client souhaite entendre, mais il ne fait intervenir que des personnes compétentes sur le projet.

« La confiance se gagne en gouttes et se perd en litres. »

Mes amis pensent que j’aime mon métier pour son côté technique. J’adore l’informatique et je passe mes soirées à coder, je ne m’en cache pas. Mais ce n’est pas ce qui me permet de gagner ma vie. Comme dans toutes les activités de service, ce qui me lie à mes clients, c’est la confiance.

C’est la capacité à répondre avec honnêteté, même quand la réponse ne plait pas à l’interlocuteur.
C’est la possibilité de se tromper, par méconnaissance de l’ensemble du besoin, et trouver ensemble une meilleure solution.
C’est aussi montrer l’ensemble de son jeu, savoir être vulnérable et croire avec optimisme que l’interlocuteur saura prendre cela pour une marque d’honnêteté, pas de faiblesse.

La candidature qui fait mouche

De biens bons conseils pour tous les étudiants qui peaufinent actuellement leurs CVs. Qui sait, peut-être pour venir nous voir chez Clever Age Bordeaux ?

Vous cherchez du travail dans le Web : vous venez de terminer votre CV, vous mitraillez les agences de votre secteur de votre lettre de motivation, confiants, motivés. Quand soudain, votre candidature arrive dans ma boite mail…
« La candidature qui fait mouche », Marie-Cécile Paccard

Vous n’avez pas besoin d’un site web

Vous n’avez pas besoin d’un site web.

Ça parait con dit comme ça, de ma part. Je mange grâce aux centaines de sites web qu’on a réalisé depuis des années.
« Vous n’avez pas besoin d’un site web. »

Non, ça n’est pas con et je pense même que c’est le meilleur conseil qu’on puisse donner à de nombreux apporteurs de projets. Un site web, seul, est rarement la solution à un problème ou la réponse à un besoin.

Pour beaucoup de marques ou d’institutionnels, il constitue souvent un canal d’émission (et pas de communication, qui implique qu’on puisse répondre et que toutes les voix soient entendues) chronophage et coûteux car il nécessite d’être alimenté, entretenu et maintenu.

Aborder la transformation numérique, ce n’est pas ça. L’enjeu est ailleurs.

Il vous faut comprendre les motivations de vos visiteurs (externes ou internes à votre entreprise) et y répondre. Le RWD n’a de sens que si vous êtes capable de l’adapter aux contextes d’utilisation. Créez une offre de services ou d’information qui correspond aux objectifs de visite. Non, aucun de vos client et aucun de vos salariés ne se connecte sur votre site de bon matin pour le seul plaisir de voir si quelque chose a changé.

Vous devez comprendre vos processus de publication pour les automatiser. Si vous avez besoin d’un site qui affiche votre catalogue de produits, ne demandez pas à un secrétaire de re-saisir ce qui est déjà dans l’ERP, branchez-le directement1 ou mieux encore, adoptez une solution référentielle qui sera alimentée directement par vos responsables produits et alimentera tous vos canaux (web, mais aussi papier, par exemple).

Communiquez intelligement sur les réseaux sociaux : ça ne sert à rien d’y être si vous ne savez pas quoi y dire, comment le dire, comment écouter et répondre aux retours. Si vous n’offrez pas un interlocuteur ayant du leadership, vos clients discuteront ailleurs, entre eux, sans vous inclure dans la conversation et vous aurez perdu à la fois la capacité de comprendre leurs problèmes mais aussi d’influencer leur perception en leur apportant de nouvelles informations ou une certaine proximité.

N’oubliez pas que vous vous adressez à des êtres humains : vous ferez rarement mieux que de les mettre en face d’autres êtres humains. Intégrez un dispositif relationel (on parle souvent de relation client mais encore une fois, parfois le client est interne), mesurez sa performance en qualifiant aux mieux les échanges et le suivi des problèmes identifiés… tout ça n’a rien à voir avec le Web ! Le Web n’est qu’un canal supplémentaire qui, automatisé, peut vous offrir un plus grand périmètre d’actions.

Ça ne veut pas dire que le web n’est plus un métier. Il y a encore tellement à faire pour en améliorer la qualité, l’accessibilité, la sécurité, la maintenabilité, la réversibilité, l’utilisabilité, la performance et l’interopérabilité qu’il est toujours nécessaire d’avoir recours à des professionnels2.

Cependant, dans certains cas, communiquer par mail avec ses clients et leur envoyer directement des PDFs, ça marche très bien aussi et ça peut permettre de valider un concept avant de partir sur un projet à 250 k€ financé à grand renfort de French Tech au seul titre qu’il est numérique.

Vous n’avez probablement pas besoin d’un site web si vous n’avez pas encore de vision stratégique.

  1. l’ERP, pas le secrétaire. Enfin, c’est vous qui voyez. ↩

  2. si vous voulez en parler, je suis par là. ↩

Clic, Tap, l’enfer des pointeurs

Le problème

Vous devez réaliser une interface RWD, capable de déclencher des méthodes JavaScript au clic comme au toucher. Traditionnellement, nous faisions un test de support pour savoir si le toucher était disponible. Si oui, nous nous abonnions aux événements tactiles : touchdown, touchstart… et sinon, aux événements de la souris (click).

Cette approche est valable sur les périphériques qui ne proposent que le clic (les ordinateurs de bureau, par exemple), ou que le tactile (comme les téléphones portables). Par contre, sur un périphérique qui proposerait les deux (comme un ordinateur portable à écran tactile), elle exclut du clic les utilisateurs (puisque le tactile est disponible, c’est lui qui prend le pas).

Sur d’autres matériels, un appui sur l’écran produit un click ET un touchend.

Note : comment tester ?

Sur Chrome : il est possible d’activer les évènements tactiles en utilisant les DevTools et, sur les versions récentes de Chrome, en activant un flag (allez sur chrome://flags/, cherchez « touch »).

Je n’ai pas essayé avec Firefox, IE et Edge.

Solution

Le W3C a normalisé une nouvelle famille d’événement : les événements de pointeurs (Pointer Events). Il s’agit non plus de se demander si nous sommes en présence d’un clic ou d’un toucher mais de dire que les deux sont des événements de pointeurs. Plutôt que de s’abonner à ces événements, nous allons donc nous abonner aux événements de pointeurs, et le navigateur se débrouille pour gérer l’hétérogénéité des pointeurs en question (souris, toucher, pointeur laser… on peut imager plein de choses).

Du coup, plutôt que de faire ça (qui n’est pas idéal puisque certains ordis produiront deux fois « Coucou » quand on appuie sur l’écran, si vous avez suivi) :

$('selector').on('click touchend',function(){
   alert('Coucou');
})

On fera :

$('selector').on('pointerdown',function(){
   alert('Coucou');
})

Évidemment, comme d’habitude, il faut faire attention à la compatibilité navigateur qui, au moment où j’écris ces lignes, est assez balbutiante : http://caniuse.com/#feat=pointer

Mais heureusement, il existe un polyfill maintenu par la fondation jQuery : https://github.com/jquery/PEP, qui fera ce qu’on lui demande dès IE10.

Comme un seul homme

Somewhere in the internet there’s a guy named Doug Wilson (@blipsofadoug). And for the past 3 years, he’s the one who’s been taking care of Express for the rest of us.

During the last 3 years, Doug probably solved a bug that would have affected your production application. During this time he most likely improved your server’s runtime performance without you even realizing it.

So I would like to say thank you to Doug Wilson. For all of your hard work.
« The Unbelievable History of the Express JavaScript Framework », Dor Tzur

Derrière la plupart des outils de notre quotidien, il y a des hommes et des femmes qui contribuent discrètement à leur succès et qui donnent de leur temps sur des projets dont vous n’entendrez jamais parler ou sur d’autres que vous utilisez tous les jours1. Ils ne sont pas toujours isolés, font parfois partie de structures qui ont de forts intérêts dans ces projets2.

Ce n’est pas la première fois que j’entends l’histoire d’un projet open source supporté par une unique personne. Peu importe la taille du projet ou sa notoriété3, le service rendu par un projet open source est souvent perçu comme gratuit à produire parce qu’il est gratuit à l’usage.

Cette confusion injuste mais naturelle, qu’on retrouve également dans les déboires actuels de la Presse en ligne gratuite, n’est possible que parce que le Business Model du Libre est ailleurs. Mais un peu de gratitude ne fait pas de mal.

Merci.

  1. Firefox, Wikipédia… ne sont pas des acquis et peuvent disparaître un jour. ↩

  2. dire que j’écrivais déjà ça il y a 9 ans, les mythes ont la vie dure. ↩

  3. Bower, un des projets front end les plus utilisés au monde, est également maintenu par une seule personne, Adam Stankiewicz). ↩

Un blog avec Jekyll et Codeship

Depuis plusieurs mois, ce blog est propulsé par Jekyll et Codeship. Une page explicative existe, mais elle est « vivante » et si je change quelque chose demain, elle évoluera. J’utilise donc un article daté pour figer un peu les choses, et tant pis pour le contenu dupliqué.

Un tube à essai rempli d'une potion pétillante rouge écarlate

Sous le capot

Consultant en Web Performance depuis quelques années, j’ai décidé un jour de ne pas être le cordonnier mal chaussé. Depuis, dans une saine compétition avec mon collègue Nicolas Hoizey, je n’ai de cesse d’en améliorer les temps de réponse.

Côté serveur

J’ai commencé par jeter mon blog Wordpress pour le remplacer par un générateur de site statique en node, Hexo. Après avoir déterminé les limites de l’outil et contribué à quelques plugins, j’ai décidé de migrer vers Jekyll, plus rapide, plus abouti et dont la communauté Ruby me semblait plus mûre.

Mes dépendances Ruby sont gérées par Bundler :

  • pour la gestion des ressources statiques (hors images) : jekyll-assets ;
  • pour la gestion des archives : jekyll-archives ;
  • pour la génération d’images responsive : jekyll-responsive_image ;
  • pour le sitemap.xml : jekyll-sitemap.

L’internationalisation est permise par i18n et le i18n_filter1.

Jekyll ayant tendance à produire du code HTML très « aéré » et aucun moteur de rendu Markdown ne m’ayant convaincu quant à sa capacité à traité certaines spécificités typographiques françaises, j’ai mis en place un script « maison » de remplacement et de compression, libre adaptation de ce tutoriel de Sylvain Durand. De plus, Jekyll ne semble pas proposer de syntaxe simple pour la navigation précédent/suivant au sein d’une même catégorie, j’utilise donc ce plugin d’Adams Clarkson.

En local, j’utilise parfois node, et plus particulièrement gulp et browsersync, pour que mon navigateur se mette seul à jour au fil de mes sauvegardes2.

Compilation et déploiement

Mon code est architecturé en deux dépôts. Un dépôt contient les articles du blog au format Markdown, une syntaxe légère idéale pour rédiger3. J’utilise les hooks de GitHub pour interfacer ce dépôt à Codeship (une solution d’intégration continue) qui se charge d’exécuter des tests avec rspec pour vérifier que le contenu des en-têtes Front-Matter sont valides en YAML. Si c’est le cas, alors Codeship publie les articles sur un dépôt public. Puis clone le dépôt Jekyll et met à jour la référence du submodule git4.

Ce dépôt, mis à jour, lance également une opération sur Codeship : récupération de la dernière version des articles, du code et des dépendances, compilation de tout cela en un site Web et tests via html-proofer.

Si cette étape d’intégration est valide et que le code est bien contribué sur la branche master, alors Codeship s’occupe du déploiement du site statique ainsi généré chez mon hébergeur, alwaysdata. Le dernier déploiement a été réalisé le 2026-11-17 18:50:30 +0100.

Si tout se passe bien, alors le site se retrouve en Production.

Côté Client

Le chargement des polices privilégie la vitesse en affichant une première version avant qu’elles soient disponibles puis une seconde version une fois les polices chargées, sans clignotement au remplacement5.

Une partie de mon code CSS et JS est dédiée à l’accessibilité et j’essaie également de contribuer de manière responsable, pour être le plus inclusif possible à la fois envers les personnes, mais aussi envers les contextes (par exemple, j’utilise la librairie abbr-touch pour permettre aux personnes en situation de mobilité de visualiser la définition d’une abréviation ou d’un acronyme.

La recherche instantanée est le fruit du branchement du site sur Algolia, une solution très performante d’indexation et de recherche côté client qui a le mérite de proposer un exemple d’implémentation pour Jekyll qui cadrait parfaitement avec mon besoin. Il faudra néanmoins que je repasse dessus car le code JavaScript nécessaire me semble un peu complexe (jQuery, Hogan, MomentJs… je dois pouvoir faire plus simple).

J’ai ajouté au site InstantClick, une librairie JavaScript qui augmente considérablement la vitesse perçue en préchargement les pages internes au survol des liens, donnant l’impression à l’utilisateur que l’ensemble du site est préchargé, comme dans une application web single page.

Afin de contrôler ce qui se passe sur mon site (notamment pour détecter des tentatives d’injections), j’ai positionné un certain nombre de règles Content Security Policy et des rapports sont enregistrés dans une base de données à chaque infraction6.

Parce que je suis curieux, j’ai installé Google Analytics. Je suis conscient que certains d’entre vous veulent un peu d’intimité. Je vous encourage, dans ce cas, à faire comme moi : bloquer l’ensemble des domaines auxquels vous ne souhaitez pas faire confiance, au sein de votre navigateur ou ailleurs sur votre machine. Ça passe par la manipulation de votre fichier hosts et il y a des scripts pour automatiser tout ça7. Enfin, contrairement aux ads blockers, c’est transparent en performance.

  1. La technique de localisation est détaillée dans le guide de démarrage Jekyll de Thomas Brelet. ↩

  2. voir l’article de Vladimir Iakovlev. ↩

  3. Lire à ce propos cet excellent article de Romy sur les syntaxes légères ↩

  4. Ne ratez pas cette présentation complète des submodules git par Christophe Porteneuve ↩

  5. Les articles du Filament Group sur le chargement des polices sont de très bonnes références si le sujet vous intéresse. ↩

  6. Merci à Nicolas Hoffman de m’avoir sensibilisé à cette problématique durant sa présentation à Paris Web 2015. ↩

  7. J’utilise pour ma part les scripts de blocage de domaines de Steven Black. ↩

Amp Bookmarklet

Les premières pages AMP apparaissent dans les résultats de recherche Google.

Même si je suis très réservé sur ce nouveau format, très bien expliqué par mon collègue Olivier sur le blog de Clever Age, je suis bien obligé de reconnaître que naviguer en AMP est plus rapide et plus agréable que de supporter les templates classiques des sites de Presse. Alors pourquoi ne pas en profiter ?

J’ai créé un petit bookmarklet sur à glisser dans vos favoris : Amp Bookmarklet.

Si le code vous intéresse, c’est par là.

BetterBack : pour une meilleure posture

Suite aux conseils de mon cousin, je me suis procuré un BetterBack. Expérience d’achat très positive, attente un peu longue (2 mois environ) mais finalement un produit bien fini et agréable au toucher.

Au début, je me suis demandé comment ça se mettait mais en réalité, il suffit d’une seule utilisation pour « piger le truc » 1. Plusieurs collègues me l’ont emprunté pour essayer et ont confirmé la facilité d’utilisation2.

Je me sers du BetterBack comme d’un outil de rééducation : par sessions de 10 à 15 minutes toutes les 3 ou 4 heures. Je m’installe à mon poste, « enfile » les anses et me concentre sur ma tâche en cours. Les premiers temps, au bout de 5 minutes, je sentais mon dos chauffer, mais ce n’est plus le cas. Les premiers jours, j’ai également eu des courbatures à des endroits étranges. Je pensais être un peu timbré jusqu’à ce que mes collègues me confirment les mêmes symptômes.

Au fil des utilisations, j’ai commencé à me corriger. Au début, j’avais un déclic une fois par jour, et corrigeais ma posture. Maintenant, c’est plus régulier et il arrive parfois que je me surprenne à être bien assis, même sans le BetterBack. Je n’ai plus du sensation de chaleur, ni de courbatures : la posture avec le BetterBack me semble naturelle.

Pour ceux qui habitent Bordeaux et veulent essayer, je suis souvent disponible pour un café. C’est encore le meilleur moyen de savoir si ça vous plait et, pourquoi pas, l’acheter à deux ou trois pour le partager au bureau.

  1. Il y a plein de choses comme ça dans la vie, moins compliquées qu’elles en ont l’air. Donc les enfants, sortez couverts. ↩

  2. Bon, là, clairement, il faut arrêter la blague, ça devient sale. ↩

Une Faker API ?

Je me sers depuis des années de Faker, de Francois Zaninotto, actuellement en version 1.5. Cette librairie PHP m’a fait gagner un temps monstre et je profite de cet article pour chaleureusement remercier François (on ne remercie jamais assez nos héros de l’open source).

Un jour, quand j’aurais le temps (jamais, donc, probablement), je prendrai le temps de faire un composant embarquant Faker dans une API locale. Un lancement en ligne de commande et paf ! Faker serait disponible via l’URL http://localhost:10101. Ça serait tellement pratique !

Si certains d’entre-vous se sentent de tenter l’expérience (ça peut être un chouette défi pour tenter d’utiliser Docker, par exemple), je serais ravi d’avoir vos retours !

Nous

Bref, on est fréquent, et semble remplacer nous dans la plupart des cas de figure. Nous est-il en train de tomber en désuétude, entraînant dans sa chute les terminaisons de la première personne du pluriel ? Doit-on s’en inquiéter ou devons-nous nous en inquiéter ?
« le pronom « nous » est-il entré en zone omineuse ? », Langue Sauce Piquante, le Blog des correcteurs du Monde.fr

Derrière la disparition du « nous », il y a aussi la disparition d’une certaine responsabilité. On est indéfini, ce qui est bien pratique. On a fait une erreur est moins stigmatisant que nous nous sommes trompés.

Une collaboration saine impose une prise de responsabilité de chacun et du collectif. Nous prenons des décisions, nous rencontrons le succès ou les échecs, nous travaillons dans la collaboration, ensemble.

Le choix des mots est important.

Slack pour discuter ?

Cette expérimentation n’étant pas un franc succès (très peu de prises de contact par ce medium), j’ai décidé de fermer le Slack décrit ci-après.

Je tente depuis quelques jours une intégration de Slack au blog. Vous pouvez trouver en bas de chaque publication une invitation à m’y rejoindre (j’ai utilisé Slackin de Guillermo Rauch pour générer en quelques clics un formulaire d’invitation sur Heroku).

En réalité, je ne voulais pas forcément de Slack, mais je ne trouve plus d’intérêts aux commentaires. Les commentaires ne génèrent pas, chez moi en tout cas, de véritables discussions. Je leur préfère beaucoup les réactions à chaud sur Twitter ou sur Facebook (les publics et les échanges n’y sont pas les mêmes et c’est très intéressant).

Lorsque la conversation a besoin d’être poursuivie, j’aime qu’elle le soit avec des gens sérieux qui prennent le temps de la réflexion. J’apprécie par exemple énormément citer d’autres blogueurs et que eux, à leur tour, me citent plusieurs semaines plus tard dans leurs propres écrits. Une sorte de débat qui prendrait le temps d’être posé… Cela pose néanmoins la question de la notification. Parfois, je rate des choses.

Au final, je crois que la solution que je préférerais est la liste de diffusion. À la fois inclusive et nécessitant en même temps une certaine réflexion, elle permet des liens vers des contenus publiés sur le Web tout en créant une certaine intimité de l’échange. Slack avait juste l’avantage d’être plus rapide à implémenter après avoir découvert que LibreList était dans les choux.

Peut-être que Framasoft viendra bientôt à ma rescousse avec Framalistes ?

Zone B

Je déjeune en regardant autour de moi dans la salle de restauration du client chez qui j’interviens aujourd’hui. Tiens ! quelqu’un lit à ma droite. La couverture noire attire mon œil, Je suis curieux. J’essaie de voir le titre…

Mais ! Attends ! C’est mon nom, là, en petit !

Je le reconnais, même de loin, c’est mon nom !

Même en tout petit, j’en reconnais la graphie. On dirait juste qu’il est composé… pourquoi ?

Je me rapproche… Ah ben oui, c’est normal.

Couverture

"Zone B" par Marie HERMANSON, traduit du suédois par : Johanna CHATELLARD-SCHAPIRA

Bien joué, cousine !

Chez les développeurs, les femmes gagnent 14 % de moins que les hommes, que faire ?

Que pensez-vous du plan d’action suivant :

  1. les embaucher
  2. les payer
  3. les garder

Ça semble simple ! Trop simple ? Et pourtant « c’est tout ». Je m’explique.
Sylvain Abélard dans un commentaire sur un forum Human Coders

Je vous encourage à lire l’ensemble du commentaire qui montre bien à quel point l’environnement de travail et la culture française du développement (très influencée par la culture américaine) peuvent être hostiles à la présence de femmes.

J’ajoute qu’en dehors de mieux embaucher, de mieux payer et de mieux se comporter avec les femmes, nous pouvons aussi changer nos propres comportements pour réduire cette surface de discrimination.

Par exemple, dans ma vie professionnelle, j’ai souvent été qualifié de femme parce que je :

  • nettoie derrière moi et n’aime pas retrouver les choses sales ;
  • chérie l’organisation, quitte à la prendre en main ;
  • soûle souvent mes collègues avec des règles de vie commune ;
  • rate un certain nombre d’événements internes — pour ne pas dire tous — pour passer du temps avec mes enfants.

Je vais vous dire une choses : non seulement ça ne me choque pas d’être qualifié de « femme » (ça me change de maman), mais je me dis qu’en plus, être un homme qui se comporte « comme une femme » laissera peut-être plus de place, un jour, à une femme qui se comporte « comme un homme » :

  • qui prend des décisions (et pas : « qui se prend pour le chef ») ;
  • qui sait ce qu’elle veut (et pas : « qui fait chier tout le monde ») ;
  • qui sait s’entourer des meilleurs pour faire avancer un projet (et pas : « qui fait les yeux doux pour réussir ») ;
  • qui peut s’énerver quand c’est nécessaire, et aussi, parfois, juste parce qu’elle passe une journée de merde (et pas : « ah ben voilà, elle a ses règles ») ;
  • et qui a des centres d’intérêts en dehors du boulot (et pas : « qui n’est pas pleinement investie »).

Je suis sûr qu’il y a plein de femmes talentueuses dans nos métiers. Je travaille ou ai déjà travaillé avec plusieurs d’entre elles, et je serais ravi d’en rencontrer davantage.

Mes résolutions
pour 2016

2015 n’était pas une année très agréable pour énormément de raisons. Pour que 2016 soit différente, j’ai décidé de m’imposer quelques objectifs que je considère atteignables. Qui sait, dans douze mois, peut-être aurais-je quelques victoires à annoncer !

Dégager plus de temps en dehors du travail

J’ai besoin de mes fils dans ma vie, et eux ont besoin de moi. J’ai aussi besoin de plus de temps pour des expérimentations techniques qui ne sont pas directement liées à mes responsabilités chez Clever Age. Pour tout cela, il me faut du temps. Je ne sais pas encore à quoi cela ressemblera : est-ce qu’il s’agira de négocier une modification de mon contrat de travail pour avoir plus de temps libre ou d’utiliser davantage mes congés au fil de l’eau plutôt qu’en semaines entières. Il se peut aussi que cela implique l’arrêt d’une autre activité qui me tient à cœur mais qui est chronophage : les cours Ingésup. En 2016, il s’agira de trancher.

Formaliser mes processus

2015 a été une année où j’ai conjugué de nouvelles responsabilités sans forcément parvenir à une organisation qui me convient. J’ai trop souvent affirmé pouvoir m’en sortir sans en être convaincu moi-même, faute d’un formalisme suffisant à me donner la visibilité nécessaire. Comme j’ai le sens des responsabilités, j’ai tenu mes promesses mais souvent au détriment d’autres moments, plus personnels. Me rendant compte de la situation, j’ai commencé à regarder autour de moi comment évoluer et j’ai trouvé des sources d’inspirations dans des démarches plus formalisées, plus tranchées. Ça me ressemble moins mais je pense qu’à terme, cela sera bénéfique à l’ensemble des mes projets personnels comme professionnels. 2016 sera l’année où je sortirai de ma zone de confort sur ce sujet.

Mieux gérer mon énergie

Une révision de mon organisation doit aussi passer par une meilleure analyse de mes flux d’énergie et de ma productivité de manière à placer les bonnes tâches au bon moment. Le mercredi est par exemple la journée où j’ai la plus grande amplitude de travail, mais le créneau 14h-16h y est souvent difficile. A l’inverse, le jeudi est à la fois ma journée de travail la plus courte mais, paradoxalement, c’est aussi la plus productive (peut-être parce que j’y télétravaille). En 2016, je voudrais mieux planifier mon travail pour prendre en compte ces différentes phases de productivité et y planifier des activités adaptées.

Me tenir droit, mieux manger

J’ai toujours eu des problèmes de dos qui sont liés à la fois à un problème de posture et à une belle bedaine. Entre 2014 et 2015, mes habitudes alimentaires ont changé. La fréquentation d’une amie végétarienne m’a rendu curieux et, sans pour autant renoncer à quoi que ce soit, j’ai découvert des façons de m’alimenter qui me conviennent mieux. Fin 2015, j’ai réalisé un examen de santé complet qui a révélé un poil trop de cholestérol. Rien d’inquiétant, mais une piqûre de rappel : cette transition vers une alimentation plus saine doit continuer et s’accompagner d’une correction de ma posture. J’ai fini 2015 équipé de deux nouveaux gadgets pour me motiver (un BetterBack pour mon dos et une montre Withings Activité Steel pour l’activité) : en 2016, je dois me tenir droit et manger plus sain.

Promouvoir l’égalité

Je me rends compte, d’année en année, que nous avons une société profondément inégalitaire. Toutes proportions gardées (d’autres vivent plus mal que nous), j’assiste souvent impuissant aux difficultés des femmes, des homosexuels, des noirs, des musulmans et des handicapés (liste non-exhaustive, malheureusement). En 2016, j’ai décidé de trouver au moins une action concrète pour promouvoir l’égalité. En espérant que j’ai plus de chance que lorsque j’ai voulu promouvoir le numérique auprès des jeunes… Le chantier est d’autant plus crucial que l’année commence très, très mal.

Humain ?

S’il est un auteur qui n’a cessé, dans son œuvre, de questionner l’intelligence artificielle, c’est bien Asimov. Chacun de ces romans est une réflexion autour des lois fondamentales qu’il faudrait suivre pour éviter que la robotique ne nuise à l’homme. Formulées par Asimov, ces lois sont les suivantes :

  • Loi zéro : un robot ne peut nuire à l’humanité ni, restant passif, permettre que l’humanité souffre d’un mal.
  • Première loi : un robot ne peut porter atteinte à un être humain, ni, en restant passif, permettre qu’un être humain soit exposé au danger*, sauf si de tels ordres entrent en conflit avec la loi zéro* ;
  • Deuxième loi : un robot doit obéir aux ordres qui lui sont donnés par un être humain, sauf si de tels ordres entrent en conflit avec la première loi ;
  • Troisième loi : un robot doit protéger son existence tant que cette protection n’entre pas en conflit avec la première ou la deuxième loi.

Asimov a épuisé de nombreuses critiques autour de ces trois lois, depuis les robots empoisonneurs malgré eux aux robots meurtriers solariens… mais dans mon souvenir, une question n’est jamais soulevée : celle de la définition d’un être humain.

Et si nous programmions un jour un robot qui ne suivrait tout simplement pas ces lois, faute d’une reconnaissance efficace de l’humanité parce que d’un point de vue matériel, il en était incapable ? Et si le problème venait du logiciel ? Pas par malveillance, juste par incompétence ?

Un test, c’est quoi ?

Tout le monde parle de test et au final, les gens ne se comprennent pas toujours. Précisons un peu tout ça pour parler la même langue.

Types de classification

Classification technique

Il s’agit ici de distinguer les tests qui ont une connaissance de vos algorithmes de ceux qui n’en ont pas. Très souvent, cela consiste à classifier vos tests suivant qu’ils sont eux-même composés de plusieurs étapes internes à votre code de ceux qui sont au plus haut niveau. Par exemple, si je manipule un objet de type Pizza chez Domino et que je veux vérifier qu’une commande engendre bien une livraison, je peux :

  • soit tester Commande(Pizza) et constater si la pizza est livrée (test en boîte en carton noire) ;
  • soit lancer successivement les étapes de prise de commande, préparation, cuisson et livraison parce que je sais à l’avance que c’est à ça que correspond une commande (test en boite blanche).

Classification par qualité

Je vous renvoie au listing officiel de la norme NF ISO/CEI 9126 e AFNOR. Je ne peux pas mieux l’écrire.

Classification par phase

  • Tests unitaires : tests qui touchent de toutes petites unités ou composants du logiciel
  • Tests d’intégration : les petits composants fonctionnent bien les uns avec les autres
  • Tests du système (ou tests d’intégration fonctionnels) : tests consistant à vérifier que l’ensemble fonctionne correctement
  • Tests d’acceptance (souvent appelés Recette) : vérifie que le le logiciel respecte des critères précis (critères d’acceptance) définis à l’avance par le client

Autres classifications

Quand vous n’avez pas assez de celles d’au-dessus :

Classification par contexte d’exécution

Avec l’émergence des applications JavaScript, une partie des tests se fait souvent client-side, quant l’autre partie se fait server-side.

Classification par modalités d’exécution

  • Tests de simulation : des tests qui visent à reproduire le modèle abstrait de l’interaction. Par exemple, si je veux tester un clic sur un bouton, je teste la méthode qui est lancée lors du clic en question.
  • Tests d’émulation : des tests qui produisent concrètement l’action à la place d’un utilisateur.
  • Tests manuels : des tests, manuels (merci Captain Obvious).

Exemples ?

| Technique | Caractéristique | Niveau | Exemple de tests | | — | — | — | — | — | | Boîte blanche | Technique | Unitaire | Vérifier que la fonction réserverVoiture(voiture) change bien le statut de l’objet voiture de « DISPONIBLE » à « RESERVEE ». | | Boîte noire | Technique | Unitaire | Lorsqu’une voiture est disponible, la fonction verifierDisponibilité(voiture) renvoie vrai. | | Boîte blanche | Performance | Unitaire | Vérifier que la fonction réserverVoiture(voiture) s’exécute bien en moins de 120 ms. | | Boîte blanche | Technique | Intégration | Si on essaie de réserver une voiture, les fonctions peutLouerUneVoiture(personne) et estDisponible(voiture) sont appelées. | | Boîte noire | Fonctionnel | Intégration | Si on essaie de louer une voiture déjà réservée, la fonction réserverVoiture(voiture) retourne une erreur. | | | Boîte noire | Performance | Unitaire | L’appel de la fonction récupererUneVoiture met moins de 200 ms à s’exécuter lorsque l’on a plus de 100 000 voitures. | | Boîte noire | Performance | Système | L’affichage de la liste sur le site prend moins de 200 ms lorsque l’on a plus de 100 000 voitures. | | Boîte noire | Fonctionnel | Acceptance | Si on essaye de louer une voiture disponible, on obtient un message de succès. | | Boîte noire | Rendement | Acceptance | Le système continue-t-il à répondre en moins de 2 s à des requêtes de réservations si on en envoie 20 000 par heure ? par minute ? par seconde ? |

Et on ne parle même pas ici des tests d’acceptance de non-régression visuels (avec Wraith, par exemple)…

Bref : la prochaine fois qu’on vous parle de faire des tests ou que vous parlez de faire des tests, soyez précis !

Publicité en ligne : un point sur la situation
Une guerre aux multiples facettes

La publicité en ligne est devenue, faute d’une meilleure solution, la principale source de revenus de nombreux producteurs de contenus.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Sans contexte de régulation, son usage empiète un peu plus chaque jour sur les contours flous de la vie privée, au dépend d’usagers qui manifestent leur sentiment d’agression par l’usage massif de bloqueurs publicitaires1. Un véritable marché du blocage publicitaire émerge, constitué de solutions techniques et d’accords secrets, dans les navigateurs comme sur smartphones2. Face à ce phénomène, certains producteurs n’hésitent plus à bloquer l’accès à leurs contenus aux utilisateurs refusant la publicité, envoyant ainsi un signal extrêmement négatif à leur audience.

Cette guerre, extrêmement coûteuse, est le résultat d’un pari sur des sources de revenus alternatives (basées sur la publicité) plutôt que sur la mise en avant de la réelle plus-value des contenus. De nombreux acteurs se plient ainsi aux attentes du « tout gratuit », multipliant les productions à faible valeur informative en maximisant le gain publicitaire au moyen de véritables appâts à clics sans ligne éditoriale. Des empires se construisent, allant jusqu’à racheter des sites pour y déployer des chevaux de Troie publicitaires, au détriment des lecteurs historiques qui sont rarement dupes.

Ces pratiques quantitatives déprécient les contenus et leur valorisation publicitaire. Des producteurs qui garantissaient avant leur rentabilité à l’aide de quelques publicités, se retrouvent aujourd’hui avec un couteau sous la gorge, et sont contraints d’avoir recours à des manipulations techniques (visant à contrecarrer les bloqueurs) ou éditoriales (introduisant au milieu de leurs contenus intéressants du native advertising et du publi-éditorial) pour continuer à assurer les entrées d’argent.

Pour tout dire, la solution est devenue si inacceptable que même l’industrie de la publicité en ligne, représentée par l’IAB3, le confirme :

We messed up. As technologists, tasked with delivering content and services to users, we lost track of the user experience.
Scott Cunningham dans Getting LEAN with Digital Ad UX

Des alternatives difficiles

La construction d’offres de contenus payantes est ambitieuse et nombreuses sont les initiatives qui ne parviennent pas à la rentabilité car c’est toute l’éducation des internautes, prêts à consommer mais rarement à payer, qui est à refaire.

Cependant, si le message parvient à passer, des solutions existent pour permettre à l’internaute volontaire de financer la production de contenus en passant par une donation (Flattr, Google Contributor). Leur usage à grande échelle n’est cependant pas envisageable tant le nombre de régies différentes à rémunérer est important. Autre piste, envisagée par La Presse Libre : la réunion de plusieurs producteurs en une seule plate-forme (avec financement par donation ou abonnement) puis redistribution du financement, par exemple au prorata des visites. Un tel système est également difficile à mettre en place car il nécessite des métriques communes, un S.I. cohérent et énormément de confiance.

A l’opposée de cette logique d’union, certains montrent des voix alternatives en construisant des offres dont la valeur est plus facilement lisible par l’utilisateur : indépendance éditoriale (Mediapart), expérience de lecture renforcée (application native LaPresse.ca), information condensée et sélectionnée… Tous ont en commun de souligner ce qui a été oublié, à savoir que l’investigation, l’écriture et l’accès à l’information a un coût, sur Internet comme ailleurs, et n’offrent que très rarement (souvent à titre promotionnel) l’accès à leurs productions.

Le soulèvement des audiences

Si les producteurs n’arrivent pas à valoriser leurs contenus faute d’une audience suffisante, pourquoi ceux qui disposent d’une audience mais n’arrivent pas à lui proposer des contenus ne viendraient pas proposer leurs services ? Ainsi émergent de nouvelles solutions permettant aux éditeurs d’intégrer leurs contenus sur une plate-forme valorisée par son audience mais en contrepartie, le producteur devient dépendant d’un nouveau canal. Cette relation créé de nouveaux équilibres :

  • le contenu est visuellement dépouillé, ce qui améliore la lisibilité mais réduit l’identité de marque et la fidélisation ;
  • l’audience est potentiellement très large mais l’éditeur n’a que très peu d’impact sur son ciblage et sur sa capacité à atteindre ses cibles (on est ici sur la même problématique de place de marché qu’avec Google Adwords) ;
  • la monétisation est simplifiée mais en échange, l’éditeur n’a, en général, pas de contrôle sur les contrats publicitaires.

Facebook (Instant Articles) et Apple (News) sont les premiers à se lancer sur ce type d’offres, suivis de près par Twitter (Moments) et Snapshat (Discover) mais rien ne laisse à penser que l’absence de transparence sur les plate-formes concernées permettra aux producteurs de contenu de maîtriser leur cible. Facebook, par exemple, ne met déjà plus en avant les actualités de vos amis. Comment lui faire confiance pour vos articles ?

Google AMP : changeons la boite, gardons le contenu

À contre-courant de ces précédents acteurs, le positionnement est différent. Il faut dire que le moteur de recherche est avant tout spécialisé dans l’indexation, il n’est donc pas anormal de le voir proposer Accelerated Mobile Page (AMP), une sous-spécification de HTML destinée à empaqueter à la fois des contenus dépouillés, mais aussi de la publicité (via Google) et le suivi analytique (idem) qui y seraient liés. Google propose ainsi un nouveau format au marché pour voir si celui-ci le considérera comme le « standard » enfin capable de résoudre l’équation { lisibilité × monétisation × contrôle }.

Évidemment, l’intérêt pour Google est de toujours centraliser davantage l’information en affichant les résultats directement plutôt que de rediriger le lecteur vers le site du producteur. Autre avantage : en ayant une approche rationnelle de la publicité, Google est à même de dialoguer avec les principaux Ad Blocker pour faire avancer le concept des publicités acceptables.

Techniquement, l’approche n’est pas coûteuse. La plupart des CMS sont capables de générer des flux de syndication. Celui-ci ne serait qu’un flux supplémentaire incluant le tracking et les campagnes de publicité. Wordpress est déjà en lien avec Google sur le sujet.

D’un point de vue métier, en revanche, l’approche a de quoi faire peur aux professionnels qui se retrouveraient dépossédés du contrôle qu’ils ont aujourd’hui sur les régies. Pas étonnant, dans ce contexte, qu’ils se réunissent rapidement autour d’une position de mea culpa* et préfèrent trouver des accords à l’amiable, fondés sur des bonnes pratiques.

Des pistes non-explorées, un enseignement pour l’avenir

Alors quel avenir pour la monétisation des contenus ? Bien malin qui saura le déterminer. Ce qui est sûr, c’est que le potentiel de nuisance des bloqueurs met l’industrie dans une impasse, obligeant à une refonte des modèles économiques vers des pratiques plus respectueuses des lecteurs, comme L.E.A.N.4.

De nombreuses alternatives au modèle publicitaire sont en réflexion, considérant par exemple que l’attention du lecteur doit être entièrement dédiée à évaluer la qualité de ce qu’il consulte, mais que pendant ce temps sa machine ne fait rien. Il est donc possible de remplacer le temps d’attention humain par de la puissance machine, utilisée par exemple pour générer au profit du producteur des crypto-monnaies. Mais pour l’instant, difficile de trouver le contexte de sécurité suffisant et les modalités de déploiement à grande échelle.

Reste une morale à ne pas oublier : la publicité est une problématique créée de toute pièce par le refus de considérer que les contenus ont un coût. Nous arrivons aux limites du système, et nous arriverons aussi un jour aux limites des autres systèmes pseudo-gratuits, comme les réseaux sociaux.

Si vous le pouvez, préférez toujours des business model basés sur la plus-value de vos contenus plutôt que sur leur proposition à bas coût, ou sans frais : vous envoyez un mauvais signal et il est dur d’en sortir a posteriori.


Aller plus loin, en savoir plus

Quelques liens proposés par des lecteurs :

  1. D’après une étude PageFair, ces AdBlockers seraient installés chez 35 % des internautes européens, 41 % des 16-29 ans. UCBrowser et Maxthon, qui revendiquent plus de 600 millions d’utilisateurs en Asie, sont également partenaires de solutions de blocage. ↩

  2. L’Ad Blocker d’iOS 9, par exemple, repose sur un modèle commercial où les annonceurs devront payer pour voir leurs pubs affichées. ↩

  3. L’Internet Advertising Bureau, la principale association de professionnels de la publicité en ligne regroupant de nombreux acteurs de l’écosystème publicitaire : agences, régies, partenaires, hébergeurs. Habituellement, l’IAB promeut massivement la publicité en ligne en finançant des études sur son efficacité. Ce constat d’échec est un séisme. ↩

  4. L.E.A.N., pour « Light, Encrypted, Ad choice supported, Non-invasive ads », que l’on peut traduire par « des publicités légères, sécurisées, respectueuse des choix de l’utilisateur et non-invasives », est une nouvelle bonne pratique mise en avant par l’IAB. ↩

De nouveaux défis pour l’intégration web

Fin juillet 2015, une franche polémique a enflammé la communauté des professionnels du Web suite à cet article publié sur Quirksmode. En synthèse, l’auteur y expliquait que les standards du Web s’étendent à une vitesse incroyable, à la recherche de leviers pour rattraper ou concurrencer l’expérience native mobile, mais que cette course aux fonctionnalités épuise les développeurs qui n’ont plus le temps de penser à l’expérience utilisateur.

Note : cet article a d’abord été publié sur le blog de Clever Age.

En conséquence de quoi, ppk1 proposait un moratorium d’un an, une limitation sur les nouvelles fonctionnalités des navigateurs, à commencer par Chrome (le leader de cette course à l’innovation, d’après lui), le temps que les développeurs rattrapent le coche. C’est une direction vers laquelle le marché n’ira probablement pas, les dernières digues retenant l’innovation étant en train de sauter.

En effet, Microsoft abandonnera, dans un peu plus de trois mois, les supports de Internet Explorer 8, 9 et 10, mettant en avant IE11 et Microsoft Edge (MSE), deux navigateurs d’excellente facture dont la compatibilité et les outils pour développeurs sont à la hauteur des attentes actuelles du marché2. Edge entre même dans la course puisque de nouvelles fonctionnalités y sont régulièrement ajoutées, à l’image des politiques d’innovation de Chrome et Firefox.

Au marché de jauger désormais la capacité des acteurs du Web à mettre en place les processus et structures leur permettant d’assimiler cette innovation débridée de manière rationnelle. Vu le périmètre que recouvre l’intégration web aujourd’hui, la perspective de continuer a disposer de développeurs omnipotents disparait. À la place, la constitution de véritables équipes d’intégration composées de spécialistes dans des domaines bien distincts (Accessibilité, APIs, Animations et transitions…), coordonnés autour d’un projet commun d’expérience utilisateur et de qualité, deviendra la norme. C’est un tournant passionnant.

  1. Peter-Paul KOCH (connu également sous le pseudonyme ppk) est un chercheur, auteur, consultant en stratégie web et développement web mobile. Quirksmode est un des plus anciens blogs parlant d’intégration HTML connu notamment pour avoir populariser le concept de tables de compatibilité entre navigateurs, que beaucoup connaissent aujourd’hui au travers de (caniuse.com](http://caniuse.com/). ↩

  2. Pour comparer les différentes versions des navigateurs de Microsoft, n’hésitez pas à recourir au très pertinent canisuse.com. ↩

Expert ou pas ?

En entreprise, une compétence est rarement absolue, elle s’évalue souvent en fonction d’un savoir-faire, d’un savoir-être ou d’un savoir-communiquer qui ne peut se mesurer que par rapport à d’autres. Du novice à l’expert, il faut gérer les différents niveaux d’intuition pour constituer les meilleures équipes, celle qui permettent à chacun de s’épanouir dans le niveau de compétence ciblé (qui n’est pas nécessairement le plus haut en terme d’expertise).

Plusieurs classifications existent pour qualifier des compétences. Je vais vous parler aujourd’hui du modèle d’acquisition de compétences de Dreyfus.

Les profils

Le novice

Il a peur ou aucune expérience. Son objectif premier : obtenir des résultats rapidement. Pour cela, il va attendre qu’on lui expose clairement les contraintes et les règles absolues permettant de les dépasser pour réaliser des tâches simples. Les succès lui permettent de prendre rapidement confiance en lui mais il est facilement perturbé par tout ce qui sort du cas nominal.

Le débutant avancé

Il continue à se focaliser sur des tâches mais commence à prendre du recul sur le contexte, en extrapolant à partir d’exemples. Cela lui permet aussi de prendre du recul sur ses compétences et de commencer à affirmer ce qu’il sait faire, et d’envisager ce qui lui reste à apprendre. Son exécution dépend encore beaucoup de règles et de consignes. En cas d’échec, il imputera facilement ses erreurs sur ces dernières.

Le compétent

En classant et triant ses expériences, le débutant créé des perspectives. Quand il commence à choisir de lui-même la bonne perspective, il devient compétent, prend le contrôle de la situation, prend des initiatives (émancipation par une vision instinctive de la solution). Cette phase nécessite de surmonter ses peurs, ce qui a également pour effet de faire entrer la gestion de ses émotions dans le processus décisionnel.

L’efficace

Il repose de plus en plus sur l’intuition pour reconnaitre les situations, ne se fiant pas ou peu aux jeux de règles et de maximes qu’il connait. Il prend un cran de recul supplémentaire et commence à comprendre d’où viennent les règles. Enfin, il est capable d’enrichir son savoir par les retours d’expérience d’autres : il transforme sans y penser des informations sur l’acquisition du savoir-faire en information sur le savoir-être et a de plus en plus de mal à distinguer les deux.

L’expert

L’expert réagit entièrement de manière intuitive, prend directement la bonne décision. Il n’est plus conscient des mécanismes qui conduisent à sa décision, il agit par réflexes. Il est capable d’analyser ses actions, mais cela lui demande un effort : il est plus naturel pour lui d’agir que d’expliquer ou de faire attention à la façon dont il se comporte.


Équilibrer une équipe

Dans le modèle de Dreyfus, il n’y a pas de bonne ou de mauvaise position, mais plutôt une distribution inégale avec quelques novices, beaucoup de débutant avancés, peu de personnes efficaces et très peu d’experts. L’expertise est quasiment entièrement évaluée au regard de l’intuition de la personne, les débutants préférant l’exécution de règles. Mais cette intuition a un coût : la communication. Il est donc déconseillé de réunir directement des profils ayant plus d’un cran d’écart. Inutile par exemple de mettre ensemble des gens qui ont besoin de beaucoup de réponses (les novices) et des gens incapables d’en fournir (les experts).


D’autres modèles ?

Il existe de nombreux autres modèles mais j’aime bien celui-là car il démonte facilement ce qu’on appelle « expert » dans le monde du numérique. Très souvent, il s’agit d’une personne qui maitrise très bien son sujet mais est encore capable d’expliquer les choses, voire aime cela. Dans la matrice de Dreyfus, il s’agit donc plutôt de quelqu’un de compétent.

J’ai croisé peu d’experts dans ma vie professionnelle et je suis loin de me considérer comme l’un d’eux sur aucun sujet mais comme tout est relatif, je suis sûrement l’expert de quelqu’un (et le novice d’un autre).

J’essaie de toujours garder en tête que chaque compétence doit être évaluée individuellement et qu’on peut être compétent quelque part et un novice ailleurs. Pour ma part, le degré le plus haut ne me passionne pas : j’aime trop expliquer ce que je fais !

HTTP Archive : comprendre le présent en observant le passé

Comprendre le présent n’est jamais chose facile et nous n’avons souvent qu’une alternative : l’examen du passé. Sur un media en perpétuelle évolution comme le Web, cela peut s’avérer très difficile si on n’a pas anticiper la problématique en mettant en place un enregistrement méthodique de la manière dont les pages Web sont produites.

Note : cet article a d’abord été publié sur le blog de Clever Age.

C’est, de manière simplifiée, le rôle de HTTP Archive qui stocke de façon permanente des fiches d’informations contenant des indicateurs tels que la taille des pages, les demandes qui ont échoué, les technologies utilisées, les scores face à des référentiels de bonnes pratiques comme PageSpeed… etc.

Je recommande à quiconque d’ajouter son site à l’index de HTTP Archive. À court terme, le gain est faible à nul : les analyses sont réalisées à une fréquence très basse (tous les 15 jours), et dans des contextes très différents de ceux des utilisateurs des sites. HTTP Archive ne remplacera en aucun cas un audit détaillé ou une véritable solution de suivi des performances Web.

En revanche, lorsqu’on cherche à comprendre certaines évolutions longues (de l’ordre de l’année ou sur plusieurs années) en terme de dette technique, de référencement naturel ou d’expérience utilisateur, avoir accès à cet historique permet de dégager des tendances, de comprendre des choses que l’on n’aurait pas forcément imaginer en observant uniquement l’instantané du site concerné.

Inscrivez votre site maintenant pour que cela puisse servir plus tard.

De Windows à Mac

J’ai récemment migré mon environnement de travail de Windows à Mac OS X. De nombreux développeurs se sont empressés de me rappeler qu’un Mac est une machine autrement plus productive qu’un PC alors que les raisons de mon changement sont bien différentes.

Ok, comparons

Pour être productif, j’ai besoin d’être documenté et expérimenté sur le système que j’utilise. Windows et Mac sont bien documentés à la fois par leurs éditeurs mais aussi par leurs communautés d’utilisateurs. Je n’ai jamais rencontré de problème sous Windows et ma transition sous Mac se passe très bien pour les mêmes raisons.

Pour être productif, j’ai besoin d’outils. 95 % de mes usages sont liés à Chrome et à mes comptes Google (j’utiliserai volontiers Firefox mais il ne correspond pas à mes besoins) : il m’a fallu très peu de temps pour les récupérer sous Mac.

Les éditeurs que j’utilise sous Windows sont disponibles partout (Sublime Text ou Atom, PHPStorm), ma gestion de source repose sur git (pour lequel j’utilise sous Windows la ligne de commande de Desktop Github) et quelques scripts PowerShell me permettaient d’avoir à la fois un prompt qui déchire et un gestionnaire d’accès direct à vous faire oublier cd (Jump Location, un portage PowerShell du autojump de William Ting, installé également sur mon Mac). Donc je n’ai jamais eu l’impression de passer plus de temps à naviguer dans mes fenêtres que mes collègues.

Enfin, après avoir essayé Chocolatey et OneGet, j’ai découvert il y a quelques années node. En plus de me permettre de continuer à développer dans un langage du Web (JavaScript, bien sûr), node a l’avantage d’ête multi-plateforme. J’ai donc pu reprendre l’ensemble des outils de mon quotidien en quelques minutes. Et pour tout ce que node ne supporte pas, homebrew est venu à ma rescousse. Bref, sur le terrain de la gestion des dépendances, l’OS importe finalement peu.

L’interface du Mac est agréable et on sent bien la finition quand on observe certains petits détails mais paradoxalement, certaines choses sont compliquées à comprendre ou tout simplement impossibles (avoir des sens de défilement différents sur le trackpad et la souris, supprimer l’animation lors du passage en plein écran). La comparaison avec Windows, notamment la version 10 sortie récemment et déployée sur l’ordinateur de la maison, n’est pas vraiment à l’avantage du système de Tim Cook. Et je n’ai pas encore parlé de la calamiteuse gestion des fenêtres qui oblige à installer une application tierce (Spectacle pour moi) là où le système devrait être mieux pensé et permettre de docker les contenus à droite ou à gauche. Donc si je devais être vraiment critique avec les deux systèmes, je pense que Windows l’emporterait.

Alors, pourquoi avoir changé de machine ?

Pour une question de lecture/écriture disque, tout simplement. Mes processus de développements Symfony impliquent l’utilisation de vagrant, ce qui me permet d’homogénéiser l’environnement de développement dans mon équipe, tout en permettant à chacun de développer sur des fichiers locaux et l’IDE de son choix. Seulement voilà, comme déjà expliqué dans un précédent article : Windows n’est pas très performant dans ce cas d’utilisation, en raison de l’absence de support NFS.

J’ai bien contribué au plugin vagrant winnfsd, qui ajoute tant bien que mal le support NFS à vagrant mais quand on manipule des frameworks qui reposent sur de nombreux accès fichiers comme Symfony, le dixième de seconde de latence à l’accès peut rapidement se transformer en dix secondes d’écart sur le chargement d’une page.

L’âge de mon ancien PC rendait envisageable son renouvellement par une machine disposant de SSD et comme j’ai à ma portée des collègues sous Mac, je me suis dit que j’allais aligner ma configuration avec la leur pour réduire le champ d’adaptation des projets, par exemple le Vagrantfile. Mais je n’ai rien contre Windows, bien au contraire.

Moutons électriques

Deux articles m’ont récemment fait réfléchir, tous les deux traitants de problématiques liées à l’intelligence.

Une des réalisations les plus poussées et les plus spectaculaires du deep learning a eu lieu en 2012, quand Google Brain, le projet de deep learning de la firme américaine, a été capable de « découvrir », par lui-même, le concept de chat.

[…]

« Ce qui est remarquable, c’est que le système a découvert le concept de chat lui-même. Personne ne lui a jamais dit que c’était un chat. Ça a marqué un tournant dans le machine learning », a expliqué Andrew Ng, fondateur du projet Google Brain, dans les colonnes du magazine Forbes.
layout: postComment le ‘deep learning’ révolutionne l’intelligence artificielle », Morgane Tual pour Le Monde

Je trouve passionnante cette percée dans le monde de l’intelligence. Qu’il s’agisse de Deep Dream (plus globalement, du projet Google Brain) dont parle l’article ci-dessus, de Microsoft Adam ou de Facebook qui cherche à se servir de réseaux de neurones pour traiter plus efficacement les publications de ses abonnés. Les découvertes sont passionnantes même si planent au dessus de fortes inquiétudes : le soulèvement des machines, la prise de contrôle par une entité sur-rationelle, incapable d’émotions, étrangère à l’homme.

Marié, entouré d’amis, Elliot mène sa barque. Mais un jour, il se met à souffrir de migraines épouvantables qui révèlent un méningiome, une tumeur bénigne qui écrase ses lobes frontaux. Opéré en urgence, tout se passe bien.

Son inconséquence et sa désobligeance déconcertent son entourage. Il peut passer une journée à se demander selon quel critère classer ses dossiers, il peut errer d’un restaurant à l’autre sans consommer… et quand il finit par prendre une décision, c’est la mauvaise. En proie aux mauvaises fréquentations, renvoyé de son poste, quitté par sa femme et ses amis, Elliot échoue à l’Armée du Salut. Mais le plus étonnant est qu’il garde son Q.I. de 125 et ses facultés cognitives semblent intactes. La Sécurité Sociale le prend pour un imposteur.

C’est là qu’il tombe sur Antonio Damasio, le célèbre neurologue. L’ablation de sa tumeur a emporté une partie de ses lobes frontaux et Damasio constate son apathie : Elliot peut toujours apprendre, mais ne peut plus ressentir. Sur quoi Damasio formula sa théorie sur les émotions comme fondement de la rationalité. Point de bonnes décisions sans les sentiments… et Elliot obtient sa pension d’invalidité.
layout: postComment arrêter de gamberger la nuit, définitivement », Fiamma Luzzati

Dans le cerveau humain, pas de prise de décision sans émotion. La rationalité n’est donc qu’un leurre sémantique. Est-ce qu’un réseau de neurones sera un jour capable de décisions ? Certainement. Mais une machine ne peut pas ressentir : elle applique une série de mécanismes pré-inscrits qui supervisent son processus décisionnel. Elle se retrouve donc investie d’un pouvoir émotionnel qui n’est que le reflet du ressenti du programmeur l’ayant construite. Et c’est là qu’il faut que nous soyons vigileants.

Comme pour les boites noires de la Loi Renseignement, le problème ne réside pas dans la technologie. Il est dans l’humain faillible ou mal intentionné, tapi derrière.

Gérer ses dépendances avec Bower ?
Un besoin d’industrialisation

Le développement front-end se complexifie un peu plus chaque jour. D’une part, l’évolution des standards pousse à la spécialisation de nos métiers. D’autre part, la nécessité d’aller toujours plus vite tout en assurant une qualité importante et une facilité de maintenance impose de formaliser davantage certains processus, voire de les automatiser.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Plus précisément, avec l’arrivée depuis quelques années de librairies HTML/CSS/JS très ciblées dans leurs objectifs, il devient de plus en plus intéressant de construire son projet front comme on construisait avant son projet back : en architecturant sa solution à partir de dépendances et d’un processus de compilation permettant de produire la solution qui les utilisera au mieux.

Ce qu’offre Bower

Bower est un gestionnaire de dépendances pour librairies front-end, s’installant via node et npm. Il trouve sa configuration dans un fichier à la racine de votre projet, et sait de lui-même installer, dans un dossier bien défini, l’ensemble des librairies déclarées dans les versions nécessaires (du moins suivra-t-il une syntaxe de gestion sémantique des versions lui permettant de déterminer la meilleure version à installer pour chaque librairie).

Imaginons par exemple que vous ayez besoin de jQuery UI. Un simple :

bower install jquery-ui --save

vous permettra d’ajouter la dépendance à votre projet ainsi qu’à votre configuration Bower sous la forme d’un fichier .bowerrc, et il ne vous restera plus qu’à référencer le script dans votre page HTML. L’intérêt d’une solution de gestion des dépendances, c’est qu’elle ira jusqu’à récupérer, au sein de votre projet, les dépendances de jQuery UI lui-même. Plus la peine de déterminer la version de jQuery à utiliser, Bower lira la configuration de jQuery UI et installera la meilleure version.

Un problème de dépendances

Bower gère les dépendances à plat, il installera donc jQuery au même niveau que jQuery UI dans le répertoire de dépendances. Que se passera-t-il donc si on demande à Bower d’installer une autre librairie, ayant également jQuery comme dépendance, mais dans une autre version ? Bower ne saura pas répondre et aura besoin d’une confirmation humaine pour déterminer s’il doit conserver la version de jQuery déjà téléchargée ou la remplacer par l’autre version. Au développeur de prendre sa décision.

Ce comportement est souvent décrié par une partie de la communauté front, notamment celle proche de npm, le gestionnaire de paquet lié à node. Pourtant, le fonctionnement de Bower est tout à fait logique quand on comprend son objectif : être un gestionnaire de dépendances pour le front, tout le front.

Car autant il est désormais admis dans la communauté JavaScript qu’un développement peut s’organiser en contextes bien séparés (il y a quelques années, on écrivait des plugins jQuery aux responsabilités limitées, désormais on préférera travailler avec des modules CommonJS), autant le monde CSS est moins bien loti : impossible, pour l’instant((Avec l’émergence des Web Components, on devrait voir arriver ce genre de choses, mais cela ne sera probablement pas d’usage courant avant plusieurs années encore, si ça l’est un jour.)), de charger une feuille de style spécifique pour ne l’appliquer qu’à une portion de la page. Il est donc important de véritablement choisir la version d’une librairie CSS.

Une incitation au couplage

Un autre problème levé par cette démarche, c’est qu’elle impose une mécanique de pensée au développeur qui, par économie d’effort, cherchera à provoquer le moins de conflits possible entre les dépendances. Quoi de plus efficace pour cela que de réduire son nombre de dépendances ?

Sans forcément penser à mal, le développeur en viendra alors souvent à l’exact opposé de ce qui était voulu en installant des dépendances monolithiques et très (trop) riches en fonctionnalités (comme Bootstrap ou jQuery, que l’on retrouve quasiment systématiquement des les boilerplates basés sur Bower) de manière à couvrir le besoin fonctionnel avec le moins de dépendances possibles avec à la clé, une augmentation du couplage et de nombreuses difficultés lors des demandes d’évolutions ou d’optimisations.

Une forte dépendance aux dépôts des auteurs

Bower n’inclut pas un répertoire de dépendances mais un gestionnaire de références. Les projets dont vous allez avoir besoin continuent à être hébergés sur leurs dépôts respectifs. Si le dépôt n’est plus accessible ou si le projet déménage, alors votre dépendance risque d’être introuvable jusqu’à ce que son propriétaire l’enregistre à nouveau. Bower n’a aucun cache sur ces dépendances, donc les propriétaires peuvent également « réécrire l’histoire » de leur projet en supprimant des versions que vous utilisez ou en changeant le système de numérotation des versions((Ces pratiques, extrêmement déconseillées par l’ensemble des développeurs, arrivent malheureusement régulièrement.)).

Autre détail ayant son importance : Bower rapatrie sur le poste du développeur l’intégralité des fichiers du dépôts source, et pas uniquement les fichiers nécessaires (y compris les fichiers permettant à l’auteur de votre dépendance de la générer). Cette installation systématique de fichiers n’ayant pas d’intérêt pour votre projet peut être rapidement problématique en termes d’espace disque, certains auteurs n’hésitant pas à versionner leurs builds dans le dépot lui-même((Une autre pratique rare, mais que nous avons déjà rencontré.)).

Bower dans votre architecture projet ?

D’abord, Bower nécessite ses propres dépendances, dont node. L’information est triviale mais peut avoir du sens dans un contexte sensible ou dans des organisations de projets où il est difficile d’installer de nouveaux paquets sur un serveur.

Ensuite, Bower est loin d’être le seul gestionnaire de dépendances. npm, livré avec node, est un gestionnaire de dépendances de premier niveau qui mérite également d’être évalué au regard de vos impératifs. Il est même envisageable d’utiliser les deux.

On oublie également trop souvent que la gestion des dépendances se fait depuis très longtemps et n’a pas attendu l’émergence d’un besoin d’industrialisation du développement front. Vous avez peut-être déjà un gestionnaire de dépendances dans votre projet PHP, Ruby, C#, Java… pourquoi ne pas envisager de l’utiliser pour le front ? Par exemple, si vous utilisez Compass pour compiler votre code SASS, vous utilisez déjà RubyGems.

Faut-il utiliser Bower ?

Maintenant que vous en connaissez les limitations et si elles n’entrent pas en conflit avec la façon dont vous gérez vos projets : pourquoi pas ?

En revanche, si vous l’utilisez pour un projet que vous vous apprêtez à livrer entre les mains d’un tiers, soyez vigilant sur la bonne documentation du processus et de ses alternatives. Aucune démarche n’est finale, il est toujours possible de revenir en arrière ou de modifier… à condition de bien comprendre comment fonctionne l’existant.

Enfin, soyez conscient que les cas d’utilisation optimaux de Bower sont très limités. Vous avez peut-être une meilleure alternative.

Transition numérique

Aujourd’hui stratégie IT et stratégie d’affaire ne font plus qu’un. Fini l’alignement, on synchronise, et il subsiste un exercice de réflexion stratégique unique où la composante technologique fait partie intégrante de la stratégie d’affaire.

[…]

Tout le monde a du se réinventer, du PDG aux équipes de rédaction et bien sûr au sein des équipes informatiques.

[…]

Cette richesse interactive a permis de moduler les tarifs en tenant compte du niveau d’interactivité.

« La Chronique Canada no 1 » par Didier Navez sur le blog de veille de Clever Age

La Presse Quotidienne (éventuellement Régionale) est un formidable terrain d’expérimentation pour une transition numérique pleinement assumée : souffrant d’un modèle historique « papier » se détachant de plus en plus des usages de ses lecteurs, mise sous pression par des acteurs du Web comme Google et souffrant d’une dépendance très forte à la publicité, la Presse a désespéramment besoin de renouveler sa stratégie d’affaire et cela semble définitivement passer par le numérique.

Ce changement de paradigme est un vrai bouleversement pour les salariés qui peuvent y perdre leurs repères et pour certains, leurs emplois. On m’a ainsi parfois reproché que l’accompagnement que j’offre quotidiennement à mes clients était destructeur et si l’on ne regarde la réalité que par cet angle, c’est probablement vrai pour tout un ensemble de personnes qui ne voudront ou ne pourront pas s’adapter. Je n’ai jamais été témoin d’un tel problème mais je n’ai pas d’œillère : je sais que cela doit arriver et je suis content qu’avec la mise en place du CPF, on se donne les moyens de former tout au long de la vie.

Cependant, il est important de signaler que la Presse n’est qu’un exemple parmi d’autres et, finalement, un des plus chanceux. Peu d’entreprises peuvent bénéficier de subventions de l’État à cette échelle et sur cette durée, leur permettant de prendre le virage numérique avec autant de retard. Pour les autres, les conséquences se manifestent plus tristement par des pertes sèches amenant à des cessation d’activité ou des rachats amenant à des plans de restructuration. Le risque pour l’emploi est alors bien plus grand.

Le numérique, comme la révolution industrielle en son temps, offre des solutions permettant aux entreprises de rester concurrentielles en étant plus performantes tout en conservant leur gouvernance sur ce qui les constituent vraiment : la valeur qu’elles apportent à leurs clients. Le numérique n’est pas une menace mais une opportunité que tous les grands analystes économiques incitent à comprendre (rien n’est magique, le croire est dangereux) et à saisir. Faisons dès aujourd’hui les choses bien pour demain les faire mieux.

Promouvoir une culture numérique
il n’est jamais trop tard

Je suis profondémment convaincu que le numérique est une des clés de la croissance française et mondiale. Nous avons la chance d’avoir une infrastructure formidable, un bon niveau de formation et un taux d’équipement à la hauteur. Rien ne s’oppose donc, en théorie, à une transition numérique des entreprises et des pratiques.

Rien, sauf une culture du numérique globalement défaillante au sein de la population. Cela se traduit par une vision complètement paradoxale du numérique. D’un côté, j’ai l’impression d’une très grande immaturité des personnes et des organisations : divulgation d’informations personnelles sur les réseaux sociaux ; entreprises qui se jettent à corps perdu sur Facebook sans savoir ce qu’elles y font ; nouvelle bulle French Tech qui finance des start-ups aux propositions de valeur nulles. De l’autre coté du miroir se manifestent les craintes les plus fortes, soulevées soit par un profond obscurantisme, soit par une volonté de contrôle désormais illusoire : manipulations politiques, mise sous surveillance généralisée du Web, résistance à l’innovation économique quand elle est destructrice de rentes ou de monopoles.

J’ai le sentiment que mon devoir de citoyen, c’est de ne pas s’arrêter à ce constat. C’est une des raisons pour lesquelles je m’emploie chaque jour à aider mes clients à franchir le cap de la transition numérique mais ça ne suffit pas. Il faudrait aussi enrichir la culture des individus et c’est quelque chose de très difficile à faire sur le court terme. Alors je me suis dit que j’allais voir loin, en pensant d’abord aux plus jeunes.

Je me suis déjà prononcé sur l’apprentissage du code informatique, que je pense inutile pour le plus grand nombre (au mieux, il sera utilisé comme un signal, à l’image de ce qui se fait dans de nombreux établissements pour l’Allemand en première langue ou les langues mortes, ce qui n’est pas forcément très intéressant au regard de mon objectif).

J’ai donc décidé de réfléchir plutôt à une approche plus légère et ouverte à la transdisciplinarité. Je propose donc, depuis plusieurs mois, des activités à l’école de mes enfants et dans mon ancien lycée pour sensibiliser les étudiants à l’informatique et au numérique. Les approches sont différentes suivant les âges :

  • initiation à l’algorithmique chez les plus jeunes, par le biais de jeux et d’activités ;
  • sensibilisation aux risques et opportunités à partir de 13-14 ans.

Les sujets abordés dépendent, quant-à-eux, des cursus dans lesquels ces interventions peuvent s’inscrire (encore une fois, l’idée n’est pas de créer un nouvel enseignement, mais de donner une couleur numérique à l’existant). Ci-dessous, quelques exemples.


Education Civique

  • Informatique et libertés : un sujet qui aborde les notions de citoyenneté, vie en collectivité, égalité et justice abordés en 4e
  • Internet comme un medium : rappel du rôle des médias et de la protection assurée par leur pluralité. Notion de doute sur les informations trouvées et technique de recoupement.
  • Données personnelles : modélisation et traitement, ce qu’il est possible de savoir sur vous sans le savoir…
  • Harcèlement : en ligne aussi, vous en êtes peut-être victime… ou bourreau. Que faire ?
  • Démocratie : de la démocratie représentative à la démocratie participative

Philosophie

Suivant les séries et les sujets, de nombreux sujets abordables sur le Travail (hyper-connexion, accomplissement), l’Art, la Société et les échanges, Libertés et Devoir, la Morale, l’Identité…

Histoire-Géographie

  • La Démocratie sous toute ses formes
  • Révolution industrielle, révolution numérique : impacts sur l’évolution du marché de l’emploi et sur la (dé)centralisation

Technologie

  • Appareils mobiles, géolocalisation et techniques de ciblages
  • Modélisation des visiteurs d’un site et Teen Marketing
  • Fonctionnement des SPAM et des arnaques

Mathématiques et données

  • Calcul littéral, factorisation/développement : travail pratique (exemple avec Scratch)
  • Usage des statistiques dans un exemple de calcul dédié à la publicité en ligne

Français

L’e-mail est-il une nouvelle forme de communication épistolaire ou s’inscrit-il dans l’immédiateté d’une conversation ?


L’idée de ces interventions est d’offrir aux plus jeunes une culture numérique qui leur permette, non pas de devenir développeurs, mais plutôt de comprendre les enjeux de leurs choix quotidiens sur Internet. Les sujets abordés sont à la carte, et j’essaie d’investir les responsables d’établissement et les professeurs mais pour l’instant, j’ai assez peu de retour, même en proposant d’offrir gratuitement mes services.

J’espère que cela va changer bientôt (si vous voulez aider : dialoguez avec les professeurs ou chefs d’établissement des établissement que vos enfants fréquentent). Il est urgent qu’une majorité de la population saisisse les opportunités et les risques du numérique pour arrêter de prendre des décisions basées sur des perceptions magiques.

Si vous voyez d’autres sujet à aborder, n’hésitez pas à les suggérer. De mon côté, si je prépare des supports sur le sujet, je m’engage à les mettre à disposition bien sûr !

Maîtrise et expertise

Tous les enseignants ont vécu ce moment. Parfois, lors de la première répétition d’un cours mais plus souvent à la première question posée par un élève. Ce moment où l’enseignant se rend compte qu’il ne maîtrise pas complètement son sujet. Tous les gens qui ont enseigné m’ont fait le même témoignage :

Je ne maîtrisais pas réellement le sujet avant de devoir l’enseigner

Une erreur commune est de croire que la maîtrise d’un sujet implique sa productivité sur un projet le concernant. Ce sont en réalité deux choses profondément différentes. L’une fait appel à la raison, l’autre à l’intuition, et cela fait toute la différence entre un chef de projet et un expert en développement.

Le premier est dans une posture pédagogique : il doit pouvoir expliquer à tout moment la situation du projet par rapport aux délais, aux coûts et à la couverture fonctionnelle et technique en s’adaptant au vocabulaire de ses interlocuteurs car son objectif est la compréhension par l’ensemble des acteurs des problématiques qui les concernent. Le second doit avoir une vision intuitive de la meilleure solution, construite autour de son expérience personnelle mais aussi des récits des expériences des autres qu’il a assimilé au travers de sa veille et de ses expérimentations. Son objectif est de consolider la production pendant et après le projet pour en assurer la pertinence en terme d’architecture.

C’est pourquoi je suis toujours très dubitatif quand ces deux rôles projet sont portés par la même personne.

Gestion des marque-pages : quel outil ?

Depuis la revente de delicious par Yahoo! et son quasi-abandon par AVOS, j’avais migré ma veille sur Diigo mais suite à la récente décision de Diigo d’abandonner les listes (qui permettaient pourtant un partage plus sélectif), je suis à la recherche d’une nouvelle solution de gestion des marque-pages.

Je n’ai pas d’a priori sur la solution, qu’elle soit gratuite ou payante, collaborative ou non, en SASS ou auto-hébergée (il sera toujours temps de partager par ailleurs, via une tâche IFTTT).

Fonctionnalités recherchées :

  • possibilité de sauvegarder un marque-page avec titre, description et mots-clés, y compris constitués de plusieurs mots ;
  • possibilité d’importer des marque-pages en masse (éventuellement via un service tiers ou une API, je devrais pouvoir me débrouiller) ;
  • possibilité de rattacher un marque-page à une liste plus précise : via un mot-clé (qui ne serait, du coup, pas répété dans la liste) ou via une requête plus élaborée ;
  • possibilité de consulter les marque-pages sous la forme d’un flux RSS suffisamment bien formé pour pouvoir en extraire les mots-clés de manière efficace.

J’ouvre à peine la réflexion, donc pour l’instant j’ai envisagé :

  • Pocket, bien qu’étant un très bon outil de cueillette, n’est pas adapté à la classification et au partage ;
  • Evernote et Diigo sont plus proches d’espace de travail que de solution de gestion de marque-pages ;
  • Pinboard, parce que Nicolas en parle sur son blog;
  • Wallabag me semble être une solution auto-hébergée – mais plutôt dans la veine de Pocket – à creuser ;
  • shaarli, un clone auto-hébergé de delicious qui a l’avantage de pouvoir fonctionner sans javascript côté client et sans base de données côté serveur

Si vous avez d’autres propositions, je suis fortement preneur !

Et pourquoi pas Youtube ?

Quand on parle de vidéo publique en ligne, la plupart des gens pensent immédiatement à Youtube comme OVP, en raison de son incroyable popularité.

Pour les marques, Youtube est un canal de prédilection (à juste titre), pour la distribution de contenu vidéo : immédiatement signalées à Google, les vidéos Youtube ont l’assurance d’être rapidement référencées et de bénéficier d’une bonne exposition.

En revanche, certaines caractéristiques de Youtube peuvent poser problème :

  • la capacité de chaque vidéo à être reprise et embarquée n’importe où rapidement (partage par intégration). Bien que désactivable, cette option est active par défaut. Une vidéo récupérée par un site parodique ou un concurrent pourrait par exemple poser problème ;
  • la publicité : pour les marques qui ne souhaitent pas payer pour les chaînes sans publicité Youtube, les vidéos sont recouvertes de contenu publicitaire dont ils n’ont aucun contrôle. Pire encore : comme les publicités sont définies par mot-clés, il est fort probable qu’elles viendront de concurrents directs de la marque ;
  • le post-roll des « vidéos recommandées » (les vignettes qui apparaissent à la fin des vidéos) : comme avec les superpositions à base de texte, celles-ci sont sélectionnées sur la base de mots clés dans le titre, la description et les tags - ce qui peut à nouveau amener à la promotion de vidéos concurrentes ;
  • le player Youtube : avec peu ou pas d’options personnalisables, le playeur par défaut est reconnaissable de n’importe où et comportera notamment toujours le filigrane Youtube. Un positionnement qui manque de professionnalisme et ne correspondra pas au besoin de contrôle de l’image de beaucoup de marques ;
  • enfin, l’absence de contrôle sur le stockage peut être une source de problème pour les divisions juridiques, qui préféreront passer par des solutions locales, nationales ou européennes.

Parfois, c’est tout simplement la matrice fonctionnelle de Youtube qui n’est pas assez riche au niveau de la gestion des comptes et des droits, des limitations géographiques de consultation ou de la gestion des sous-titres (formats gérés, collaboration dans l’édition).

Enfin, si on ne parle pas de vidéo publique mais de vidéo située derrière un firewall ou destinée à une sphère plus réduite, alors Youtube n’est pour le moment pas la bonne solution et peut même présenter un sérieux danger en terme de diffusion incontrôlée d’informations. Sans compter qu’il ne dispose d’aucune fonctionnalité pour optimiser la diffusion sur les LAN, ce qui en fait une solution avant tout WAN.

Moments frustrants

Paris Web 2014 était un bel événement. Si vous n’avez pas encore lu le beau résumé que nous avons monté avec Marie et Vincent sur le sujet, n’hésitez pas (et je ne dis pas ça uniquement parce que j’ai passé 3 jours à réfléchir aux axes de l’article). Vous avez aussi le résumé plus personnel de Marie, seule cette fois, et plein d’autres sur le Lanyrd de Paris Web 2014.

Dans ce petit article supplémentaire et plus personnel, je voulais parler de deux conférences et d’un atelier qui m’ont laissé une impression mitigée. Très intéressantes sur le fond, elles ont été trop ambitieuses sur la forme.

Je me suis retrouvé un peu par hasard dans la conférence « Convivialité des interfaces des réseaux sociaux et spécificités culturelles » de Léonie Marin, qui sortait des sentiers battus. Léonie venait témoigner de son retour d’expérience après avoir observé l’utilisation des réseaux sociaux dans certains pays d’Afrique et en Nouvelle-Calédonie. Modification des relations familiales, transfert des sphères d’influence, ouverture de la parole selon des modes de communication qui sont profondément liés aux valeurs des peuples… J’ai tellement apprécié ce moment que j’ai fini par me sentir triste. De ne pas tout comprendre, d’abord, notamment dans la phase de questions/réponses, mais aussi que ça termine comme cela. J’en aurais voulu moins ou davantage, mais j’ai trouvé que ce qui était présenté ouvrait trop de portes pour un complet néophyte.

Ensuite, c’est la conférence de David Rousset qui m’a laissé sur ma faim. Car le pauvre, durant « Introduction à TypeScript et retour d’expérience sur le portage de BabylonJS », s’est retrouvé privé de connexion Internet et même son PC s’est mis à faire des siennes (la panne de ZoomIt!, un classique). Résultat : une présentation où l’assistance n’a probablement pas compris à quel point le typage peut améliorer la productivité et la relecture, n’a pas probablement pas saisi le gain que peut apporter le compilateur ou les opportunités en termes de gestion des callbacks. Sans parler du futur gain de await/async pour la gestions des promesses… En espérant que les curieux de ce jour-là auront la patience de donner une seconde chance à la solution en allant sur typescriptlang.org.

Enfin, mon troisième point de frustration vient des copains de chez Clever Age (ou presque) Nicolas Hoizey et Matthias Dugué qui ont animé leur atelier « Finnissons-en avec le mythe du RWD lent ». À mon sens, l’atelier était très intéressant dans ses intentions, trop ambitieux dans ses moyens et au final, raté dans son déroulement. En fait, Nicolas et Matthias ont développé un protocole d’intégration continue permettant aux participants de faire des propositions d’améliorations et de voir les mesures de perfomance comparatives de manière automatisée. C’est hyper-intéressant en théorie mais en pratique cela impose d’expliquer longtemps le protocole, de faire installer de très (trop) nombreuses dépendances aux participants… Je pense qu’il faut vraiment garder l’idée mais changer la forme, du moins pour les participants : les faire travailler dans un sous-dépôt ou sur une branche isolée moins complexe à prendre en main pour qu’ils puissent aller plus rapidement à la contribution d’optimisations. Là, le protocole a gâché la fête et c’était vraiment dommage. Je suis sûr que Nicolas et Matthias ont passé un temps fou à mettre en place tout ça et j’étais déçu de voir que finalement, les commits n’arrivaient pas.

Utilisabilité : le cas Firefox
L’UX, souvent un tabou dans les communautés du logiciel libre

Chrome est mon navigateur principal. À croire que Bruce Lawson ne m’a rien appris sur la monoculture mais que voulez-vous, j’ai pris des habitudes. Un matin, il y a quelques semaines, j’ai pris la décision de migrer mes profils vers Firefox, afin d’envisager avec davantage de recul mon outillage Web et revenir vers une initiative que je soutiens fortement depuis des années par des dons ou en faisant la promotion.

Une des fonctionnalités que je préfère sous Chrome est la gestion des profils. Très bien pensée, elle permet de basculer en un clic d’un profil synchronisé à un autre, et d’avoir plusieurs sessions simultanées synchronisées sur des profils différents. Je gère ainsi de manières complètement différentes mes profils personnel et professionnel ainsi qu’un profil spécifique pour ma femme (et je pense créer bientôt un profil pour les enfants pour éviter d’avoir Tchoupi et Trotro dans mon historique Youtube en permanence, les parents comprendront).

Retrouver le même fonctionnement sur Firefox est loin d’être évident. Il existe bien un gestionnaire de profils, mais il faut le lancer manuellement, en ligne de commande. Sous Windows, cela donne Touche Windows + R puis c:\Program Files (x86)\Mozilla Firefox\firefox.exe -p.

Ensuite, si on lance une deuxième instance de Firefox, celle-ci démarre automatiquement sur le profil déjà utilisé plutôt que de proposer le gestionnaire. Je n’ai pas hésité à faire part de ma déception sur Twitter.

J’avais bien évidemment tort : Firefox n’a aucun problème à gérer plusieurs profils simultanés, il faut juste le lui dire en ligne de commande (encore) ou en créant des raccourcis contenant les bons arguments (ce qui revient au même).

La conversation qui s’est déclenchée sur Twitter à la suite de ce message reflète très bien la vision que j’ai d’une partie de la Communauté du Logiciel Libre : d’une part, j’ai reçu une avalanche de conseils bienveillants, mais partageant tous une certaine technicité. Certains me conseillaient de lancer mes navigateurs en ligne de commande, d’autres me conseillaient de passer sous Mac où un module gère ça très bien.

Parallèlement, et c’est plus dérangeant, j’ai reçu un flot de messages où on me traitait d’incapable qui ne sais pas faire une ligne de commande ou pire, d’utilisateur de Windows (oui, c’est une insulte), de nuire en Logiciel Libre et plus particulièrement à Firefox en lui faisant une publicité négative alors que le projet est formidable.

On retrouve exactement les mêmes réponses à chaque fois qu’on se permet d’émettre une critique envers une alternative libre à un produit propriétaire. J’ai en tête immédiatement LibreOffice et GIMP, mais la liste est longue.

Sauf que mon problème n’est absolument pas là. La technique n’est pas un souci. Je suis sous Windows, mais je sais me servir de ma CLI, merci bien. La question que je soulevais était avant tout une problématique d’utilisabilité : il ne suffit pas que l’alternative fasse ce que la solution de référence fait. Il faut qu’elle le fasse bien et qu’elle donne à l’usager la sensation de gagner du temps. Tout le monde n’a pas des convictions suffisamment puissantes pour qu’elles soient le moteur d’une perte de temps ou d’un énervement à l’usage.

Et je suis le premier concerné par ce constat. Je me suis accroché, j’ai essayé mais, au final, mes convictions favorables envers Firefox sont moins puissantes que mon besoin et mon envie d’avoir un produit qui répond vite et de manière agréable à mon besoin. Même si ce besoin est conditionné (et j’en suis conscient) par l’utilisation d’un autre produit.

Encore une fois, ça n’a rien à voir avec les qualités techniques de Firefox, ses engagements géniaux, sa communauté formidable. J’aime Firefox, je donne à Mozilla, j’organise mes formations dessus, j’attends avec impatience la nouvelle version prévue pour les développeurs mais je ne l’utilise toujours pas comme navigateur principal.

L’utilisabilité est un véritable défi que la communauté Mozilla relève à bras le corps depuis plusieurs mois (avec une vraie refonte de l’interface utilisateur). Mais ce n’est pas en fermant les yeux qu’on résout le problème alors à la place, je suis allé voir les tickets relatifs au Profile Manager mais là, malheureusement, je n’ai réussi à séparer les tickets relatifs au développement de ceux relatifs à l’expérience utilisateur.

Alors j’ai posé directement la question à l’équipe UX de Firefox :

J’espère une réponse. Au pire, si elle ne vient pas, ce ne sera pas très grave : Firefox a d’autres besoins plus urgents que celui de remettre une couche d’UX sur son gestionnaire de profils. Je suis parfaitement conscient que mon besoin n’est pas celui du plus grand nombre et le mieux que je puisse souhaiter à Firefox c’est de continuer à les convaincre, eux. Moi, je sais déjà que Firefox est formidable, malgré cela.

Attitude d’homme blanc

En juin dernier, Fiona Taylor Gorringe soulevait une question intéressante sur son blog :

layout: post3 % des utilisateurs naviguent avec IE9 et 14 % des utilisateurs ont un handicap. Pourquoi on ne se préoccupe seulement que des premiers ? ».

Je ne dirais pas qu’on se préoccupe « seulement » des vieux navigateurs et jamais des utilisateurs avec un handicap. Mais j’ai clairement bien plus de demande explicite pour ces premiers que ces derniers. C’est un peu une « attitude de blanc » appliquée au web. Mais les minorités sur le web ne sont plus forcément celles qu’on croit.
« Regarde toutes les minorités » – HTeuMeuLeu (Rémi Parmentier)

Vagrant, Windows et NFS

Si vous développez avec Vagrant sous Windows, vous avez probablement déjà vu ce message :

Windows users: NFS folders do not work on Windows hosts. Vagrant will ignore your request for NFS synced folders on Windows.
NFS - Synced Folders - Vagrant Documentation

Ce temps est révolu ! Voici un plugin très pratique, qui permet d’activer NFS sous Windows pour vos boxes Vagrant. Il s’agit de vagrant-winnfsd, qui s’installe par un simple :

    vagrant plugin install vagrant-winnfsd

A noter que vous pouvez conditionner l’activation de NFS à sa présence, comme ceci :

nfs_setting = RUBY_PLATFORM =~ /darwin/ &quot;, &quot;, RUBY_PLATFORM =~ /linux/ &quot;, &quot;, Vagrant.has_plugin?("vagrant-winnfsd")
config.vm.synced_folder ".", "/var/www", :nfs => nfs_setting

Très pratique pour le développement Symfony2 notamment, car les nombreux accès fichiers ralentissent énormément l’exécution sans cela.

Un seul site vous manque, et tout le web est cassé

Ce détournement de la fameuse citation d’Alphonse de Lamartine est bien sûr dédié à la chute, hier dans la matinée, de Facebook.

Il aura suffit d’une trentaine de minutes d’absence pour mettre le Web en émoi et surtout, faire de grands dégâts un peu partout. Car énormément de sites sont dépendants de Facebook, qu’ils le sachent ou non, et une indisponibilité du géant peut avoir des effets désastreux.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Car il faut bien se rendre compte que de nombreux sites sont encore liés à Facebook par des scripts synchrones (ne serait-ce que l’inclusion d’un bouton « J’aime » mal développé). Chaque lenteur de Facebook est alors ressentie par les visiteurs et une indisponibilité peut engendrer des temps de réponse à la limite du timeout. Facebook devient, pour ces sites, un Point Individuel de Défaillance (ou Single Point of Failure, SPoF).

Si vous n’avez aucun outil de surveillance sur votre site, vous pouvez être passé à côté d’une dégradation de l’expérience de vos utilisateurs. Heureusement, des outils peuvent vous aider à détecter cette faiblesse en dehors de tout incident chez un tiers :

Evidemment, cette liste n’est pas exhaustive et Facebook est loin d’être le seul service tiers concerné (vous pouvez aussi avoir le problème avec des ressources distantes, comme des polices, par exemple).

Ne perdez pas le contrôle de vos sites à cause de dépendances synchrones, c’est tout-à-fait gérable autrement (et mieux), alors autant en profiter !

  1. En réalité, il interpose un proxy renvoyant les appels vers un site « trou noir » recréant ces conditions ↩

Le code a changé
ou l’absurdité d’une PPL sur le code à l’Ecole

J’entends de plus en plus de gens dire :

La programmation devrait être enseignée dès l’école ou le collège parce que je pense qu’il est important qu’un maximum de gens sachent écrire du code.

Si je suis plutôt d’accord avec le premier argument, le second me gêne profondément. Jusque-là, je gardais mon avis pour certaines discussions privées mais le débat a franchi un nouveau cap avec cette proposition de loi visant à rendre obligatoire l’enseignement du codage informatique à l’école

L’article L. 121-1 du code de l’éducation est ainsi modifié :

I. - Après la première phrase, sont insérées deux phrases ainsi rédigées :

« Les objectifs prioritaires assignés aux écoles sont l’apprentissage de la langue française, la maîtrise de la lecture, de l’écriture, l’utilisation des mathématiques et l’apprentissage du code informatique. Ces savoirs doivent impérativement être acquis lors de l’entrée au collège. »

II. - Au début de la deuxième phrase, les mots : « Ils contribuent » sont remplacés par les mots : « Les écoles, les collèges, les lycées et les établissements d’enseignement supérieur contribuent ».

Bien que nos députés s’y soient mis à 35 (incroyable) pour le signer, ce texte est d’une grande stupidité et je ne suis pas le seul à l’écrire (allez-y, ne serait-ce que pour voir la vidéo). Mais d’abord, regardons pourquoi on en arrive là…

Pourquoi on pourrait a priori être d’accord

Software is eating the world
Marc Andressen

Le monde logiciel fait partie intégrante de notre vie : la plupart des appareils qui étaient auparavant mécaniques embarque désormais des micro-contrôleurs, qui exécutent des routines écrites par des développeurs. Tous les secteurs sont progressivement concernés par cette révolution qui altère profondément le paysage économique mondial depuis une cinquantaine d’années, avec une fulgurante accélération ces 15 dernières années, grâce au Web.

A peu de choses près, nous sommes dans la même dynamique que celle qui a fait le succès des mécaniciens et des industries pendant la révolution industrielle : une caste très minoritaire de personnes (les informaticiens) détient aujourd’hui un jeu de compétences qu’une grande majorité de la population ne comprend pas et qui a une influence sur une grande variété d’axes économiques, avec parfois une incidence importante sur le quotidien des personnes (demandez aux caissières remplacées par des scanners ou aux ouvriers remplacés par des robots).

Sur le plan sociétal, l’informatique a également une position fondamentale. Parce qu’elle donne les moyens de traiter d’importantes quantités de données, elle permet de grands chantiers jusque-là impossibles (avez-vous déjà réfléchit à l’apport économique, très probablement incroyable, de Wikipédia ?). Mais elle permet aussi, par les mêmes moyens, de nombreux abus (notamment concernant le fichage des personnes). Ne pas comprendre comment tout cela fonctionne c’est, malheureusement, s’exposer.

Bref, si on s’arrêtait là, on pourrait se dire qu’en effet, le codage a sa place dans l’enseignement, au même titre que les mathématiques, le français et la propulsion de boulettes de papier. Mais en fait, non.

Pourquoi je ne suis pas vraiment d’accord

Coder n’est pas jouer

La science informatique est une science formelle, dont l’objet d’étude est le calcul au sens large, c’est-à-dire non pas exclusivement arithmétique, mais en rapport avec tout type d’information que l’on peut représenter de manière symbolique par une suite de nombres.
Wikipedia

L’informatique englobe un certain nombre de champs d’études qui vont bien au-delà du code. Car le code n’est qu’une façon de dire ce qu’on veut à une machine. Là où la science informatique a une vraie valeur, c’est dans sa définition de grands concepts d’infrastructure, d’algorithmie, de stockage… qui permettent de bien définir ce qu’on veut. Apprendre le code à des élèves ne les fera pas devenir chef de chantier, ça leur donnera uniquement une pelle pour creuser. Un peu comme si, du français, on n’apprenait que les mots, mais pas la grammaire, la conjugaison, l’analyse de textes de grandes auteurs…

Non, l’informatique n’est pas essentielle

Avez-vous la moindre idée de la façon dont l’eau est acheminée jusque chez vous ? Non, et pourtant vous ne pourriez pas vivre sans. Savez-vous comment fonctionne un moteur à injection ? Probablement que non, ou mal, mais votre emploi en dépend sûrement (directement ou non). Savez-vous gérer une prison ? J’en doute, pourtant les métiers du pénitentiaire ont de vrais besoins de recrutement.

Ces trois exemples ne sont pas là pour souligner l’impuissance du système éducatif à former des individus qui peuvent répondre à leurs propres besoins (eau), aux nécessités logistiques de leur pays (transport motorisé) ou à des impératifs économiques (insuffisance des profils managériaux dans le monde pénitentiaire). Au contraire, ils sont là pour souligner sa versatilité.

Parce qu’il est impossible de former des gens à tout, il est important de les former à l’essentiel et de leur apprendre à apprendre.

Si vous le voulez, vous pourrez apprendre la logistique, la mécanique et un nouveau métier parce que vous savez lire, compter, réfléchir et apprendre (et que vous avez a priori un peu de temps à passer à ce sujet). L’informatique est évidemment importante comme outil pour réaliser autre chose (en tant que savoir-faire, donc) mais son enseignement en tant que savoir est probablement moins important aujourd’hui que celui du Français ou des Mathématiques (qui sont des fondamentaux. Vous vous imaginez vivre sans savoir écrire et compter, vous ?).

Les cordonniers sont des gens qui n’ont vraiment pas de bol

L’informatique, en tant que science de l’information, est très bien lotie. Vous connaissez l’expression « Les cordonniers sont les plus mal chaussés » ? Nous, c’est l’inverse. Il est incroyablement facile de trouver de la formation en ligne concernant le code et l’informatique en général. Tutoriaux, MOOC, blogs, entreprises… tout le monde partage son savoir, en discute, le remet en cause régulièrement.

Evidemment, le niveau de compétence varie énormément d’un site à un autre. Certaines sources d’informations sont fiables, d’autres non. Certaines instruisent, d’autres donnent des astuces. Mais je préférerais de loin que le système éducatif continue à apprendre à nos enfants à faire des recherches documentaires efficaces - en recoupant, justement, les informations - sur le sujet de leur choix plutôt qu’il les forme à coder des boucles itératives. Ils auront tout le loisir d’apprendre ça sur Internet plus tard, s’ils le souhaitent.

Enseignement non, Culture oui

Alors que faire ? D’un côté, l’importance du code est indéniable. De l’autre, son enseignement en tant que matière dans les cursus de l’Education Nationale n’a pas vraiment de sens.

Ne changeons rien

En fait, l’Education Nationale n’est pas complètement stupide (peu importe ce qu’en pense le législateur) et il existe un truc extraordinaire qui s’appelle le socle commun des connaissances et des compétences. Ce socle présente ce que tout élève doit savoir et maîtriser à la fin de la scolarité obligatoire. Dans ce socle figurent la compétence mathématique et les compétences de base en sciences et technologies.

Ces compétences sont, bien sûr, enseignées à travers plusieurs matières dont les Mathématiques, la Physique, la Chimie, l’Histoire (oui, l’Impression ou la Revolution Industrielle, c’est aussi de l’histoire des Sciences), la Philosophie et l’Education Civique (pour l’enseignement du concept d’information, son importance et le contrat social entre les citoyens et l’État à qui ils confient la sécurité de leur vie privée)… et la Technologie.

En sixième, le domaine d’application retenu est : les moyens de transports.

  • analyse de produits (objets techniques peu complexes) pour comprendre les besoins essentiels ou créés auxquels ils répondent, leur constitution et leur fonctionnement,
  • découverte et la mise en œuvre de moyens élémentaires de fabrication,
  • usage raisonné des technologies de l’information et de la communication.
  • évolution des objets à travers le temps.
    Wikipedia, « Technologie dans les collèges français »

Il serait donc peut-être pertinent qu’on offre aux professeurs de Technologie l’opportunité de mieux enseigner leur matière avant de proposer d’ajouter des choses au programme, non ?

Ouvrir l’enseignement

Mais ce n’est pas la seule opportunité qui s’offre au législateur : l’ouverture de l’Ecole publique à des interventions (bien encadrées) de personnes du secteur privé en est une, le temps périscolaire imposé à nos élèves de primaire en est une autre. Par exemple, durant ces moments municipaux déconnectés de l’Education Nationale, il serait très facile d’enseigner les bases de l’informatique à des enfants en jouant :

  • Une craie et un dessin au sol suffisent à enseigner le tri par bulle.
  • Ils sont ravis d’apprendre les bases de la stéganographie. Apprenez-leur un chiffre de César, vous verrez !
  • Distribuer une balle à chacun, alignez-les en file indienne et faites passer un seau dans lequel chacun pose sa balle avant de passer à son voisin. Parfait, ils ont maîtrisé l’itération. Comment décider à quel moment donner le seau, et si la file est circulaire, à quel moment le récupérer ? Parfait, vous venez de les sensibiliser à la condition de sortie.
  • … etc.

Cette approche à plusieurs avantages :

  • Elle est ludique.
  • Elle peut démarrer très tôt dans la formation des enfants.
  • Elle donne de véritables concepts, ne fait pas de nos enfants des presse-boutons.

Qu’attend-on ?

Vraiment prendre le taureau par les cornes

Mais tout cela doit s’effacer derrière une réalité bien plus forte : l’informatique n’est pas un impératif d’enseignement, c’est un impératif de Culture de l’ensemble de la Société, au même titre qu’un bagage essentiel de plein de petites choses qui manquent pour être des individus libres dans la France d’aujourd’hui.

Pour toutes les raisons déjà évoquées, l’informatique a une influence considérable sur la vie de nos citoyens : pas demain, pas après-demain, aujourd’hui. C’est donc la génération actuelle d’actifs qu’il faudrait convaincre et éduquer en parlant davantage des problématiques liées aux données.

La Presse et la télévision pourrait par exemple expliquer plus souvent les erreurs incroyables qui parsèment les fichiers de Police et Gendarmerie ou le gain potentiel qu’on peut tirer d’une Stratégie Numérique bien pensée. Nous pourrions même aller jusqu’à proposer des exercices de logique à la fin des journaux (il suffirait d’écrire un article sur l’automatisation de la résolution d’un Sudoku) ou, soyons encore plus audacieux, des programmes dédiés à l’informatique dans la programmation télévisuelle du Service Publique.

Ça aurait plus de gueule que les Ch’tis à Choubidous-Sur-Yvette, non ?

Un outil pour enseigner le Web Front-End
suite d’un atelier Sud Web 2014

Romy, Delphine et Rémi ont animé un atelier en deuxième journée de Sud Web 2014 sur l’enseignement de l’intégration Web dont Rémi a déjà fait un résumé sur son blog. J’ai moi aussi été interpellé par la question, ayant déjà enseigné le développement Front-End auprès de jeunes adultes comme de professionnels en formation continue.

Les pièges à éviter, selon moi :

  • Pas la peine d’enseigner le développement Front-End comme on le pratique professionnellement aujourd’hui. Les étudiants le pratiqueront plus tard, dans un autre contexte et avec un jeu de contraintes qui aura sûrement changé. Si vous êtes intégrateur (ce qui n’est pas mon cas), cela veut simplement dire que vos préoccupations du moment ne sont pas les centres autour desquels doivent tourner vos cours. Très facile à dire, très difficile à faire. De mon côté, je préfère me concentrer sur les valeurs fondamentales du Web et appuyer chaque brique de nouveau savoir soit par ces valeurs, soit par une explication économique (pour expliquer les préfixes navigateurs, par exemple). C’est pourquoi je commence systématiquement mes cours par une introduction rapide (et souvent drôle, ça s’y prête plutôt bien) à l’histoire du Web, depuis sa création jusqu’à la lutte des navigateurs et des standards d’aujourd’hui.
  • Les MOOC comme OpenClassRooms sont formidables, mais ils ne fonctionnent pas sur les mêmes enjeux qu’une formation en salle. Ils peuvent être suivis indépendamment d’autres élèves, sans contrainte de rythme ; sont souvent destinés à des gens déjà passionnés et ne se préoccupent pas du niveau. Un cours en salle se heurte à un public de motivations différentes, de niveau variable, n’ayant pas une perméabilité homogène au savoir et régi par des phénomènes de groupe (adhésion, alliance, défiance, opposition). Rien à voir.
  • De nombreux enseignants ne supportent pas de mettre des étudiants en échec ou plus généralement, de s’opposer à eux. Pourtant, Daniel Kahneman l’explique très bien : notre perception d’une expérience après qu’elle a eu lieu est très différente de notre ressenti instantané. En d’autres termes : un élève en situation d’échec peut vous détester à un instant T, mais surmonter ses difficultés et apprécier l’ensemble d’un enseignement a posteriori. D’ailleurs, si vous pensez à vos enseignements les plus marquants : étiez-vous toujours en phase avec vos professeurs ? Ceci étant dit, l’enseignement par l’échec seul n’est pas nécessairement un bon angle d’attaque : pour apprécier l’échec, encore faut-il connaitre l’objectif raté, sinon l’analyse de l’échec ne ramènera que du ressentiment. Il est donc nécessaire d’alterner phases d’explications et phases d’applications, fussent-elles difficiles pour les étudiants.

Mais revenons-en au développement Front-End. Depuis des années, les formations se suivent et se ressemblent en proposant d’utiliser un quelconque éditeur de texte pour écrire des pages Web. C’est plutôt une bonne chose mais il faudrait intégrer rapidement des périmètres et des outils car le développement Front-End d’aujourd’hui et de demain se compartimente de plus en plus (compétences générales, spécialisations dans des domaines spécifiques comme Canvas, WebGL, l’accessibilité, la sémantique…) et s’outille également (plugins pour éditeurs de texte, IDEs, gestion des dépendances et automatisation, tests multi-navigateurs/solution mail…).

Mais j’ai quand même l’impression qu’entre l’éditeur de texte « de base » et les outils complexe de Production, il y a un chaînon pédagogique manquant, une espèce d’environnement de développement coloré mais limité qui permettrait, en jonction des modules chargés, de servir un objectif pédagogique. S’il existait, cet outil devrait être :

  • Simple : cet outil serait léger et délibérément très simple au niveau de l’UX pour laisser le plus de place possible au code, et n’hésiterait pas à utiliser de la couleur pour faciliter la compréhension de l’imbrication (naturelle pour nous autres, moins pour les plus jeunes) ;
  • Fait pour enseigner : cet outil devrait être délibérément développé avec en tête l’objectif pédagogique. L’utiliser pour produire serait probablement une erreur, voire impossible ;
  • Interactif : non seulement cet outil permettrait la création de contenus Front-End, mais il serait en parallèle à même de donner des informations qualitatives et des conseils d’implémentation (« Attention : ce sélecteur est probablement trop long. Regardez bien la structure du document pour trouver un sélecteur plus efficace. »). Un peu à l’image des notes de WebPageTest ou des Best Practices de PageSpeed Insights, mais en plus simple ;
  • Portable : tous les enseignants ayant eu une classe à l’équipement hétérogène vous le diront : unifiez au maximum pour éviter les élèves qui ont toujours « le comportement différent » du reste de la classe ;
  • Innovant : si je pense qu’il manque un outil, c’est qu’à mon sens aucun des IDE ou des librairies CSS existantes n’offrent les fonctionnalités voulues.

Plus concrètement, je verrais bien quelque chose qui se lancerait de manière similaire sur tous les OS et qui afficherait un éditeur Web offline qui pourrait ressembler à Mozilla Thimble (je ne sais pas s’il est utilisable offline ou dépendant d’un back-end, mais si ungit peut offrir une UI pour Git avec une simple dépendance à node, alors un IDE Web devrait pouvoir le faire aussi).

Cet éditeur serait complété d’un framework HTML/CSS/JS et d’un ensemble de templates HTML et de Web Components dédiés à la pédagogie. Une brique serait par exemple dédiée à l’apprentissage des formulaires, de leur intégration à leur contrôle en JS. Une autre à l’utilisation des grilles typographiques ; une autre à l’importance de la sémantique, avec possibilité depuis l’éditeur pédagogique de lancer un scrapper qui présenterait le « sens » qu’il aurait compris de la page ; une autre à la performance Web, avec un test rapide des bonnes pratiques (rien d’exhaustif, encore une fois : enseigner et pratiquer sont deux choses vraiment différentes)… vous avez compris l’idée.

On pourrait ensuite introduire ces briques dans le cadre d’exemple concrets de plus en plus complexes à la fois en terme de techniques pures, d’environnement (au début, on travaillerait pour la cible locale, puis à terme pour différentes cibles avec de plus en plus de contraintes) et d’UX (permettant d’introduire les problématiques de positionnement et d’innovation typographique).

Je vais me rapprocher de WebMaker.org. Quand je vois ce genre de chose, j’ai vraiment l’impression qu’il y a des trucs à creuser de ce côté-là…

Ci-dessous mon petit croquis pendant l’atelier SudWeb :

De retour de Sud Web 2014
De beaux projets, de belles personnes

Sud Web fait partie de ces événements qu’il est difficile de ranger dans l’appellation « conférences ». Cette édition 2014 assumait parfaitement cet héritage avec des interventions dont l’objectif était moins de transmettre du savoir que d’inspirer des conversations et de susciter des vocations. Je ne déroge pas à la règle : cette année encore, Sud Web a parlé ma langue, ma Culture, Sud Web a interrogé mes valeurs et m’a renvoyé une image de moi au sein de la Communauté du Web. Explications au travers de quelques moments forts de ces deux jours.

Valeurs

Kevin est venu nous parler de la façon dont les valeurs fondamentales de Spotify définissent son organisation et sa gestion des ressources humaines. C’est un sujet qui me tient à cœur : depuis plusieurs années, j’essaie de comprendre ce qui fait que j’aime travailler pour mon employeur et j’ai le sentiment qu’un certain nombre de valeurs fondamentales, non explicitées mais qui mériteraient peut-être de l’être, en sont la cause. Ce sont ces valeurs, dont je sais que je les partage avec mes collègues de manière implicite, qui alimentent à la fois notre ambiance de travail, le jeu de contraintes dans lequel nous exprimons notre créativité et notre épanouissement technique. Kevin, as you can see, I’m french but I’m not tired of being happy.

Fraîcheur

Cécile m’a profondément touché, car son approche du medium est à la fois rare et géniale. Auteure de « Elise, une histoire responsive », elle est venue nous parler de sa vision de « bébé » du Web et de comment elle avait voulu s’en servir pour raconter une histoire à plusieurs dimensions. Poétique et bien réalisé, son projet rejoint également des problématiques que je rencontre de plus en plus avec mes clients dans le cadre de la Direction Artistique de projets à forte composante narrative, comme les WebDoc ou Formats Longs (plusieurs dénominations qui recouvrent un périmètre parfois flou, un vrai sujet de débat si vous avez du temps à passer dans les commentaires).

Richesse

Rémi a animé la conférence qui m’a le plus ému, car elle me parlait de moi. Elle me parlait de mon enfance du Web, de la façon dont, à l’époque, nous pouvions être les rois du monde avec deux pages HTML blindées de <table> mais qui servaient leur objectif d’échange de l’information. Le monde a grandit aussi vite que nous, et nous jouons probablement beaucoup moins à la Game Boy qu’avant, mais il reste une vérité : celle de s’accrocher à la simplicité de notre medium, sans en écarter la richesse. Cela nous permet, sur des bases qui sont pourtant communes et standardisées, d’être régulièrement en désaccord sur les directions à prendre, les bonnes pratiques et les implémentations (y compris dans les commentaires de son propre blog et il adore ça). C’est une richesse qu’il nous faut entretenir.

Echanges

Kaelig animait une conférence qui parlait d’un langage en vigueur au Guardian. Mais pas, comme nous aurions pu le penser, d’un langage de développement. Non, Kaelig nous parlait d’un langage commun entre métiers différents (développeurs, designers…), pour fluidifier les échanges et revenir à l’essentiel : produire un contenu ensemble plutôt que les uns à côté des autres, isolés par les barrières de nos langues respectives. SASS était au cœur du sujet mais il n’était que l’outil permettant d’exprimer ce langage commun. Une vraie leçon de management de projets technologiques et une réponse plutôt probante au problème de l’aubergine !

Créativité

Eva-Lotta, avec tout le tonus qui la caractérise, a réveillé l’ensemble de l’assemblée en nous invitant à faire quelque chose de très rare lors d’une conférence magistrale : dessiner. À force de petits points, de nuages, de traits et de formes, Eva nous a permis de nous rendre compte que réaliser des croquis est à la fois simple et puissant, qu’il existe des méthodes pour réveiller notre créativité et que nous pouvons tous surmonter la peur que nous avons de prendre un crayon. Eva doit être contente : nous sommes nombreux à avoir fait des petits dessins pendant deux jours. Peut-être se cache parmi nous le prochain Romain Couturier (Romain dessinait des représentations graphiques des conférences en live. Une performance très synthétique d’une difficulté qui va bien sûr au-delà du simple croquis).

Humilité

J’ai le sentiment d’avoir un peu participé à Sud Web. Moins par ma prestation, relativement courte, que par mes interventions (beaucoup moins sous contrôle) et les nombreux échanges que j’ai pu avoir avec les personnes présentes. Mais j’ai surtout été submergé par ce que j’ai vu autour de moi. Il y avait de belles idées, porteuses de valeurs éthiques fortes ou de potentiels importants (notamment, est-ce un hasard ou un signe des temps, concernant la visualisation de données). Mais il y avait aussi, et surtout, de belles personnes capables de s’investir dans des réalisations qui apportent à l’ensemble de la communauté du Web qu’il s’agisse de projets techniques, managériaux, de pédagogie, de partage de valeurs, de savoir-faire ou d’expérience (si tu te reconnais là-dedans, oui, c’est bien toi dont je parle). La prochaine édition de Sud Web aura lieu à Montpellier. Ce sera plus compliqué pour moi, mais j’espère pouvoir y être. See you soon, guys.

Préparation d’une miniconférence
génèse de ma conférence pour Sud Web 2014

Note : et voilà, c’est fini, pfiou ! Pour les curieux, les slides sont là (et vous pouvez taper sur la touche ‘s’ pour voir la transcription).

On m’a dit un jour :

Les experts ne sont pas toujours des experts avant de prendre la parole : c’est leur prise de parole qui fait que nous les considérons comme des experts.

Je ne sais pas pourquoi. Peut-être parce que nous savons, au fond de nous, que la prise de parole nécessite un travail important en amont, sans forcément arriver à l’évaluer…

Il y a quelques mois, j’ai soumis une idée pour un Lightning Talk (une courte présentation) pour Sud Web : « De l’idée au projet ».

Ma participation m’a été confirmée il y a quelques semaines, mais je n’avais pas le temps de m’occuper d’y penser, donc j’ai remis ça à plus tard. Nous sommes le 21 avril, un peu moins d’un mois avant Sud Web. Il est temps de réfléchir aux imbécilités que je vais énoncer devant les 150 pauvres âmes qui devront me supporter pendant 5 minutes ce jour-là.

J-25 : L’idée

Lorsque j’enfile ma casquette de consultant ou de chef de projet, mon travail consiste très souvent à aider un client à formaliser une idée. Cette idée peut être plus ou moins mûre, plus ou moins réfléchie, plus ou moins porteuse : mon travail n’est pas de la remettre en question, mais plutôt de participer, en apportant mes connaissances et mon expérience, à sa formalisation.

Au fil des années, j’ai appris à ne pas faire ça n’importe comment et à passer par des outils comme le Business Model Canvas, Lean Canvas et plus généralement, tous les concepts empruntés au Design de Services, domaine méconnu mais ô combien intéressant des sciences cognitives.

En proposant ce concept à Sud Web, je voulais présenter tout cela. En 5 minutes. Ça va faire court.

J-24 : Les grandes lignes

Une fois qu’on a l’idée, encore faut-il démarrer l’écriture. Ma principale difficulté, dans ce genre d’exercice, est de toujours me focaliser sur l’introduction. Mais en cinq minutes, c’est ridicule. En 5 minutes, l’introduction dure 30 secondes. Il faut donc être clair et précis dans la présentation d’une trame. Dans les quelques minutes que je vais avoir à ma disposition, il faut que j’arrive à faire passer trois idées :

  • Les idées sont volatiles, les capturer est difficile
  • Formaliser son idée en utilisant un modèle (exemple : Lean Canvas)
  • Transmettre son idée pour l’expérimenter : à qui, comment ?

J-23 : La répétition

Dans un exercice oral comme celui-là, le rythme et la répétition sont importants, ainsi que l’utilisation de repères simples à se remémorer. Il est ainsi possible de reformuler légèrement les trois points principaux de manière à pouvoir en parler sous une forme qui sonne juste. J’ai opté pour des verbes, symboles d’action, et je les ai pris commençant tous trois par un « C »… parce que c’est marrant :

  • Capturer,
  • Conceptualiser,
  • Confronter. Ça me semble pas mal, même si je ne suis pas pleinement satisfait du « conceptualiser ». Mais ça servira son objectif : imposer un rythme.

J-20 : La rédaction

Un Lightning Talk est trop court pour ne pas être rédigé. Lorsqu’on lit un texte, notre vitesse moyenne est de 340 mots par minutes. À l’oral, nous sommes plutôt à 180 mots. Et pour que les gens soient attentifs, mieux vaut parler clairement et lentement, et donc compter 160 à 170 mots par minute. 5 minutes, cela fait entre 800 et 850 mots.

Le plan à « trois C » me convient bien, mais avant de rédiger, il faut que je développe un peu les idées-clés, et que j’attribue à chaque partie une longueur, pour être sûr de ne pas avoir un contenu déséquilibré :

  • Introduction (~120 mots) : les idées dans ma vie de consultant, pourquoi elles n’arrivent que rarement jusqu’au statut de PMV
  • Capturer (~180 mots) : parler de la volatilité, de l’agacement et/ou de l’impatience de l’auteur. Inciter à s’équiper d’un crayon et d’un carnet pour griffonner, présenter des outils méthodo comme le Mind Mapping ou l’Affinity Diagram.
  • Conceptualiser (~180 mots) : introduire le Lean Canvas comme un modèle, parmi d’autres, de formalisation. Insister sur les forces du modèle : notamment celle de mettre en exergue les zones d’inconfort dans notre concept.
  • Confronter (~180 mots) : importance de l’interlocuteur, outils de formalisation pouvant être complétés par des outils méthodologies dédiés à l’échanges qui souvent complètent le projet
  • Conclusion (~120 mots) : ne laissez pas vos idées s’envoler sans leur avoir donné leur chance. Exemple : Sud Web, une bien bonne idée.

J-17 : Premier jet rédactionnel

J’ai essayé, au maximum, de ne pas passer trop de temps sur le premier jet rédactionnel en lui préférant l’itération. Je suis à 792 mots, répartis en 110 / 171 / 197 / 190 / 124, j’ai donc des introductions et conclusions un peu plus courtes que prévu, mais au final, je rentre dans les contraintes que je m’étais fixé.

J’ai tenté un premier minutage, en parlant assez doucement. Je suis à un peu plus de 5 minutes, c’est trop. Sur place, je parlerai probablement plus vite à cause du trac mais d’un autre côté, il faudra changer de slides et anticiper les imprévus (on n’est jamais à l’abri d’un cafouillage qui fait perdre de précieuses secondes). J’essaierai de simplifier tout ça quand j’aurais fait quelques slides de support.

J-15 : Le nombre de slides

Il n’est pas donné à tout le monde de faire des présentations à la Steve Jobs. J’ai abandonné depuis longtemps mes rêves de réaliser des présentations fabuleuses de 30 minutes avec uniquement 5 photos piquées dans une banque d’images National Geograpic.

Pour cette présentation, la contrainte est claire : très peu de temps. Cela implique qu’il faudra concentrer l’attention et donc éviter la dispersion et présentant trop de contenu. Mais cela veut aussi dire que les spectateurs n’auront, objectivement, pas le temps de retenir des informations. Remplir des slides de contenu est donc inutile, voire contre-productif. Il faut donc se cantonner à un transparent toutes les 45 secondes à 1 minute, soit environ 7 slides. Disons 8, grand maximum, et principalement des choses très visuelles.

J-14 : Premier jet de slides

Pour le medium, j’ai choisi Reveal.js. Je trouve la solution Web RWD pratique dans la mesure où je dispose de peu d’informations sur l’ordinateur qui sera utilisé pour présenter le contenu : je ne peux que difficilement me tromper en considérant qu’il dispose d’un navigateur récent.

J’ai repris mon premier jet rédactionnel et j’ai regardé le paragraphe que j’y avais mis pour séparer les contenus en unités logiques. 7 unités, 7 slides. À force de ressasser ma trame, j’ai des idées de contenus plutôt visuels et parfois drôles qui me sont venus, ça devrait fonctionner.

J’ai ajouté des slides qui sont uniquement dédiées à la présentation d’outils méthodologiques issus de la boite-à-outils du Service Design. Malheureusement, cela augmente à la fois le contenu rédactionnel (je ne peux pas présenter des outils sans en parler) et le temps passé.

J-10 : Petites itérations

Je reviens sur mes premiers jets, sans en être satisfait. Les tournures de phrases ne passent pas à l’oral et surtout, j’ai beaucoup de mal à les mémoriser. Note pour plus tard : corriger ça. Je laisse tomber cette frustration pour l’instant, impossible de trouver comment reformuler. Je verrais cela plus tard, à tête reposée.

J-4 : Répétition

Thomas m’a proposé une répétition. Dans les grandes lignes, cela se passe bien. Il me fait quelques commentaires constructifs qui m’obligent encore une fois à ajouter du contenu à ma présentation, notamment pour mieux en dessiner l’objectif.

Je m’aperçois également que j’ai lu mes notes pendant l’appel, ce qui est un assez mauvais signe d’appropriation : je suis plutôt du genre à mémoriser rapidement d’habitude, du moment que je trouve cela cohérent avec un discours. Ce n’est pas le cas. Je reformule donc de nombreuses parties.

J-1 : La pression monte

Je suis environ à 1200 mots, ce qui est très loin de mon premier jet initial inférieur à 800 mots, mais je maîtrise assez bien l’enchaînement qui contient davantage de répétitions et de tic de langages qui facilitent sa mémorisation. Par contre, là où ça peut coincer, c’est que je me minute régulièrement à 7-8 minutes (note post-présentation : cela sera en effet mon chrono).

Plus ça va, plus je me rends compte qu’un Lightning Talk est, par bien des aspects, plus compliqué à produire qu’une présentation de 30 minutes où on peut laisse davantage de place à l’improvisation. Advienne que pourra, plus moyen de faire demi-tour et évidemment hors de question de retoucher aux slides au denier moment. J’aviserai sur place, en fonction de notre conformité au planning. S’il le faut, j’irai plus vite sur certaines parties… si je peux.

Encore de la marge…
Pour mieux apprivoiser nos matériels

Déjà 7 ou 8 ans que les premiers articles ont été écrits sur le design des applications web en fonction des capteurs disponibles. L’idée : utiliser tous les services dérivés des capteurs disponibles pour offrir des sites web réactifs.

Où en sommes-nous ?

Les services plutôt bien utilisés aujourd’hui :

  • la localisation ;
  • le gyroscope ;
  • l’orientation du matériel ;
  • la capture image et vidéo (mais on peut mieux faire niveau partage).

Les services encore très peu utilisés :

Je ne sais pas où en est la réflexion des organismes normalisateurs sur l’ensemble de ces points (notamment si quelque chose avance sur la détection de pairs). Il faut commencer à réfléchir à l’utilisation de ces informations, il y a des opportunités.

Relations [virtuelles]

We know that happiness is mainly being satisfied with people that we like, spending time with people that we like. There are other pleasures, but this is dominant.

« The riddle of experience vs. memory », Daniel Kahneman ", TED

Ma présence sur le Web est un paradoxe pour certains de mes proches. Perpétuellement connecté, ils s’étonnent de ne pas recevoir plus de nouvelles de ma part…

Je ne pense pas que mon cas soit isolé, mais il est parfois difficile de mettre les mots sur ce que l’on ressent. J’essaie d’écrire cette article depuis plusieurs semaines sans en être totalement satisfait. Peu importe, autant le publier comme cela : s’il génère une discussion, peut-être que d’autres arriveront à dire les choses mieux que moi.

Internet n’est plus un outil pour moi. Il tient une place dans mon identité. Je m’en passe parfois pour vivre d’autres expériences (voyages, événements importants…) mais il fait partie de mon quotidien. Donnez moi une journée « normale » sans Internet et vous aurez affaire à une version un peu plus « tendue » de moi-même.

Un schéma humoristique comparant la durée pendant laquelle un humain peut se passer de choses essentielles comme manger, boire… et avoir accès à Internet

Mais Internet n’est pas qu’un outil consultatif, c’est également une magnifique, peut-être la plus incroyable, plate-forme sociale de tous les temps. Et j’y ai un réseau de contacts avec lesquels j’entretiens des relations via divers outils. Ces relations sont particulières. Elles s’organisent dans une chronologie affective et professionnelle basée sur une temporalité particulière (profondément asynchrone) et le dialogue. Elles s’expriment dans les réseaux sociaux, sur des messageries instantanées. Elles définissent une communauté virtuelle de proches avec qui je vis au quotidien, mais qui ne me connaissent pas, ou peu. Nous co-vivons, affranchis des limites du temps et de l’espace, mais nous ne vivons pas « ensemble ». Les relations tissées par ces media ne sont pas factices, mais elles ne sont pas profondes pour autant. J’éprouve de l’empathie pour les personnes que j’y croise, je les apprécie, nous avons des « moments » intéressants, enrichissants, parfois animés, qui font occasionnellement naître des questionnements profonds… mais je ne confonds pas cela avec de l’amitié.

D’autre part se trouvent mes amis, mes « proches ». Le terme est imparfait car évoquant la distance, alors que certains de mes proches ne le sont, géographiquement, pas du tout. Je fais mon possible pour qu’ils sachent, quand je les vois, que je tiens à eux. Mais je n’éprouve pas le besoin d’être connecté à eux. Ni dans le temps, ni dans l’espace. Il peut se passer plusieurs mois sans que nous ayons des nouvelles les uns des autres, sans que cela ne gêne nos relations futures. Pour autant, si nous avons la chance de pouvoir nous rencontrer physiquement, le temps ne s’écoule plus et si les contraintes de la vie ne me rappelait pas à une certaine temporalité, nos discussions pourraient nous prendre des journées entières. Ma relation à eux me semble vraie, sincère, même si elle n’est parfois qu’épisodique. Elle préfère le face-à-face aux outils virtuels et regrette, d’une certaine façons, qu’Internet et plus particulièrement Facebook prenne peu à peu la place des discussions autour d’un café.

Infusion numérique

L’idée centrale de [l’]ouvrage [de Tyler Cowen] est que l’évolution technologique va totalement polariser le monde du travail entre des travailleurs hyper complémentaires aux machines intelligentes et très bien rémunérés et une masse informe d’individus peu compatibles et clairement laissés sur le bas côté.

« Le système éducatif français en phase avec l’avenir (troll à méditer) » par Stéphane Menia pour Econoclaste

Le marché de l’emploi est en constante mutation. Dans la branche des Services, les bases de l’informatique grand public sont devenues un pré-requis communément admis. Impossible de trouver un emploi si on ne sait pas se servir d’un PC sous Windows et ouvrir Office. Mais on aurait tort de penser que l’inclusion de l’informatique va s’arrêter là.

Je suis également persuadé qu’une mutation lente va, durant dix prochaines années, voir s’imposer une séparation naturelle entre ceux qui sont capables de mettre à profit l’outil informatique pour réaliser les missions qui leur sont confiées et les autres. Je ne parle pas de savoir se servir d’un traitement de texte ou d’un progiciel pour répéter la même tâche ad nauseam mais bien de connaitre les bases de la recherche d’information, du traitement de données ciblées comme plus générales, de l’automatisation de la production de livrables ou de la modularisation de la boite à outils de l’entreprise.

D’ici 2020 – autant dire demain – 90 % des emplois nécessiteront des compétences numériques, et nous ne sommes pas prêts.

Neelie Kroes, vice-présidente de la Commission européenne chargée de la stratégie numérique

Ces profils existent déjà. Je les croise lors de mes missions. Ils ne sont pas informaticiens, mais comptables, secrétaires, commerciaux, politiques, journalistes… Et même parfois ouvriers, agents d’entretien, chauffeurs… Ils sont souvent précurseurs au sein de leurs structures et n’ont besoin de notre aide que pour appuyer des stratégies numériques déjà amorcées, ou pour les inscrire dans la durée. Ils se renseignent, apprennent, influencent et mettent en place les briques d’un système d’information sans même le savoir.

Un schéma montrant que devant une tâche répétitive, les &quot;geeks&quot; perdent du temps à mettre en place une solution algorithmique… qui s'avère rentable sur le long terme.

Gestion des tâches répétitives par les "geeks" et les "non-geeks". Difficile de trouver la paternité, même si plusieurs sources remontent à Bruno Oliveira.

Je pense à ce boulanger, auquel un apprenti avait installé un outil de gestion de la relation client (CRM) pour la gestion de ses ventes en nombre aux entreprises. J’ai également en tête ces danseuses qui étaient allés chercher des étudiants en informatique pour les aider à réaliser un projet de spectacle dynamique où le public pourrait visualiser et influencer les chorégraphies via son smartphone. Arrivés sur place, les étudiants avaient la surprise de voir que les danseuses avaient uniquement besoin d’eux pour des détails, ayant appris sans eux à produire un site web mobile. Et je ne parle même pas de tous ces journalistes qui découvrent, les uns le Web en tant que médium, les autres les joies du fact-checking, véritable expertise de la donnée ou de ces élus locaux qui entre-aperçoivent le potentiel participatif du Web pour une meilleure répartition du pouvoir entre élus et citoyens.

On pourrait penser que seuls ceux qui auront la chance de bénéficier d’une formation adéquate sortiront leur épingle du jeu. Je ne le pense pas, du moins pas à l’échelle des 10 prochaines années. Tout me laisse à penser que le système éducatif n’est pas davantage prêt pour cette Infusion Numérique qu’il n’était prêt pour la Révolution Industrielle. L’Education dans le primaire et le secondaire a d’autres objectifs et le suivi d’étudiants en Grandes Écoles de Commerce ou en d’Informatique me le confirme : nous produisons encore beaucoup de profils très orientés vers l’informatique ou vers la réalisation des missions confiées, rarement les deux. Certains étudiants s’en sortent mieux à l’Université où ils arrivent à composer leur cursus en fonction de leurs besoins. Mais ce n’est pas le système qui les aide, ce sont eux qui l’utilisent. Quand ils ne se perdent pas en essayant de rentrer leur profil dans une des cases du jeu qu’on leur présente, ces étudiants sortent très vite du lot et opèrent là où on ne les attend pas, apportant des compétences numériques à des métiers, des associations ou des arts auxquels ils donnent un souffle nouveau.

Tout se jouera donc, à court terme, sur la capacité de quelques individus à se former seuls (et en continu) via, par exemple, des cours en ligne (avec notamment un plein essor des MOOC en France) ou le recours à la formation continue ; à encourager leurs enfants pour qu’ils intègrent au plus tôt les gains à l’usage comme intellectuels permis par la découverte de la programmation (par le biais de Coding Goûter par exemple) ; à ne pas stigmatiser leur construction d’un profil social aussi numérique que non-numérique.

Reste une inconnue, la rencontre sur le marché de l’emploi entre ces profils et leurs futurs employeurs. Il y a fort à parier qu’elle ne se passera pas dans les infrastructures d’État comme le Pôle Emploi, ne disposant déjà pas des ressources suffisantes pour analyser correctement les profils plus « classiques » qui s’y inscrivent. Plus probablement, le recrutement se fera par le biais de cabinets spécialisés à qui je souhaite bien du courage. Car l’homo numericus ne se trouve pas dans les listings de diplômés. Il est nulle part et partout à la fois, probablement là, derrière son écran, à changer le monde sans le savoir.

A la conquête des Tests A/B

Matthieu n’est pas du genre à prendre une décision à la légère, surtout lorsqu’elle risque d’avoir un impact sur le chiffre d’affaire de son entreprise. Il aime essayer avant d’adopter. C’est pourquoi il a décidé de se lancer dans les Tests A/B.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Une histoire de tests A/B

Matthieu n’est pas tatillon, loin de là, mais ses responsabilités et sa conscience professionnelle l’obligent à mesurer chaque évolution du site Internet de son entreprise, de manière à assurer l’amélioration de l’ensemble des indicateurs clés à chaque livraison.

Un crayon écrit un point d'interrogation sur un carnet

"Questioned Proposal" par Ethan Lofton - CC BY 2.0

Mais parfois, il faut l’avouer, Matthieu ne sait pas. Il hésite. Il se pose des questions : cette fonctionnalité va-t-elle améliorer les choses ? Cette nouvelle façon de communiquer incitera-t-elle les clients à venir visiter le site ? Et ce nouveau tunnel de paiement, est-il vraiment plus performant que l’ancien ?

Les Tests A/B, c’est simple et objectif

Pour améliorer son processus de décision, il se renseigne et découvre une technique éprouvée sur les géants du Web : l'A/B Testing. Il lit consciencieusement la définition de Wikipedia et comprend immédiatement le principe, qui repose sur trois étapes :
  1. D’une part, il devra livrer les deux versions de sa fonctionnalité, diriger certains utilisateurs sur l’une, appelée version A et les autres sur l’autre, appelée version B ;
  2. d’autre part, il devra être capable de collecter des données sur l’expérience des utilisateurs sur les différentes versions. Pour Matthieu, cela implique d’adapter son plan de marquage analytique pour être capable de différencier les mesures issues des deux versions ;
  3. enfin, ce sera l’analyse de ces chiffres qui permettra à Matthieu de faire ressortir une vérité statistique concernant ces versions, déterminant ainsi la plus performante au regard des critères qu’il aura défini.

Confiant, Matthieu s’enquiert de quelques exemples pour convaincre sa Direction. Il découvre par exemple l’histoire incroyable mais vraie de Marissa Mayer (alors salariée de Google) qui demanda à ses équipes de déployer sur un site 41 variations de bleu pour déterminer la plus performante auprès des utilisateurs.

Si Google le fait, Matthieu devrait pouvoir le faire aussi. Et ça a même l’air facile.

Les Tests A/B, c’est compliqué et subjectif

Matthieu réfléchit à l’implémentation concrète. Sa première contrainte est sa capacité à mettre en place les deux versions en simultané. C’est une contrainte forte pour Matthieu, qui réalise alors que de nombreux tests A/B lui seront impossibles : l’infrastructure de son entreprise est limitée, et il ne peut pas demander de nouveaux serveurs et passerelles pour étendre le schéma d’architecture à volonté.

Qu’à cela ne tienne, il décide de franchir le pas malgré tout et demande à son équipe de développement de le suivre sur un premier essai. Il choisit spécifiquement une modification qui ne nécessite pas de changement d’infrastructure : un variante visuelle au sein d’une page.

Un prototype visuel d'une page produit d'un site e-commerce

Maquette de la fiche produit : la zone jaune incluera soit un visuel du produit (version A), soit une vidéo (version B)

Il hésite, puis décide finalement de tester l’affichage de l’image produit sur le gabarit « Fiche Produit » du site e-commerce. La version courante, avec l’image produit à gauche de sa description, sera considérée comme la version de contrôle, la version A. Sur la version B, c’est une vidéo du produit qui sera affichée. Depuis le temps que le département Marketing dit qu’il faut mettre davantage de vidéo, il est temps de le vérifier !

Se pose alors un problème analytique : comment mesurer l’efficacité d’une version par rapport à l’autre ? Il existe de nombreux indicateurs, servant à représenter la réalité de l’expérience utilisateur : achats, abandons, mesures de temps, mesures du nombre de rebonds… Après mûre réflexion, l’équipe fait un choix : celui d’utiliser l’action d’ajout-panier comme critère de succès. Plus un produit sera ajouté au panier, meilleure sera jugée la version.

Se pose ensuite un problème technique car par souci de cohérence, Matthieu souhaite qu’un utilisateur ayant basculé vers une version reste sur cette version pendant toute la durée du test : hors de question d’avoir tantôt un visuel, tantôt une vidéo, au hasard ! L’équipe met donc en place un cookie qui stocke la version choisie pour un visiteur au moment où elle est choisie. Le système teste ainsi pour chaque visiteur l’existence du cookie et s’il existe, lit à l’intérieur la valeur à lui afficher.

Reste à choisir la version qui sera affichée à la première visite d’un client. De nouveau, une décision doit être prise pour savoir comment seront traités les utilisateurs : quelle quantité de visiteurs verra la version B, sur quels critères seront-ils choisis et sur quel périmètre du site le test aura-t-il lieu : toutes les fiches produit ou seulement certaines ? Pour ne pas influencer les résultats, la technique du test A/B impose de trouver un critère parfaitement indépendant, mais ce n’est pas évident !

Matthieu et son équipe décident de s’en remettre à un tirage au sort, qui délivrera la version de contrôle à 99 % des utilisateurs et la version B à 1 % seulement, sur tout le site. Ainsi, si la version B ne réalise pas ses promesses, cela ne sera que peu préjudiciable à l’activité.

Matthieu se rend compte que sous couvert d’objectivité, l’équipe a déjà fait de nombreux choix très subjectifs :

  • la nature du test lui-même ;
  • la façon de mesurer la réussite d’une version par rapport à une autre ;
  • la façon dont les populations de visiteurs sont triées et la répartition relative de ces populations.

Pas si simple, les Tests A/B, finalement. Mais bon, maintenant, c’est fait !

Les Tests A/B, ça commence quand ça finit

Matthieu décide de mener un test sur plusieurs jours et voici les chiffres qu’il récolte :

Version Nombre de visiteurs Nombre d’ajouts au panier Ratio Ajouts Panier / Visiteurs
Version de contrôle (A) 34 217 6234 18,21 %
Version avec vidéo (B) 327 68 20,79 %

Au premier coup d’œil au ratio entre nombre d’ajouts au panier et nombre de visiteurs, il semble clair que la version B est plus efficace que la version A. Malheureusement, le trafic n’a pas été à la hauteur de ce qui était attendu et l’échantillon est très faible. Difficile de dire alors si l’échantillon de mesures est suffisant pour permettre une généralisation des résultats…

De plus, un des membres de l’équipe de Matthieu lui apporte une information nouvelle : suite à une erreur dans la gestion du tirage au sort, les visiteurs démarrant leur navigation dans le rayon « High Tech » ont eu davantage de tirages B que les autres. Or, le rayon « High Tech » est un des rayons dont la transformation est la meilleure. La différence de presque 3 points observée n’a peut-être donc rien à voir avec la modification apportée sur le visuel produit. Matthieu et son équipe sont dubitatifs.

Enfin, durant les quelques jours pendant lesquels le test a été effectué, le taux de conversion global du site a chuté. N’ayant pas fait suivre l’information A/B dans ses indicateurs jusqu’au paiement (seul l’ajout-panier stockait la différence), Matthieu a du mal à savoir si la version B y est pour quelque chose… Et si les gens ajoutaient davantage au panier, pour finalement partir sans avoir acheté ? C’est un risque que l’équipe ne peut pas prendre à la légère.

Tout cela enseigne beaucoup à Matthieu… sur la façon de faire des tests A/B. Mais sur le visuel produit, aucune conclusion n’est possible : il va falloir réitérer l’expérience en la contrôlant mieux.

Les Tests A/B, quand les autres s’en mêlent

Finalement, Matthieu et son équipe reproduisent le test avec de meilleures mesures et un volume significatif, ce qui leur permet de bien isoler les résultats. Contrairement à ce qu’ils avaient pensé, la version B est moins performante, aussi le site est-il à nouveau basculé à 100 % sur sur la version avec visuel produit. Même si Matthieu est frustré de ne pas comprendre les raisons du résultat, lui qui pensait que la vidéo ne pourrait être que plus attrayante, il est tout de même satisfait de l’avoir obtenu et sa Direction l’en félicite.

Fiers de ce succès, l’équipe de Matthieu se voit confier de plus en plus de demandes de tests, en provenance notamment des équipes Marketing qui y trouvent un moyen formidable de mesurer l’activité des visiteurs. Mais de nombreux problèmes techniques se posent, car certains tests, simples sur le papier, obligent notamment à maintenir plusieurs architectures logicielles incompatibles entre elles. Matthieu et son équipe sont obligés de mettre ces tests en attente, le temps de ré-écrire une partie du code pour pouvoir y injecter des dépendances. Et d’autres demandes, elles aussi mises en attente pour un délai indéterminé, nécessitent de modifier l’infrastructure technique. Beaucoup de dépenses qui n’étaient pas au budget…

Heureusement, certains tests continuent à être possibles. L’équipe Marketing demande notamment un Split testing sur la Home sur site Corporate. Cela signifie que seront testées des versions complètement différentes de la page. Pourquoi pas, se dit Matthieu…

Un panneau indicateur pour la Rue d'Enfer

"Rue d’Enfer" par Frédéric Bisson - CC BY 2.0

Malheureusement, cette demande s’ajoute aux autres, plus nombreuses, et certaines concernent des pages similaires. Les utilisateurs pourraient ainsi subir sans le savoir plusieurs tests A/B au sein d’une même page. Sur la fiche produit, par exemple :

  • un test A/B jouerait sur la police d’écriture du nom du produit ;
  • un test A/B jouerait sur le texte du call-to-action d’ajout-panier ;
  • un dernier test conditionnerait l’affichage d’informations en temps réel sur le produit consulté

Techniquement possibles (en étendant les concepts déjà mis en place pour un seul test), cette analyse multivariée pose néanmoins le problème de la complexification de l’analyse statistique, déjà délicate. Car avec tout ça, le nombre de versions du site augmente excessivement vite.

Matthieu se retrouve à gérer :

  • un Split Test A/B/C sur la page d’accueil,
  • trois tests A/B sur la fiche produit;
  • un test A/B impliquant une variation de la structure de navigation…

… soit 18 combinaisons possibles pour chaque visiteur et une augmentation considérable des coûts de maintenance (car désormais, pour reproduire un bug, il faut se mettre dans la même configuration que le navigateur client sur lequel il s’est produit). Coûts auxquels s’ajoute la problématique du suivi, car le dernier test a pour conséquence directe de fausser les mesures analytiques existantes, qui jusqu’à présent se basaient sur les URLs.

Les Tests A/B, s’outiller

En se renseignant, Matthieu découvre différente entreprises proposant des produits permettant de rationaliser les tests A/B. La plupart internalisent notamment deux des principaux problèmes : l’analyse statistique et la gestion des campagnes. Parfois, les campagnes sont même automatisées pour s’arrêter à l’obtention d’un résultat significatif.

Malheureusement, il est très difficile de déterminer l’intérêt d’une solution plutôt qu’une autre, car chacune semble adaptée à un type de besoin :

  • Pour les équipes commerciales, certaines solutions se superposent au Front-End pour modifier à la volée la page visualisée par le client. Si le concept est séduisant, il peut parfois aboutir à des lenteurs ressenties par l’utilisateur, des "flashs" de la page et même des situations de SPOF ( Single Point of Failure : situation dans laquelle le site repose fortement sur une ou plusieurs ressources externes. Si ces ressources ne sont pas disponibles ou qu’un problème technique rend impossible leur acheminent jusqu’au client &#8211; problème réseau, passerelles capricieuses &#8211; alors la page n’est plus consultable) dans les cas les plus extrêmes ;
  • d’autres solutions plus orientées "injection" permettent de réaliser simplement des bascules entre plusieurs architectures logicielles ;
  • enfin, d’autres solutions permettent de basculer rapidement vers une architecture plutôt qu’une autre, mais introduisent des passerelles supplémentaires dans le système, entraînant à la fois des risque et des baisses de performance.

Matthieu sait donc qu’il devra passer par une phase de veille et de sélection de la meilleure offre au regard de ses propres problématiques. Mais plus que ça, il commence également à ressentir que…

Les Tests A/B ont beaucoup de limites

La première d’entre elles concerne la fonction d’adaptation. En effet, tout chantier d’optimisation consiste à approcher la meilleure des solutions en comparant plusieurs variations. Ceci étant, cela ne veut pas dire qu’il s’agit de la meilleure variation dans l’absolu. Ce n’est pas parce qu’on aboutit à un optimum local (autour de la situation d’origine) qu’il n’existe pas une variante très éloignée produisant de meilleurs résultats.

A 3D representation of a local maximum

Sometimes, optimization is an illusion. The real objective is higher.

Imaginons, par exemple, que nous procédions à une analyse multivariée composée de deux tests ayant chacun une quinzaine de variations (le cas est extrême, mais il sert la démonstration). Jouer sur les variations des deux tests consiste alors à se déplacer sur le plan jaune du graphe ci-joint, à la recherche d’un maximum de performance. Rien ne nous permettrait, une fois arrivés en haut du sommet jaune, de savoir qu’il en existe un plus grand sommet ailleurs et que nous l’aurions trouvé en poursuivant nos tests sur un plus grand nombre de variations.

Ensuite, le Test A/B ne dira jamais que ce qu’on lui demande de dire. Dans l’exemple de Matthieu sur le visuel ou la vidéo produit, le test a répondu que le visuel était la meilleure solution, mais il est incapable d’expliquer qu’il s’agit probablement de la conséquence de deux facteurs : d’une part l’habitude des utilisateurs à visualiser des vidéos en paysage plutôt qu’en portrait et d’autre part, leur incapacité à ne pas se disperser face à un média interactif. Promouvoir les tests A/B est donc une bonne chose… à condition de faire appel à des professionnels pour savoir en comprendre les résultats !

Ajoutons à cela plusieurs autres limites évidentes :

  • l’A/B Testing ne connait pas vos visiteurs. Il ne sait pas s’ils sont vieux, jeunes, technophiles, fidèles… or, ces populations peuvent avoir des comportements et des processus de décision complètement différents et vous n’en aurez qu’une vision globale. À vous de compléter votre A/B Testing par un outil analytique de qualité, ou un tracker, qui vous permettra de bien segmenter les retours de ces typologies de visiteurs ;
  • l’abus d’analyses multivariées entraîne un besoin croissant en nombre de visites : il n’est donc pas possible de "tout tester" en espérant trouver la bonne recette, d’autant que le taux de conversion est probablement une équation plus complexe que la simple addition de l’ensemble des cas de figure ;
  • l’A/B Testing est un outil court-termiste qui ne prend pas en compte la courbe d’apprentissage de vos visiteurs. Sa pertinence n’est donc pas la même pour un vendeur de masse et une entreprise dont les produits sont élaborés et le processus de vente très réfléchi
Une jeune femme pensive

"Thinking" par Moyan Brenn - CC BY 2.0

Les Tests A/B, au final

Interrogé par sa Direction, Matthieu présente l’intégralité de son expérience sur les tests A/B. Envisagé comme un outil magique d’aide à la décision, l’A/B Testing est en réalité plus complexe et coûteux qu’imaginé.

En réalité, comme tous les outils, l’A/B Testing nécessite d’être manipulé par des experts ayant la meilleure connaissance possible du contexte. Enfin, jusqu’à ce qu’un test A/B prouve le contraire !

3 secondes & des WebFonts

Les WebFonts, mal utilisées, sont souvent un fléau pour la performance Web. Chromium (donc Chrome) devrait changer la donne suite à la correction 171823002. Dorénavant, le texte d’une page sera rendu 3 secondes après le load start, même si les WebFonts ne sont pas chargées. C’était déjà le comportement appliqué sur Firefox et c’est un nouveau pas en avant dans la lutte constante pour une meilleure performance Web.

Note : cet article a d’abord été publié sur le blog de Clever Age.

En dehors de cette problématique de WebFont (déjà abordée chez nous), c’est surtout l’inclusion d’objectifs de performance au sein même du navigateur qui me fait plaisir. C’est dommage d’en arriver là mais avec un Web qui devient de plus en plus lourd (et de plus en plus lent [EN]) d’année en année, il est temps que la tendance s’inverse !

Brown Bag Lunch, faisons connaissance

Je rejoins une nouvelle initiative, celle des Brown Bag Lunches.

Le concept est simple : mettre en relation entreprises et experts autour d’un déjeuner.

Je trouve la démarche extrêmement positive. Pour beaucoup d’entreprises, une démarche de formation est coûteuse et la mise en place d’une veille technologique est difficile. Pour beaucoup de sociétés de conseil, proposer ce genre d’exercice engendre beaucoup de tâches administratives pour un retour sur investissement très faible.

Le système d’échange autour d’un sandwich permet aux acteurs de se rencontrer et de tisser des relations qui vont au-delà du contractuel. Il permet à un consultant de rôder une présentation (j’ai toujours mes collègues de Clever Age pour ça, mais ce n’est pas le cas de tout le monde) et peut donner à des salariés dans l’entreprise hôte un nouveau dynamisme professionnel.

Je trouve l’initiative véritablement sympathique et répondant à un manque, donc je ne passerai pas à côté. J’ai décidé d’y proposer un certain nombre de présentations déjà données auprès d’étudiants, de collègues ou lors de conférences. Les thématiques sont la Performance Web, JavaScript et le Service Design (et Lean).

Rappels JavaScript : JS FTW !

J’ai animé il y a quelques jours une présentation chez Clever Age autour de JavaScript.

L’idée assumée était d’enfoncer des portes ouvertes mais comme toujours dans ces cas-là, la présentation a permis de lever d’intéressantes questions ou de lever le voile que certains n’avaient pas eu le temps d’effleurer sur des syntaxes qu’ils croisaient parfois. Bref, c’était une super expérience et si vous voulez la vivre aussi, n’hésiter pas à :

Big Data

Quand on a une base de 36 millions de contacts, évidemment, on est premiers sur les datas : on est premiers sur le traitement, premiers sur l’enrichissement, premiers pour la mise à jour des fichiers et nous disposons également d’une base d’adresses qui est incomparable, qu’il s’agisse d’adresses physiques, de SMS ou d’emails.

Google dirait cela, nous serions interloqués. La NSA le dirait, nous serions choqués. Tout va bien, il ne s’agit que d’Adèle Albano, directice générale adjointe du Courrier à La Poste.

D’après Gartner, 64 % des organisations dans le monde ont investi dans le Big Data ou ont prévu de le faire. Quand on voit la façon dont la CNIL échoue sur ses dossiers les plus critiques, il y a de quoi s’inquiéter sur sa capacité à protéger les citoyens d’abus concernant ces données (dont je n’accuse pas du tout La Poste, qui fait sûrement très bien son travail de protection).

Konami Code Bookmarklet

Je me suis amusé à écrire un petit bookmarklet qui simule le Konami Code, afin de ne pas avoir à le taper manuellement (les développeurs sont des fainénants, vous ne le saviez pas ?). Si cela vous intéresse, cliquez-glissez ce lien dans votre barre de favoris et testez-le, au hasard, sur la carte de vœux 2014 de Clever-Age !

Le code est consultable sur Gist : Konami code IIFE.

Je l’ai testé sur Windows 8.1 avec Firefox 26.0, Chrome 32.0.1700.76 et IE 11.0.

Travail

L’hypothèse la plus sombre que je puisse faire pour 2014 est que dans une société de loisirs forcés, le mot travail sera le plus valorisé du vocabulaire

Isaac Asimov, 1964

Scripts tiers : on ne lâche rien !

Les scripts tiers que nous incluons dans nos sites nous en font perdre le contrôle. Même s’ils nous font gagner du temps ou nous procurent des fonctionnalités difficiles à substituer par un développement interne, il est très difficile d’en maîtriser les impacts en terme de performance, de sécurité, de conformité aux politiques de développement interne, de maintenance… Chaque inclusion est donc la conséquence d’une analyse du « pour » et du « contre »… à condition de savoir mesurer le « contre ».

JS Manners est un formulaire qui permet de noter les scripts tiers, de manière à savoir où on met les pieds. Rien d’extrêmement innovant dans ce procédé que beaucoup d’entre nous pratiquions isolément, mais un vrai travail de rationalisation de la part d’Andrew Betts, son auteur, qu’on ne peut que féliciter.

Note : cet article a d’abord été publié sur le blog de Clever Age.

GitHub, l’Open-Source qui conquiert le monde

Difficile pour un développeur, en 2013, de ne pas savoir se servir de GitHub. Bien que jeune, la plate-forme d’hébergement de projets logiciels est probablement aujourd’hui le plus gros dépôt collaboratif du monde avec plus de trois millions d’utilisateurs et six millions de dépôts.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Ce qui avait commencé, en octobre 2007, comme un projet personnel, sans intention commerciale, est devenu aujourd’hui un pilier central de la collaboration logicielle et permet, chaque jour, à des milliers de développeurs de travailler ensemble à travers le monde.

Une carte naïve du monde, avec des zones accentuées

Projet de visualisation des données de la Timeline publique de GitHub, par David Fischer.

Si vous ou votre organisation ne partagez pas de code sur GitHub, vous devriez. Et bientôt, les entreprises de production de logiciels ne seront plus seules…

GitHub, de l’outil pour développeurs à la collaboration productive

GitHub est né de la volonté commune de Tom Preston-Werner et Chris Wanstrath de résoudre la problématique de la collaboration décentralisée dans le cadre du développement. Un premier pas technique avait déjà été réalisé avec Git, un système de gestion de code source développé par Linus Torvalds, le créateur de Linux. Git est un très bon outil de collaboration décentralisée, mais il ne suffit pas à couvrir le périmètre fonctionnel de la collaboration sur un projet. Il manquait à Git une plate-forme, GitHub est venu combler ce manque.

Il est désormais possible, pour n’importe quel développeur de créer un dépôt, d’y héberger un projet, de le documenter sous la forme d’un site Web GitHub.io et de le proposer à la Communauté. Il peut lui-même s’approprier d’autres projets, y corriger des erreurs ou y apporter son savoir-faire puis proposer ses corrections au créateur du projet d’origine… ou non. GitHub permet et facilite ces interactions, tout en proposant les fonctionnalités d’un réseau social, comme la possibilité de personnaliser son profil ou celle de s’inscrire à l’activité d’un autre utilisateur.

Un dessin représentant une chimère chat/poulpe, déguisée en développeur

« The CoderCat », un des très nombreux détournements de la mascotte de GitHub, l’Octocat, par Cameron McEfee.

Reposant sur sa simplicité d’usage, tout en offrant une qualité de service et un contrôle des données de premier ordre, la plate-forme a connu un succès fulgurant. Arrivé au million d’utilisateurs en trois ans environ, GitHub en héberge désormais plus de trois millions et met moins de cinq mois à acquérir chaque million d’utilisateurs supplémentaire.

Comment l’expliquer ? La force de GitHub a été de proposer une plate-forme centralisée pour ces tâches qui, par définition, se produisent de pair à pair (en se basant sur Git) tout en offrant une interface sympathique (là où SourceForge est un peu poussiéreux) et des fonctionnalités qui complétaient l’offre classique (comme Gist, ou GitHub.io). Et tout cela en présentant des conditions d’utilisation très claires qui laissent la totale propriété du contenu produit à leurs auteurs, comme l’indiquent les Terms Of Service :

We claim no intellectual property rights over the material you provide to the Service. Your profile and materials uploaded remain yours. However, by setting your pages to be viewed publicly, you agree to allow others to view your Content. By setting your repositories to be viewed publicly, you agree to allow others to view and fork your repositories.

A cela s’ajoute qu’il est plus motivant de travailler à plusieurs que seul : les dépôts des comptes gratuits étant publics, ils sont autant d’invitation à venir lire la production de camarades ou de collègues et leur proposer des évolutions. Autre conséquence : une grande majorité des statistiques des personnes, des organismes ou des entreprises présentes sur GitHub sont publiques, permettant à GitHub de devenir un vrai CV d’aptitude auprès des communautés concernées.

Mais si GitHub remporte autant de succès, c’est aussi qu’il intervient au bon moment : ce second âge d’or de l’Open Source. Ces dernières années ont vu à la fois naître des projets de qualité qui sont toujours en cours de développement (Android, Hadoop, MongoDb, …) mais aussi une grande évolution des mentalités face à l’Open Source, notamment en entreprise où l’on remarque une disparition progressive, sinon totale, de l’opposition des plus traditionnels. Certains employeurs encouragent même leurs salariés à contribuer sur des projets, quand ce ne sont pas des villes (comme Chicago), de grandes institutions du savoir comme la NASA ou même des gouvernements (comme le Royaume-Uni ou les États-Unis).

Un dessin représentant une chimère chat/poulpe, pasticheant la campagne &laquo; Yes We Can &raquo; de Barack Obama

« The Baraktocat », par Cameron McEfee

L’inverse se produit également : des entreprises, comme OVH, refusent que leurs salariés participent à des projets sur GitHub. Pourquoi ? Tout simplement parce qu’elles reconnaissent la capacité de GitHub à valoriser un profil et craignent la fuite des cerveaux. Une opposition en forme de succès pour la plate-forme.

Un business-model éprouvé

Pourtant, il est évident que GitHub ne s’adresse pas qu’aux particuliers. Ces derniers représentent la grande majorité des comptes et peuvent utiliser les fonctionnalités collaboratives de la plate-forme gratuitement s’ils le souhaitent. Mais s’ils le préfèrent, ils peuvent souscrire un abonnement leur permettant de développer à l’abri, sur des dépôts privés, des portions de code propriétaire par exemple. Mais le cœur du Business Model de GitHub repose sur les entreprises.

Celles qui souhaitent gérer de multiples dépôts, avoir un seul tableau de bord ou ajouter des collaborateurs en lecture souscrivent un forfait « Organization ». Mais ce forfait ne satisfera pas les plus grands acteurs pour qui il est impossible de partager leur code sur une plate-forme externe pour des problèmes de gouvernance ou de sécurité… Ces entreprises souscrivent donc un abonnement leur permettant d’héberger en interne une instance de la plate-forme, à la manière de Google Search Appliance pour la recherche, contre ce qui pourrait ressembler à plusieurs millions de dollars par an (les chiffres ne sont pas publics). Microsoft, VMWare, Walmart ont déjà été séduits.

GitHub, ou l’Open Source appliqué au monde

La problématique de la production distribuée d’un contenu au sein d’un projet n’est pas liée purement au monde du développement logiciel. Dans d’autres domaines, la production puis la mise en commun de contenus écrits à plusieurs mains relèvent du défi, car la culture et l’outillage Open Source n’existe pas. Et si une plate-forme comme GitHub pouvait solutionner ce problème ?

Certains, comme Loren, ont déjà essayé d’imaginer l’utilisation de GitHub pour l’écriture :

  • L’auteur principal créé la structure basique d’un document et quelques éléments de base (sur la branche par défaut);
  • Chaque collaborateur voulant contribuer peut démarrer en un clic la contribution sans se préoccuper de gêner les autres contributeurs (en réalisant un fork);
  • Une fois cette contribution terminée, son auteur propose à l’auteur original de valider sa contribution (via un pull request);
  • Si la contribution est validée, elle peut rejoindre le document. Sinon, les raisons du refus sont notifiées à son auteur, de manière à ce qu’il puisse réaliser les corrections nécessaires avant une nouvelle contribution.

Ce processus, classique, est entièrement supporté par la plate-forme, mais elle n’est pas forcément adaptée en termes de design. L’idée a cependant servi de support à la création de Penflip… et à d’autres initiatives, plus orientées vers le design visuel ou industriel, la musique. C’est par exemple le cas de Splice, qui devrait ouvrir ses portes prochainement. Y retrouvera-t-on les grands de l’Electro française (et mondiale) ?

Un dessin représentant une chimère chat/poulpe, déguisée en un des Daft Punk

« The Daftpunktocat (Thomas) », par James Kang

Quelques liens, pour en savoir plus

Nos données personnelles, enjeu d’avenir

J’écrivais l’année dernière, pour le Train de 13h37 :

La diminution de votre performance et les risques qui pèsent sur la disponibilité de votre site sont des inconvénients fâcheux mais techniques. Plus inquiétante encore est l’intrusion dans votre site d’étrangers qui n’ont qu’un intérêt : collecter des données sur vous ou vos visiteurs. Vous n’avez pas connaissance de ces ressources chargées lors d’appels issus de script tiers. Pourtant, elles peuvent voir et capturer des informations sur vos visiteurs sans votre consentement. Et la variété des informations qu’elles peuvent collecter est impressionnante. […] C’est un no man’s land sur lequel l’absence de contrôle laisse libre champ à des comportements dignes du Far West.

Aujourd’hui, les données personnelles sont un tel enjeu commercial qu’elles sont au cœur d’une bataille qui se déroule silencieusement, entre les murs du Parlement Européen à Bruxelles. D’après un officiel américain, elles pourraient même être au centre de la future guerre commerciale qui opposera l’Europe aux États-Unis.

C’était inévitable, cela doit avoir lieu, mais je ne peux pas m’empêcher d’être inquiet quant à l’issue de ce débat. Brace yourselves.

Réformer l’Education ?
parce que bon, là, on rate un truc…

Je suis sorti du lycée en sachant me servir d’un compas et d’une équerre, mais sans savoir comment calculer les intérêts actualisés d’un prêt.

Je suis sorti du lycée en connaissant les détails de la composition d’un chapiteau de colonne grecque, mais je n’avais pas la moindre idée des composants standards d’un moteur.

Je suis sorti du lycée en connaissant mieux le nom des généraux de la Première Guerre mondiale que le fonctionnement des institutions de mon pays et sans savoir lire un contrat ou une fiche de paie.

J’ai eu des cours d’anglais pendant sept ans sans être véritablement capable, à terme, de parler anglais. J’ai fait du sport, mais on ne m’a jamais vraiment appris à prendre soin de mon corps, ne serait-ce qu’à le nourrir correctement. J’ai appris à détecter des allitérations mais aujourd’hui je me contente de corriger les fautes d’orthographe et de grammaire de mes collègues et amis, et parfois l’inverse.

Alors, ils peuvent réformer l’Education autant qu’ils veulent, mais il faudrait peut-être réévaluer ses objectifs, ou la compléter avec des dispositifs d’apprentissage tout au long de la vie, non ?

La performance Web, sur Mobile avant tout

Google vient de mettre à jour l’interface de PageSpeed Insights de manière à afficher encore plus dynamiquement et rapidement le respect des bonnes pratiques de Performance Web d’un site web. Si on peut être déçu que la nouvelle interface ne soit pas Responsive, on appréciera en revanche la sélection de l’onglet Mobile par défaut. De quoi encore renforcer, s’il le fallait, l’importance du mobile dans les stratégies WebPerf des entreprises.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Rester sous Windows Phone…

Je ne sais plus quoi penser de Windows Phone. J’aime beaucoup la plate-forme, autant au niveau de son architecture logicielle que de son design, mais j’ai du mal à voir son avenir.

Quelques raisons pour lesquelles je m’inquiète :

  • Les PDM augmentent vite (de l’ordre de +75 % cette année encore), mais partent de loin, tant et si bien que Windows Phone représente encore, plusieurs années après sa sortie, une part négligeable du marché.
  • Si négligeable que le développement d’application, aussi sympathique soit-il, y est délaissé au profit d’Apple et Android. Le marché applicatif WP7 est un no-man’s land et le marché WP8 fait à peine mieux.
  • Le rachat de la branche mobile de Nokia par Microsoft me laisse perplexe. J’hésite entre voir le verre à moitié plein (en y voyant l’union de deux compagnies d’excellence pouvant s’apporter énormément) ou à moitié vide (Nokia et Microsoft ont tous deux raté le marché du smartphone fin 2007 – alors même que Microsoft y était en position dominante avant l’arrivée de l’iPhone – et ne s’y sont pas raccroché depuis ). Je crains que Windows Phone ait raté le coche. Il y avait indéniablement un coup à jouer avec Modern UI et sa transversalité entre Windows Phone et Windows pour PC, mais je pense que Microsoft a raté cette opportunité stratégique.

Windows Phone reste un excellent système, qui conviendra parfaitement à des utilisateurs en mal de différenciation face à l’omniprésence du couple Apple/Android, mais il ne convient plus parfaitement à l’utilisateur que je suis (le tournant « photo » de Nokia me laissant de marbre). Sauf grosse annonce dans les mois qui viennent, mon prochain téléphone ne sera pas un Windows Phone.

L’e-commerce, toujours plus lent

StrangeLoop (faisant désormais partie de Radware) vient de publier son rapport annuel sur la performance Web des sites e-commerces. Se basant sur le classement Alexa, ils ont moyenné les performances de plus de 500 vendeurs. Et comme l’année dernière, les résultats sont décevants.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Les temps de chargement e-commerce sont de plus en plus lents, avec encore cette année une perte de 13,7 % sur le Load Time des nouveaux visiteurs (qui atteint 7,72s en moyenne). Même si cette mesure n’est pas suffisante à elle seule (lire ici pourquoi), cette détérioration est inquiétante. Si on complète cette mesure en analysant le temps avant interaction, c’est bien mieux (de l’ordre de 5s), mais nous sommes encore loin d’un idéal (situé pour certains à 3s, mais qui peut atteindre 1s si la cible est mobile), et il y a fort à parier que de nombreuses personnes quittent ces sites avant d’avoir pu interagir avec leurs contenus.

Rien d’étonnant cependant, puisque même les bonnes pratiques les plus élémentaires ne sont pas respectées. Les ressources chargées sont trop nombreuses (91 en moyenne) et insuffisamment optimisées. Consolidation, minification, compression, retaillage… sont autant d’actions simples mais cruciales qu’il faut mettre en place.

Ce rapport me désole autant qu’il me passionne : nous avons encore beaucoup à faire pour améliorer l’expérience utilisateur !

Livre blanc de Radware sur les performances Web des sites e-commerce

Chrome DevTools ne se repose pas sur ses lauriers

Alors qu’ils sont déjà reconnus comme étant d’excellente facture, voire même un cran au-dessus de la concurrence, les outils pour développeurs de Chrome ont encore bénéficié d’une exceptionnelle amélioration dans Chrome 28, disponible sur la branche stable.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Au menu, quatre innovations majeures :

  • Workspaces, qui permet d’utiliser DevTools comme éditeur de code, en définissant une relation en dur entre un dossier local et un dossier web
  • La possibilité d’éditer Sass en temps-réel, avec compilation des modifications à la volée
  • L’extension ADP qui simplifie le débogage à distance des applications Android (en embarquant le Debug Bridge, notamment)
  • Une amélioration des outils de mesure de la Performance Web comme Flame Chart (visualisation du traitement JavaScript), la possibilité de visualiser le rendu en temps-réel ou en simulant un repaint en continu, un compteur de FPS, un profiler Canvas…

Les documentations de ces outils sont encore balbutiantes, quand elles ne sont pas absentes, de la documentation officielle. Mais vous pouvez regarder cette vidéo de Paul Irish qui présente ces nouvelles fonctionnalités ou vous référer à l’excellente présentation d’HTML5 Rocks.

F12 de IE11 : du nouveau pour les développeurs

Cela fait un petit moment que je n’avais pas vu de challenger sérieux aux Dev. Tools de Chrome (de nombreuses études montrent que Firebug pénalise le Firefox sur lequel il est installé, faussant ainsi les mesures réalisées au niveau WebPerf, par exemple).

Une fois n’est pas coutume, c’est Microsoft qui s’apprête à donner un coup dans la fourmilière avec le F12 de IE11.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Outre les classiques onglets explorateurs de DOM, Console, Debugger, Réseau, il proposera également un onglet dédié aux temps de réponse de l’interface (UI Responsiveness), un outil de diagnostic de la mémoire (idéal pour détecter les fuites) et un émulateur (mode document, affichage, et géolocalisation).

Capture d'écran de l'onglet 'UI Responsiveness' des outils de développement d'Internet Explorer 11

Le panel d’analyse de la réactivité de l’interface sera d’une aide précieuse dans l’évaluation des optimisations à réaliser pour améliorer la performance ressentie.

Un effort manifeste a été fait sur le design, ce n’est pas négligeable quand vous passez plusieurs heures par jour sur ces écrans. Il n’y a plus qu’à attendre la mise à jour de Windows 8 vers 8.1 pour profiter de tout cela !

Conseils pour l’installation d’un projet Sf2 sous Windows 8 (WAMP)

Sous le pression de William, je me mets à Symfony. J’y retrouve toutes les grandes tendances de ce que je connais déjà en ASP.NET MVC, et découvre par la même occasion les outils Sf2 qui offrent aux développeurs PHP ce qui est disponible depuis longtemps dans le monde .NET. Utilisateur convaincu de Windows, j’ai pris quelques minutes pour m’installer mon environnement… et quelques heures pour comprendre certaines erreurs idiotes, donc autant que ça profite à d’autres.

Voici les points de vigilance :

  1. L’installateur WAMP n’ajoute pas le chemin vers l’utilitaire PHP au PATH. À vous de le faire à la main pour pouvoir utiliser la commande PHP.
  2. L’installateur WAMP n’installe pas l’extension PHP APC, mais vous pouvez la trouver ici et l’installer vous même dans le réperoire ext de votre dossier d’installation PHP (dans c:wampbinphp)
  3. Vous pouvez activer les extensions PHP apc et openssl, ça ne fera pas de mal
  4. Pensez à modifier aussi le php.ini situé dans votre dossier d’exécutable PHP c:\\wamp\\bin\\php, sinon vous n’aurez pas SSL dans la ligne de commande, par exemple
  5. Enfin, attention aux chemins de votre composer.json. En effet, un « bin/toto » ne produira pas d’erreur sur Linux, mais devra être remplacer par un « bin\toto » sous Windows sous peine d’avoir un bien joli message d’erreur expliquant que « bin » n’est pas une commande reconnue Enfin, si vous avez un problème avec la fonction symlink(), vérifier votre version de PHP.

En effet, de nombreux forums répondront tout simplement : « t’es sous Windows, il n’y a pas de liens symboliques », ce qui est faux depuis Windows Vista (qui introduit le lien symbolique dans NTFS) et ne faisait pas avancer mon problème. D’autres parlaient de faire tourner l’exécutable PHP en mode de compatibilité XP. Cela ne fonctionnait pas davantage et pour cause, en réalité, c’est PHP 5.3.0 qui régresse sur cette fonction, et un bug est d’ailleurs saisi.

J’ai donc mis à jour PHP en version 5.4.16 et le problème s’est résolu de lui-même. Windows n’avait rien à se reprocher ;)

Il faut repenser Windows

Windows 8 se vend mal. Même si une centaine de millions de licences se sont écoulées depuis la sortie de l’OS, toutes ne sont pas activées et Windows 8 ne représente que 3 à 5 % du parc PC. Il y a des choses à changer dans Windows. Et vite.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Un peu d’histoire

Pour bien comprendre le problème, il faut remonter dans le temps et observer la façon dont les usages changent, notamment la manière dont le grand public « consomme » un Personnal Computer. Depuis l’arrivée d’Internet, les usages sur PCs n’ont pas énormément changé. Microsoft a sorti de nouvelles versions de Windows qui se suivaient et se ressemblaient, en ajoutant de nouvelles fonctionnalités bienvenue mais dont l’innovation était marginale du point de vue des usages.

L’interface graphique fenêtrée : depuis la naissance de Windows, la GUI n’a pas énormément évolué

L’interface graphique fenêtrée : depuis la naissance de Windows, la GUI n’a pas énormément évolué

Pendant ce temps, c’est un autre appareil, le téléphone, qui est entré en mutation. L’iPhone a lancé un mouvement, rompu une barrière que d’autres marques qu’Apple se sont empressées de passer à leur tour et nous avons vu fleurir les téléphones intelligents, c’est-à-dire embarquant ces fameuses fonctionnalités autrefois réservées aux PC ou aux assistants personnels.

Ces nouveaux usages ont profondément changé la façon dont nous percevons notre monde applicatif. Sur PC, nous lancions une application complexe pour réaliser des tâches complexes. Sur Smartphone, nous utilisons des applications simples, inter-connectées, pour réaliser des tâches simples qui forment, les unes associées aux autres, des motifs complexes. Et nous avons transféré ce désir sur nos PC et nos tablettes. Nous ne sommes plus forcément à la recherche de l’application qui fait tout, mais l’application qui fait simple, mieux et plus vite. Et cela ne nous dérange pas de collectionner les applications. Nous aimons cela, nous en parlons et pour autant qu’on nous aide, qu’on nous guide en nous offrant une place de marché, nous sommes prêts à payer ces petites briques applicatives bien davantage que ce que nous dépensions avant dans des logiciels et sans piratage.

Microsoft n’avait aucune proposition de faite sur ce terrain.

Innover sans détruire

Ce que Microsoft avait, c’est un système d’exploitation à la couverture planétaire, permettant d’exécuter des millions de logiciels dans toutes les langues du monde. Il n’était « juste » pas adapté aux usages en question. Il y avait bien eu des tentatives liées à la mobilité, très innovantes d’ailleurs car Microsoft avait investi le terrain dès 1992, mais elles n’étaient plus convaincantes face au révolutionnaire iPhone.

Windows Mobile 5.0 Macallan (fin 2004) : l’interface de Windows Mobile était pensée pour la productivité bureautique et rien d’autre

Windows Mobile 5.0 Macallan (fin 2004) : l’interface de Windows Mobile était pensée pour la productivité bureautique et rien d’autre

Windows 8 (et Windows Phone) est né de ce manque, de cette absence. Microsoft expliquant au monde : « nos produits n’étaient pas pensés pour la mobilité et l’utilisation fun ou occasionnelle. Nos produits n’étaient pas adaptés à la façon dont vous souhaitez utiliser vos ordinateurs aujourd’hui. Nous vous avons écoutés, nous avons compris et voilà ce que nous vous proposons : Modern UI ».

L’écran d’accueil de Windows 8 : l’écran d’accueil de Windows 8 est un bel exemple d’interface &quot;Modern UI&quot; en Flat Design

L’écran d’accueil de Windows 8 : l’écran d’accueil de Windows 8 est un bel exemple d’interface "Modern UI" en Flat Design

Une nouvelle interface, au design innovant (qui a participé à la tendance « Flat Design » qu’on voit fleurir en ce moment), avec laquelle l’utilisateur interagit d’une façon inédite sous Windows. D’un point de vue fonctionnel, une très bonne synthèse de toutes les tendances du moment. Sauf que…

… sauf que pour conserver le cœur de Windows, pour justement convaincre les millions d’utilisateurs et de développeurs Windows, Microsoft n’a pas osé tout changer et Windows 8 n’est pas que Modern UI.

Windows reste un système de bureau qui s’utilise avec une souris et un clavier et pour lequel les gros doigts des utilisateurs de tablettes n’ont aucun intérêt. Windows 8 ne déroge pas à la règle. Derrière l’interface innovante se cache un bureau qui a très peu changé depuis Windows 98, à la fois visuellement et dans les usages. Il faut dire que Windows est un système hérité, sur lequel les utilisateurs s’attendent à pouvoir conserver leurs habitudes. De la nouveauté, ils en veulent, mais tant que les logiciels Windows 98 continuent à s’exécuter.

L’interface graphique fenêtrée de Windows 8 : derrière le design Modern UI se dévoile une GUI Windows très classique

L’interface graphique fenêtrée de Windows 8 : derrière le design Modern UI se dévoile une GUI Windows très classique

Ainsi, le « problème » de Windows 8 ne vient pas nécessairement de sa nouvelle interface, il vient de la mixité forcée entre cette nouvelle ergonomie et l’ancienne. Il suffit de voir la plus grosse critique des utilisateurs de Windows envers cette nouvelle mouture : l’absence du bouton « Démarrer ». Une question que ne se posent probablement pas les utilisateurs de tablettes ou les utilisateurs « tactiles/occasionnels ». C’est bien du monde « bureau » que vient le rejet.

Et pour le prochain Windows ?

Un Rubik's Cube

Agencer les sensibilités peut-être un sacré casse-tête…

Faut-il faire table rase de ce Windows pour préparer le suivant ? Non, bien sûr, et j’irais même plus loin en disant qu’il faudrait peu de choses pour redonner de la cohérence au produit. Il est juste nécessaire de séparer les usages. D’un côté, un Windows dédié aux tablettes et 100 % Modern UI (c’est déjà le cas de Windows RT, mais avec des contraintes de développement pénibles). De l’autre, un Windows en pur « bureau », sans mixité forcée avec la nouvelle interface et qui assure la rétro-compatibilité nécessaire à de nombreux usages bureautiques.

Malheureusement, je sais également que ce que je préconise est impossible : toute division de la marque ou de la gamme nuira à l’image de marque de Windows, en plus de coûter très cher en maintenance à Microsoft. Mais imposer aux utilisateurs cette double interface ne fonctionnera pas longtemps. Nous avons tous des schémas mentaux associés aux produits que nous utilisons. Deux schémas pour un même produit, cela ne fonctionne pas.

Alors il ne reste qu’une solution. Il faut prolonger le support de Windows 8 (pour en faire une version rétro-compatible durable) et dans le futur Windows : achever le bureau, ou le réserver à une petite minorité d’utilisateurs en le désactivant par défaut.

Le risque est grand et Microsoft a beaucoup à perdre dans l’opération mais il n’y a qu’à ce prix que Redmond transformera l’essai de Modern UI et adressera vraiment les nouveaux usages de l’informatique domestique.

Presse & Google

Depuis des années, le monde de la Culture tente de se prémunir des tendances du marché et, protégé par tout un ensemble de mécaniques légales, vit dans un monde d’offre sans forcément qu’il y ait une demande équivalente. Comme cela ne fonctionne pas bien, la Culture cherche en permanence des poches d’argent à percer et la dernière en date est celle de Google que la Presse (car c’est elle qui monte à la charge cette fois) accuse de vivre sur ses contenus. Car ma petite madame, rendez-vous compte, c’est quand même honteux qu’un moteur de recherche indexe les contenus qui ont été optimisés spécifiquement pour ce moteur… Hum.

La situation est typiquement celle de l’hôtel de vacances et de l’agence de tourisme. L’hôtel est loin de ses clients, entouré d’autres hôtels équivalents, et cherche à promouvoir son offre. Il passe donc par une agence, dont le rôle est d’enrichir des catalogue d’offres à présenter à ses clients, une cible locale. L’agence agit donc en prestataire de référencement pour l’hôtel et prend une commission au passage. L’hôtelier peut négocier avec l’agence, pour que celle-ci baisse sa marge, mais pensez-vous qu’il lui viendrait à l’idée de demander à l’agence de le payer ? Il serait automatiquement sorti du catalogue, point barre. C’est ce qui va arriver à la Presse française aussi si elle s’en prend à Google, et ça me semblerait assez logique.

La meilleure position pour l’hôtelier serait de mettre lui-même en valeur son offre en faisant jouer le bouche-à-oreille, en vantant les prestations de son établissement sur d’autres canaux (print, web, buzz…), en modifiant son offre de manière à la rendre plus attirante.

La Presse aussi devrait innover, en offrant ce qui n’existe pas encore, ou très peu :

  • Des abonnements évolutifs, et à la carte (« le sport et l’international ne m’intéressent pas, donc je les retire et je paie moins cher »).
  • Une meilleures inclusions sociales et je ne parle pas de simples commentaires. Je pense plutôt à une fonctionnalité de partage « à la Tumblr » qui permettrait à chacun de re-publier des articles et de créer son propre magasine à proposer aux autres, sur des thèmes de niches.
  • Un rapport différent aux auteurs, qu’on connait aujourd’hui peu, et créer le dialogue entre l’auteur et le lecteur, notamment sur les sujets de fond.
  • Davantage d’interactivité de manière à permettre aux lecteurs d’entrer dans les rédactions et de dicter la politique éditoriale.
  • etc.

Il s’agit de modifications de fond cruciales, adaptées à la façon dont notre société consomme l’information (attention, « consommer » est un gros mot dans le monde de la Culture, utilisez-le avec parcimonie) qui seront douloureuses à mettre en place mais qui sont obligatoires si la Presse veut retrouver le contact qu’elle a perdu avec le lectorat. Et arrêter de tout résumer à : « Comment faire cracher Google ? »

Un bon résumé de la situation chez Authueil.

Avec TypeScript, Microsoft espère offrir à JavaScript les outils pour se développer

Beaucoup attendaient Anders Hejlsbernt au tournant. Il faut dire que l’homme attire l’attention, tant il cumule les succès professionnels. Après avoir participé à l’élaboration du Turbo Pascal, l’ingénieur danois est devenu chef de projet sur Delphi puis a créé le framework .NET et C# au début des années 2000. Il est en charge depuis de faire évoluer ce langage fortement typé. Autant dire qu’on ne l’attendait pas sur du JavaScript, à tort.

Note : cet article a d’abord été publié sur le blog de Clever Age.

TypeScript, le nouveau bébé de Hejlsbernt chez Microsoft, est un sur-ensemble de JavaScript ajoutant au langage un certain nombre d’extensions conceptuelles dont notamment le typage statique, et une orientation objet centrée sur les classes et non plus les prototypes.

Pour passer de TypeScript à JavaScript, le développeur utilisera un compilateur, mais TypeScript ne doit pas être confondu avec d’autres langages générant du JavaScript : il n’est ni une réinterprétation de JavaScript dans une syntaxe différente, comme CoffeeScript, ni destiné à être exécuté dans son propre runtime comme Dart

Le langage semble pensé pour l’avenir. La syntaxe de déclaration des classes, par exemple, est issue de l’ECMAScript ES6, tant et si bien que lorsque cette version sera supportée par les navigateurs, TypeScript n’aura tout simplement plus qu’à arrêter de compiler ces classes qui seront interprétées nativement.

Niveau support, Microsoft proprose une extension Visual Studio pour sa communauté de développeurs et de l’autre, un package NodeJS. Et niveau ouverture, on signalera que le compilateur proposé (développé lui-même en TypeScript) est sous licence Apache 2.0 et que le langage est sous licence Open Web Foundation (OWFa 1.0).

TypeScript n’est pas le seul dans la course à la succession de JavaScript mais il se démarque en se positionnant non pas comme un remplaçant, mais plutôt comme une extension facilitant l’usage de JavaScript pour du développement objet. En somme, un cri d’amour de Microsoft envers une technologie en pleine émancipation sur le Web, côté client comme côté serveur.

De plus :

  • Respectant la syntaxe JavaScript, il peut être utilisé dès maintenant sur des projets en Production, sans coût de migration
  • Quand c’est possible, TypeScript infère le type. Cela veut dire que même si vous lui passez vos JavaScripts actuels, il les validera en vérifiant que les types sont respectés
  • Il n’exclut pas de continuer à utiliser les outils JavaScript déjà présent dans votre intégration continue : compilateurs, réducteurs, concaténeurs s’appliqueront sur le JavaScript en sortie de TypeScript.
  • En ajoutant un compilateur, il ajoute une sécurité supplémentaire contre les erreurs de développement
  • Son compilateur est lui-même en JavaScript, ouvrant la porte à des compilations à la volée
  • Il est livré avec des add-ins pour la coloration syntaxique sous Sublime Text 2, Vim et Emacs

A vous d’essayer désormais, et de vous faire une idée…

GitHub communique sur son monitoring de la performance

GitHub, qu’on connait bien pour ses nombreuses publications sur l’intégration continue ou le travail délocalisé, vient de publier sur son blog un article dédié à la Performance Web.

Note : cet article a d’abord été publié sur le blog de Clever Age.

La société y présente notamment son tableau de bord dont le design est assez pertinent et les données traitées de manière statistiques. Mieux, elle y rappelle l’essentiel : un tableau de bord est fait pour informer, pas pour expliquer. L’explication se fait au moyen d’autres outils, plus fins, page par page et surtout, plus manuels.

J’espère que, dans un prochain article, ils nous parleront de la façon dont ils incluent la performance Web dans leur intégration continue, et des modalités de leurs levées d’alertes. La performance Web a bien besoin d’évangiles, et GitHub est le bienvenu.

Lire l’article de GitHub.

"A quelle vitesse ma page se charge-t-elle ?"

Cette question est à la base de toute stratégie de WebPerf et pour autant, elle n’admet aucune bonne réponse. Alors comment mesurer la performance Web ?

Note : cet article a d’abord été publié sur le blog de Clever Age.

Il n’y a pas de façon « standard » de mesurer la performance web mais plusieurs, qui correspondent à ce qui se passe dans le navigateur lors de l’accès à une page Web. Quand vous tapez dans votre barre d’adresse l’URL de Clever Age et attendez que la page s’affiche, votre navigateur :

  1. Se connecte au serveur hébergeant le site et lui demande de renvoyer le contenu de la page HTML
  2. Reçoit le contenu de la page HTML
  3. Interprète le code HTML pour comprendre comment est structurée la page et de quels objets supplémentaires (images, mises en forme, scripts…) elle a besoin pour être rendue
  4. Charge l’ensemble des ressources en question
  5. Affiche la page
  6. Exécute d’autres script après le chargement, impliquant eux-même le chargement de nouvelles ressources et le déclenchement d’animations

La mesure de la performance du site passe alors par la compréhension de plusieurs indicateurs :

Schéma présentant les différentes étapes du chargement d'une page Web

Les différentes étapes du chargement d’une page Web

Le « Time To First Byte »

Description : le « Time To First Byte » est le temps séparant la demande de votre navigateur et la réponse du serveur hébergeant la page que vous souhaitez consulter.

Référence : on considère qu’un « Time to First Byte » acceptable est bien inférieur à la seconde, et idéalement de l’ordre de 100ms, même si peu de sites importants atteignent ce niveau (la tendance globale du Web allant même vers une certaine lenteur).

Quels problèmes ? : le « Time To First Byte » est utile pour déterminer les problèmes relatifs au réseau (latences), à la résolution du nom DNS (le lien entre l’URL du site et le serveur qui l’héberge) ou à un problème de délivrance du code HTML du site (absence ou mauvaise stratégie de cache, par exemple).

Impacts: à moins d’être véritablement catastrophique, le « Time To First Byte » n’a que peu d’impact sur l’utilisateur. En revanche, le « Time To First Byte » a énormément d’impact sur le référencement, il est donc nécessaire de le chouchouter.

Les temps d’affichage

Description : suivant la qualité du code HTML renvoyé par le serveur, un site s’affichera avant même que le navigateur n’ait reçu l’ensemble de la page ou bien longtemps après. Le moment auquel le premier élément est affiché est appelé « Start Render Time ». Le moment auquel le dernier élément de la fenêtre du navigateur (qui n’est pas forcément le dernier élément de la page si la page est plus longue qu’un écran) est appelé « Perceived Render Time » ou parfois « Above-The-Fold Render Time » bien que l’utilisation du terme « Fold » n’ait que peu de sens aujourd’hui, avec la multiplication des formes d’écrans).

Quels problèmes ? : un mauvais temps de rendu signifie le site est soit trop « lourd » (il contient tellement d’objets qu’il est nécessaire aux navigateurs de récupérer de très nombreux fichiers avant de l’afficher). Cependant, tous ces objets ne sont pas forcément utiles à l’affichage et un site riche en contenu multimédia, par exemple, mettra certainement plus de temps à s’afficher qu’un site contenant uniquement quelques lignes de textes.

Impacts: le temps du rendu est celui de l’utilisateur, il est donc votre vitrine. Optimisez ce temps pour satisfaire vos visiteurs. Certains sites, comme Twitter ou Facebook, utilisent même une « coquille vide » qu’ils alimentent ensuite, zone par zone.

Le « Load Time »

Description : une site n’est pas qu’une page HTML mais également un ensemble de ressources multimédia. Le Load Time est le temps nécessaire au navigateur pour rendre tous les éléments visibles (textes, images, mises en forme) et invisibles comme les scripts Javascripts. La mesure du Load Time étant renvoyée nativement par tous les navigateurs, il est facile à capturer et est donc souvent utilisé comme élément de comparaison pour la performance Web de deux sites, souvent à tort.

Quels problèmes ? : le Load Time doit être recoupé avec ce qu’il représente, en l’occurence le temps de chargement des ressources utilisées par la page. Un fort Load Time peut donc être symptomatique d’un trop grand nombre de ressources (le navigateur ayant des limitations sur le nombre de téléchargement simultanés qu’il peut lancé), d’un problème dans la récupération de celles-ci (réseau, par exemple) ou tout simplement de ressources trop grosses (images mal dimensionnée, contenus animés…).

Impacts: le Load Time est souvent considéré comme le moment auquel un site devient interactif, à tort. Gonflé par des scripts de récupération de statistiques qui n’ont aucun impact sur l’utilisateur, le Load Time est alors déclenché bien après que la page soit devenue véritablement interactive. Ceci étant, le Load Time étant souvent utilisé comme mesure comparative, un site a tout intérêt à le minimiser et donc à déporter ces scripts plus tard dans la chronologie d’exécution.

Le « Time To Last Byte » (ou à tort : « Response Time »)

Description : le Time To Last Byte est le moment auquel plus aucune information n’est échangée (récupérée ou envoyée) par la page du site chargée. Ce temps est parfois appelé Response Time, même si ce nom fait croire « à tort », qu’il s’agit d’un moyen simple de mesurer la performance d’une page, alors que pas du tout !

Quels problèmes ? : le Time To Last Byte n’a pas beaucoup d’intérêt. En revanche, c’est à son lancement qu’il est intéressant de mesurer le nombre d’objets total et le poids qu’ils représentent pour les internautes.

Impacts : le Time To Last Byte n’a aucun impact sur l’internaute. Certains sites, d’ailleurs, ne l’atteignent jamais car ils sont constamment en situation d’échange telles les messageries ou les réseaux sociaux, qui se mettent souvent à jour en temps réel.

Scripts tiers & appels induits
ne perdez pas le contrôle de votre site

Parmi tous les sujets liés à la performance des sites Web, certains sont bien connus (mise en cache, minification, etc.). Cependant, il en existe un qui, bien moins connu, peut avoir des impacts conséquents sur votre site : il s’agit des scripts tiers. On en manipule tous les jours, parfois de manière extrêmement machinale et pourtant, c’est le loup qui se cache dans la bergerie. Voyons de quoi il retourne exactement…

Parlons un peu de contenus tiers, et plus particulièrement de scripts tiers. Allons, allons, ne me dites pas que vous ne savez pas de quoi je parle… Le bouton « J’aime » de Facebook ? Le bouton « Google +1 » ? Le code JavaScript de Google Analytics ou de Xiti ? Tous des scripts tiers, et presque tous présents sur la grande majorité des sites Web français. Du contenu peut-être présent également sur votre site, que vous le sachiez ou non, et qui peut nuire à votre performance technique et commerciale comme à la sécurité de l’information que vous détenez sur vos visiteurs. Comment ? C’est ce que nous allons analyser ensemble.

Paroles, paroles, paroles

Tout commence toujours par une promesse :

– Bonjour, nous sommes la société XXX et nous aimerions vous proposer nos services qui [description enchanteresse à base de poneys volants sur Mars].
– Écoutez, oui, mais je reste sceptique. J’aimerais inclure votre logiciel dans mon site mais j’imagine que tout cela a un coût technique… ?
– Pas du tout, car une simple ligne de JavaScript suffit.

Des pays entiers sont tombés pour cette simple ligne de JavaScript (au moins sur cette carte). Car cette discussion est en général suivie d’accords commerciaux et de cinq minutes de développement montre-en-main et paf ! Vous venez d’inclure un script tiers dans votre site. Fantastique ? Pas forcément. Qu’avez-vous réellement fait ? Vous avez conclu un accord avec un intervenant extérieur à votre S.I., lui proposant d’inclure dans votre site un espace d’exécution JavaScript que vous ne contrôlez pas. Même si vous avez défini contractuellement les conditions d’utilisation de cet espace, vous n’avez que très peu de moyens à votre disposition pour le surveiller. Vous venez de transformer votre site en porte-avions, sans avoir aucun contrôle sur les engins qui en décollent et y atterrissent. Et votre prestataire en est bien souvent conscient…

GIF: Extrait animé du film The Shining : Jack Torrance regarde Danny et lui fait un grand sourire… très flippant.

Quand on essaie de me convaincre en me disant qu’une simple ligne de Javascript suffit

Viens chez moi, j’habite chez une copine

Les services fournis par ces prestataires sont légion : publicité (régie, reciblage, publicité comportementale), échanges de données, mesures analytiques, fournisseurs de données tierces, mesures de performance… Tous ont cependant le même défaut : ils ouvrent votre site à des éléments extérieurs, hors de votre portée et très souvent, hors de la leur.

Prenons l’exemple d’une régie publicitaire qui vous propose d’inclure dans vos pages une iFrame qui ressemble à ça :

<iframe
    src="https://maregie.com/0/4563/ad.htmlAccueil=0&Comportemental=1&urlsrc=monsite.com/about"
></iframe>

Que se passe-t-il après que vous l’ayez inclue dans votre site ? Elle ouvre une porte, et vous n’avez aucun contrôle sur ce qui va rentrer. Cette régie travaille peut-être en relation avec d’autres régies. Ainsi, lorsque vous appelez maregie.com, une redirection est faite vers regiepartenaire.fr sans que vous le sachiez.

Au passage, notez que vous avez appelé la première régie en SSL, ce qui a un impact significatif sur le temps de chargement. Or rien ne vous assure que la redirection est sécurisée, ce qui est déjà un problème, mais surtout ce premier appel ne sert à rien, puisqu’il ne contacte pas la régie qui vous livre la publicité finale. C’est ce que j’appelle la problématique des appels induits : sans que vous ne les ayez invités, ces éléments sur lesquels vous n’avez aucune information peuvent porter atteinte à l’intégrité de votre site.

L’appel de tous les dangers

Ces appels de ressources induits peuvent avoir plusieurs effets négatifs sur la qualité technique de votre site, ou sur son efficacité commerciale.

Performance Web dégradée

L’exemple de script tiers précédent avait une vocation pédagogique et simplifiait énormément la problématique. D’expérience, le nombre d’appels inutiles peut être bien plus important, de l’ordre de plusieurs dizaines, voire de plus d’une centaine de redirections, scripts, images… Ces appels ont différentes conséquences sur la performance Web :

  • Les redirections, toutes inutiles, qui gâchent un temps précieux ;
  • Les appels sécurisés, qui impliquent le chargement des différents certificats attenants et leurs interprétations souvent coûteuses ;
  • La multiplication des domaines différents qui induit un nombre important de résolutionsDNS nécessaires à leur appel.

Peu importe comment vous attaquez le problème : l’inclusion d’un script tiers et les appels qu’il induit dégradent l’expérience de vos visiteurs. La seule question qu’il vous reste à vous poser est de savoir quel en sera l’impact sur votre efficacité opérationnelle.

Sur un site e-commerce, un site plus lent peut signifier un taux de rebond plus important, et une diminution du chiffre d’affaire. Sur d’autres types de sites, cela pourra avoir divers impacts dont le plus simple : nuire à la perception qu’ont vos clients de votre marque. Mais la performance ne doit pas être votre seule crainte…

Exposition aux risques encourus par le partenaire

Entre le 31 mai et le 1er juin 2012, de nombreux sites ont subi des ralentissements conséquents, certains étant même indisponibles. Pour les utilisateurs, il était tout simplement impossible de se rendre sur ces sites, leur chargement ne se terminant jamais.

Graphique du temps de réponse d'un important site e-commerce. De nombreux pics dépassant 10 secondes.

Illustration d’un excellent article de CathPoint sur ce problème

Leur point commun : avoir intégré le bouton « J’aime » de Facebook en mode « inline ». Manque de chance, le géant du réseau social avait quelques problèmes avec sa plate-forme à ce moment précis, rendant impossible la connexion sur « www.facebook.com » mais également sur le domaine sur lequel repose l’API sur laquelle repose le widget. Ce widget, présent sur de très nombreux sites, est devenu soudain impossible à charger, et la page avec. Inutile de vous dire que tous ces sites n’avaient jamais été prévenus d’une telle possibilité. Certains se demandent d’ailleurs probablement toujours pourquoi leur business a été si mauvais ce jour-là…

Bien sûr, il existe plusieurs techniques pour ne pas être affecté par les performances d’un contenu tiers, il faut juste être conscient que l’implémentation par défaut fournie par le prestataire n’est pas toujours la plus favorable (même quand on s’appelle Google ou Facebook) et tester régulièrement votre site afin de vérifier qu’aucun partenaire tiers n’est un Single Point Of Failure (SPOF), c’est-à-dire un élément qui à lui seul peut faire tomber votre site.

Perte de données et conséquences sur la protection de la vie privée

La diminution de votre performance et les risques qui pèsent sur la disponibilité de votre site sont des inconvénients fâcheux mais techniques. Plus inquiétante encore est l’intrusion dans votre site d’étrangers qui n’ont qu’un intérêt : collecter des données sur vous ou vos visiteurs. Vous n’avez pas connaissance de ces ressources chargées lors d’appels issus de script tiers. Pourtant, elles peuvent voir et capturer des informations sur vos visiteurs sans votre consentement. Et la variété des informations qu’elles peuvent collecter est impressionnante.

Prenons l’exemple du reciblage. Le reciblage consiste à afficher à un visiteur de la publicité basée sur ses précédentes actions sur Internet. Par exemple, vous visitez un site vendant des barbecues, mais êtes interrompus et vous quittez le site. Quelques minutes plus tard, un autre site affichera une publicité vous invitant à revenir sur le premier site pour acheter un barbecue. Le prestataire vous a « reciblé » sur une catégorie de produit.

Pour bénéficier de ce service, le vendeur de barbecue comme le site qui affichera la publicité ultérieurement échangent avec le partenaire de reciblage un nombre important d’informations sur l’utilisateur, son historique de navigation et les produits qu’il a consulté. Or ce prestataire de reciblage peut lui-même faire appel à des acteurs différents, qui se retrouveront de facto en possession d’informations privées sur vous. Pire, ils pourront les altérer ou les enrichir avant de les fournir eux-mêmes à d’autres entreprises, pour d’autres services. Et vous qui aviez peur des réseaux sociaux peu soucieux de la protection de votre vie privée !

En réalité, des milliers d’informations circulent chaque jour sur vos goûts, votre personnalité, vos relations, et vous n’avez absolument jamais souscrit à aucun de ces services tout comme vous ne pouvez pas vous y soustraire. Tout cela à cause de scripts tiers inclus dans des sites auxquels vous faites confiance…

La confiance n’exclut pas le contrôle

Afin de vous prémunir de problèmes liés à l’inclusion de script tiers, et des appels afférents, il est nécessaire de mettre en place un certain niveau de contrôle. Suivant l’importance que vous accordez à ce point, et les moyens à votre disposition, vous opterez pour un diagnostic manuel répété ou pour une automatisation des tests de dépendance. Dans les deux cas, le processus d’analyse est le même.

Waterfall mon amour

Nombreux sont ceux pour qui l’outil est familier sans pour autant savoir vraiment comment l’utiliser. La Cascade (Waterfall) est une représentation des téléchargements opérés lorsqu’on visite une page, de la perspective du navigateur. Vous voyez le code HTML renvoyé par le serveur ou parfois un fournisseur de contenu et ultérieurement, le chargement des ressources (scripts, feuilles de style, images et autres médias).

Pour chaque élément, vous disposez d’un découpage du temps nécessaire à son chargement : la résolution DNS, le temps nécessaire à la connexion TCP, le temps entre cette connexion et le premier octet de donnée renvoyé, et enfin le temps nécessaire à l’ensemble du chargement.

Morceau du WaterFall du train de 13h37.

Morceau du WaterFall du train de 13h37.

Prenons l’exemple du train de 13h37. Au moment où j’écris ces lignes, le train a un Waterfall assez simple et facile à comprendre : on y voit le temps de chargement du code HTML (1050ms), puis le chargement des ressources JS et CSS quand soudain un élément sort du lot : un.gif appartenant au domaine www.google-analytics.com. S’en suivent diverses autres ressources. Ici, l’élément étranger est facilement identifiable car il y a peu de ressources dans l’absolu : on sent qu’un soin particulier a été apporté à la réduction de leur nombre et des dépendances du site à leur égard. Il est même assez aisé de valider que l’indisponibilité éventuelle de Google Analytics n’est pas bloquante pour le site en se servant de WebPageTest et de l’option « Block » permettant de verrouiller un ou plusieurs éléments durant le chargement. Comme l’atteste ce Waterfall, Google Analytics n’est pas, pour le Train, un Single Point Of Failure.

Morceau du WaterFall de lexpress.fr

Morceau du WaterFall de lexpress.fr

Prenons un second exemple : le Waterfall de lexpress.fr. La problématique est différente au premier coup d’oeil. Le découpage des appels du Waterfall met en avant plus de vingt-six domaines différents nécessaires au rendu de la page. Soit a minima 26 résolutions DNS et 26 connexions TCP (en réalité, il y a davantage de connexions). Il suffit de bloquer un certain nombre de script tiers pour se rendre compte que la performance du site souffre de leur présence : sans Facebook, Twitter, CotePerso.com, RealMedia et Xiti, le site gagne 2 secondes, soit près de 25 % de sa performance au Document Complete.

Si cela confirme que le site est bien développé au sens où il ne souffre pas d’éventuels dénis de services de ces partenaires, cela indique tout de même une certaine problématique de performance. À corréler évidemment avec les résultats commerciaux car pour beaucoup de sites de Presse, la publicité via des appels tiers est la seule et unique source de revenus.

Conclusion : il faut changer la donne

Comme vous l’aurez compris, ces appels ne sont pas que de simples lignes de JavaScript. Leur impact est bien plus important qu’on veut souvent vous le faire croire et peut nuire à l’expérience de vos utilisateurs, la disponibilité de votre site ou même votre politique de collecte et de manipulation des informations concernant vos visiteurs.

Le problème de ces appels tiers est qu’il n’existe finalement aucun consensus autour de leur impact sur le Web. Chaque entreprise, si tant est qu’elle en soit consciente, réalise ses propres analyses mais il n’existe globalement pas de « Bonnes Pratiques » ou d’organismes chargés de l’établissement d’un protocole ou d’une évaluation. C’est un no man’s land sur lequel l’absence de contrôle laisse libre champ à des comportements dignes du Far West.

Capture du tableau récapitulatif du projet P3PC

Capture du tableau récapitulatif du projet P3PC – Voir la source.

Certains commencent à organiser la contre-offensive. Patrick Meenan, via son outil WebPageTest, est un de ces acteurs majeurs de la performance Web dans le monde, et nombreux sont les projets qui reposent sur WPT. Concernant les appels de scripts tiers, on pourra plus particulièrement souligner l’initiative remarquable de Steve Souders, auteur des excellents « High Performance Web Sites » et « Even Faster Web Sites », qui via son projet P3PC donne une ébauche de ce que pourrait être une analyse systématique des performances de script tiers. Malheureusement, très peu de scripts sont aujourd’hui présents dans ce panel.

Espérons qu’un test standard émerge rapidement, et que chaque nouveau script se voit découpé, jugé, évalué non plus uniquement sur son apport commercial direct, mais également sur les risques qu’il fait encourir au site l’appelant ou au visiteur qui, sans en avoir jamais conscience, l’exécute.

Ressources additionnelles

13h37 : tous dans le train !

Juste une bafouille pour signaler que j’ai participé à la 6e édition du Train de 13h37, avec un article sur les conséquences de l’inclusion de contenus tiers sur un site. Même si je n’étais pas au courant, je suis ravi de me retrouver en Une, et je ne saurais que trop vous conseiller et la lecture de l’article et, à plus long terme, l’abonnement à ce Web-zine qui dépote et dont voici le manifeste :

Ce magazine est le fruit d’un double constat. D’une part, il y a de formidables talents dans le Web francophone, malheureusement ceux-ci sont peu mis en avant et trop souvent méconnus. D’autre part, il n’existe pas de véritable références francophones équivalentes à des sites comme A List Apart ou Smashing Magazine. Dans le même temps, en fréquentant divers événements Web francophones, nous avons clairement vu qu’il y avait une demande pour du contenu de référence en français sur le Web.

Google Analytics et la performance Web

L’équipe de Google Analytics a publié un article donnant quelques chiffres sur la performance Web à travers le monde, issus de leur collecte de données. Si l’on peut se féliciter que la problématique de la performance Web soit abordée (tant elle reste encore un sujet méconnu, à tort), il est dommage que la Team GA se permette de livrer de telles informations sans prendre davantage de précaution quant à leur interprétation.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Car ce qui est comparé ici n’est pas comparable. Les pays présentés n’ont pas les mêmes qualités de connexions, privilégient parfois le filaire (comme en France) ou le mobile (dont les latences sont incroyablement plus coûteuses et les caches de navigateurs moins importants). Le parc informatique lui-même est différent, et donc les navigateurs utilisés !

Si on ajoute à ça qu’il est très difficile, même avec des solutions de mesures similaires (solutions dites « RUM » pour Real User Monitoring, qui consistent à mesurer la performance chez le client en JavaScript) de recouper les informations de Google Analytics (voir cette discussion sur le forum Performance Web français), on se rend compte que la Web Performance est un sujet complexe qui va bien au-delà de la simple installation de la balise statistique de Google.

Enfin, la mesure du Page Load Time n’est pas suffisante pour juger de la qualité d’un site en termes de Performance Web. Le temps passé côté serveur, le temps nécessaire à la construction de la page par le navigateur, le chargement des ressources statiques… sont autant d’indicateurs indispensables pour élaborer une comparaison entre deux pages. Et ils peuvent encore être complétés ou synthétisés par d’autres, comme en témoigne la création récente du Speed Index par Patrick Meenan de WebPageTest.org.

Ce qui est sûr en revanche, c’est que le Web reste lent et s’alourdit, comme en témoignentles statistiques sur 2 ans du projet HttpArchive. Tendance qui devrait normalement s’inverser avec l’expansion du web mobile et du m-commerce.

Adobe Shadow, le Graal du développement Front-End mobile ?

Adobe vient de publier la bêta de Shadow, un outil de développement facilitant les tests et la visualisation sur de multiples plate-formes. Basé sur un projet Open Source du nom de WeInRe, la solution d’Adobe arrive sur un marché émergent et concurrentiel, déjà occupé par le très récent Chrome Beta for Android ou le plus éprouvé Opera Dragonfly (dont la documentation est très complète).

Note : cet article a d’abord été publié sur le blog de Clever Age.

Avec Shadow, l’utilisateur peut brancher plusieurs périphériques (mobiles, tablettes…) sur son ordinateur de bureau et lancer la page qu’il souhaite tester. Une routine JavaScript se charge alors de maintenir la synchronisation entre le PC et les périphériques. Ce fonctionnement, qui rappellera à certains LiveJS, va néanmoins plus loin car il synchronise également les changements d’URLs (qui sont alors répercutés sur tous les périphériques) et le contenu du DOM des navigateurs périphériques. Ces DOM peuvent alors être visualisés et modifiés en temps-réel via l’inspecteur WeInRe (fortement inspiré de l’inspecteur Webkit, vous ne serez pas dépaysés) disponible sur l’ordinateur de bureau.

Très prometteuse sur le papier, la solution est pour l’instant assez instable. Son évolution est à suivre de prêt. Et qui sait, peut-être qu’à force de propositions, nous finirons par avoir un protocole standard pour le « Remote Debugging ».

Vidéo de Shadow

Page officielle de Shadow

L’e-commerce reste lent

StrangeLoop vient de publier son rapport annuel de sur la performance Web des sites e-commerces. Se basant sur le classement Alexa, ils ont moyenné les performances de plus de 2000 sites. Les résultats sont plutôt surprenants.

Note : cet article a d’abord été publié sur le blog de Clever Age.
  1. L’e-commerce est lent. Avec une moyenne à 10s, les sites e-commerce les mieux classés sont encore très lents. Les sites commerçants les plus rapides comme Nike.com ou Amazon.com ne sont donc que des arbres qui cachent la forêt.
  2. Il faut vendre tout de suite, pas plus tard. Alors que le temps moyen de chargement associé à une première visite s’est amélioré, celui associé à une seconde visite (avec cache) s’est dégradé. Les commerçants souhaitent donc offrir la meilleure expérience immédiate, quitte à négliger les visites ultérieures. En 2012, il faut vendre vite : la fidélité ne rapporte plus.
  3. La Perf ne rapporte pas. Les sites les mieux classés sont plus lents, leurs pages sont plus lourdes et ils respectent de moins en moins les bonnes pratiques du Web. Il est regrettable que ce classement n’inclue pas les chiffres d’affaire mais toujours est-il que cela nuance l’idée reçue selon laquelle un site plus rapide est mécaniquement mieux classé.
  4. Les CDN ne sont pas synonymes de performance. Alors que de plus en plus de sites utilisent des CDN pour livrer leurs ressources, les performances ne sont pas au rendez-vous. Cela veut dire soit que les commerçants se reposent sur un CDN pour assurer la performance, soit que les sites les plus lents (pour diverses raisons autres qu’un problème de ressource) ont davantage tendance à recourir aux CDN, d’où leur surreprésentation. Dans les deux cas, le constat est le même : utiliser un CDN ne permet pas de se passer d’une réflexion interne.

Article sur le blog de StangeLoop

Silverlight 5 : dernière version ?

L’équipe de développement de Silverlight a annoncé vendredi la disponibilité de Silverlight 5. Au niveau des nouveautés : l’intégration des objets 3D déjà présents dans XNA, quelques avancées qui rapprochent les expériences dans et hors du navigateur et de nouvelles fonctionnalités pour la lecture vidéo (mode avance rapide avec correction du pitch, par exemple). Mais la vraie plus-value de cette version est la gestion des breackpoints dans les bindings, attendue avec beaucoup d’impatience par la communauté depuis de nombreux mois.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Vu la situation très délicate des technologies RIA face à HTML5, il est fort probable qu’il s’agisse de la dernière version de Silverlight. D’ailleurs, exceptionnellement, Microsoft annonce un support jusqu’à 2021, signe qu’ils n’ont pas forcément prévu de rendre cette version obsolète en en livrant une nouvelle à moyen terme. Ceci étant dit, je pense que nous n’avons pas fini d’utiliser ces technologies car elles sont communes à de nombreuses plate-formes (Windows, Mac, Windows Phone, Navigateurs…) et mûres. Cependant, leur découpage actuel n’est plus adaptée au marché et je pense que la brique Silverlight va bientôt se diviser commercialement pour mieux cibler chaque plate-forme (OS Mobile et consoles d’un côté avec l’intégration de Kinect, outils HTML5 pour le Web, gestion vidéo rattachée au streaming et packagé dans la proposition commerciale Windows Azure).

Affaire à suivre.

Node.js, nativement sous Windows et IIS

Microsoft et Joyent ont annoncé en juin qu’ils travaillaient ensemble à l’élaboration d’une version Windows de Node.js. Après plusieurs mois de développement et quelques versions préliminaires, les deux sociétés ont annoncé lundi 7 novembre avoir abouti à la première version stable de Node.js pour Windows.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Cette version 0.6.0 est nativement supportée par le système d’exploitation de Microsoft et grâce à iisnode, il est possible de l’héberger sur IIS. De quoi mettre au placard la version Windows de Node.Js disponible jusqu’ici, dont les performances étaient fortement améliorables.

J’ai vraiment hâte de voir les première synergies entre Node.js et ASP.NET, nul doute que la possibilité de les déployer tous deux sur le même Web Server devrait accélérer les choses. Vivement la version 1.0 !

HTML 5, Silverlight et Microsoft

C’est pendant la conférence D9 d’All Things Digital que Microsoft a dévoilé Windows 8 et sa nouvelle interface dynamique. Redmond compte sur cette nouvelle interface inspirée de Windows Phone, qui cohabitera avec l’interface traditionnelle tout en étant plus adaptée aux tablettes, pour encourager le développement d’applications HTML5.

Depuis, une véritable tempête s’est abattue sur la communauté des développeurs Silverlight, le Framework RIA poussé par Microsoft depuis des années et sur lequel repose Windows Phone.

Note : cet article a d’abord été publié sur le blog de Clever Age.

HTML5 à la place de Silverlight pour une stratégie unifiée

La stratégie de Microsoft autour d’HTML5 ne date pourtant pas d’hier. Lors de la Professional Developer Conference d’octobre 2010, Bob Muglia (le directeur de la division Serveur de Microsoft), Dean Hachamovitch (directeur général chargé du développement du navigateur Internet Explorer) et Scott Guthrie (président de la Divison Développeur de Microsoft) s’étaient déjà exprimés sur les investissements autour d’HTML5 et d’Internet Explorer 9. Dithyrambiques lorsqu’il s’agissait de parler du futur standard, ils étaient en revanche bien moins loquaces lorsqu’était abordé le sujet de Silverlight.

Bob Muglia expliqua cependant, lors d’une interview menée par Mary-Jo Foley, que Silverlight, bien qu’étant la plate-forme de développement de Windows Phone 7, s’était fait voler la place par HTML5 dans la stratégie multiplateforme de Microsoft. La réaction de la communauté ne s’est pas fait attendre. Se sentant trahis, déçus, beaucoup ont signé une lettre ouverte à Microsoft demandant a minima un support total de Silverlight dans Windows 8.

Malgré un démenti sous forme d’article sur le blog de Silverlight, le mal était fait et la communauté Silverlight est globalement très remontée contre Redmond.

Silverlight, une fin programmée ?

Il faut dire que la donne a profondément changé depuis le lancement de Silverlight en 2007. De nouveaux marchés ont émergé, comme les smartphones et les tablettes et HTML est le meilleur moyen de créer des applications pouvant adresser cette grande variété de plateformes qui ne supportent pas l’environnement d’exécution .NET.

Le cas de Microsoft n’est pas isolé. D’autres éditeurs de solutions RIA ont également reculé devant HTML5. Adobe, par exemple, a annoncé la disponibilité d’outils permettant de convertir du Flash en HTML5. Là encore, un rétropédalage s’est enclenché devant la grogne de la communauté mais le mal est fait : les solutions RIA vont devoir innover ou disparaître.

C’est d’ailleurs sur des créneaux particuliers que la solution s’est surtout démarquée, comme la lecture de médias de haute qualité et le streaming live. Silverlight a notamment permis de diffuser en direct et en HD divers évènements sportifs comme les Jeux Olympiques ou Roland Garros.

Et quel est le prochain périphérique de consommation de masse de médias ? C’est en effet sur smartphone, via son système Windows Phone, que Microsoft soutient le plus Silverlight. Il faut dire que sans applications de qualité, le téléphone ne décollera pas. Il est donc fort probable que ces investissements soient durables.

D’autant qu’une rumeur assez persistante dit que la prochaine version de WPF marquerait l’unification de Silverlight et Silverlight pour Windows Phone, autorisant les applications développées pour Windows Phone à tourner sur Windows 8. Microsoft se rapprocherait alors davantage des pratiques à succès initiées par Apple sur iPad et iPhone, avec un développement pour plusieurs périphériques (PC de bureau, tablettes, mobiles).

Microsoft et les développeurs Web

Et c’est à ce moment-là que la stratégie de Microsoft devient difficile à lire car à en croire les récentes annonces sur Windows 8, le système d’exploitation disposera d’une interface alternative exécutant les applications HTML5. Microsoft compterait donc doper son système en tournant le dos à Silverlight ?

Cela peut se comprendre. Nous sommes à l’aube d’une guerre des Application Stores entre les plus gros acteurs de la scène logicielle. Et pour convaincre le public, nul doute que les chiffres seront mis en avant (même s’ils ne représentent en rien la qualité et l’intérêt des applications disponibles). Commercialement, cela a du sens. D’un point de vue technologique aussi, car le nombre de développeurs Web est bien plus élevé que celui des développeurs spécialisés dans les technologies Microsoft.

Reste pour Microsoft un défi : celui de convaincre ces développeurs d’alimenter la plate-forme en applications. Si tous les développeurs Web s’intéressent à cette nouvelle norme, c’est surtout en tant qu’outil pour le développement… Web. Ils sont, pour la plupart, loin de vouloir développer des applications pour un système d’exploitation en particulier (et encore moins pour Windows). On est ici à l’opposé même des valeurs du Web.

Fréquentant beaucoup de développeurs Web, je constate également une autre tendance : la plupart de leurs conférences techniques passent au moins 20 % de leur temps à souligner les défauts d’Internet Explorer 7, 8 et même 9 pour l’implémentation des nouvelles techniques issues des standards. Animations CSS, Responsive Design… tout cela fonctionne bien sur Chrome, Firefox et Safari, mais pas sous IE. Une bien mauvaise vitrine pour Microsoft qui, malgré les annonces successives, n’arrive pas à convaincre.

Alors même si certaines initiatives vont dans le bon sens, comme le récent package pour Visual Studio permettant de développer des sites ASP.NET en HTML5 et CSS3, cela suffira-t-il pour que quelques développeurs Web raccrochent le wagon Windows 8 ? Rien n’est moins sûr.

SignalR, une nouvelle brique Open Source pour le temps réel en ASP.NET

Cela faisait longtemps qu’on l’attendait et la voici : la réponse de Microsoft aux technologies de Web Temps Réel qui fleurissent autour de Node.js.

Note : cet article a d’abord été publié sur le blog de Clever Age.

Bienvenue donc à une, ou devrais-je plutôt dire 5 nouvelles briques applicatives (disponibles via le gestionnaire de paquet NuGet) regroupées autour du nom SignalR. De quoi patienter et mettre en place diverses optimisations en attendant l’avènement des WebSockets…

Vous trouverez plus d’informations sur SignalR dans l’article de Scott Hanselman (à l’intitulé long comme un titre de film français) « Asynchronous scalable web applications with real-time persistent long-running connections with SignalR ».

Je vous conseille au passage l’article de mon collègue Benjamin Clay sur le Web Temps Réel avec Socket.IO.

Présentation de Windows8 à la conférence //BUILD/

Hier était présentée en grandes pompes la prochaine mouture de l’OS de Microsoft, nom de code « Windows 8 ». À chaud, on peut déjà relever quelques points : rétrocompatibilité Windows 7, performances améliorées, cibles « tablettes », nouvelle interface au look Flat Design, Internet Explorer 10, nouvelles modalités de login (il était temps), développement HTML/JS, Marketplace, compatibilité des applications Windows Phone… mais ce sera probablement l’objet d’un futur article.

La position commerciale, en revanche, mérite qu’on s’y attarde car le discours sous-jacent est :

Ce n’est pas un jouet, c’est un PC.

Il ne s’agit donc pas d’un OS fun qui se voudrait sérieux, d’un système élégant qui se voudrait productif. C’est avant-tout un PC, un système qui amène des nouvelles fonctionnalités à quelque chose que le public connait déjà.

Je ne m’attendais pas à un tel positionnement, même si je le comprends. C’est en tout cas un sacré pied-de-nez à Apple et consorts qui ne devraient pas manquer de réagir dans les jours/semaines qui viennent. Le retour du I’m a Mac / I’m a PC ? En attendant, les utilisateurs avancés pourront s’essayer à ce nouvel OS en téléchargeant la Preview en 32 bits, 64 bits ou 64 bits pour développeurs.

Ethique du développement

Nous sommes tous de mauvais développeurs dans la mesure où aucun code n’est parfait et où les habitudes des uns ne sont pas celles des autres. Ceci étant dit, ce n’est pas une raison pour ne pas faire attention à la qualité du code qu’on contribue. La qualité de code n’est pas réservée à un responsable donné, pendant une campagne donnée.

Le problème, sur un projet massif, est que personne n’ose modifier le code parce que :

  • cela entraîne un risque de régression ;
  • l’intégrer en branche supérieure devient plus fastidieux ;
  • on ne veut pas vexer la personne qui a fait le développement à l’origine ;
  • on attend les outils (ou leur mise-à-jour) permettant d’industrialiser la relecture de code afin d’être plus efficaces…

La liste est longue. Pourtant, meilleur sera le code contribué, plus légère sera la maintenance. En réduisant la surface de code sur laquelle des erreurs sont possibles, on limite les risques de bugs mais ce n’est pas tout : en cas d’erreur, la relecture d’un code bien écrit facilitera l’identification et la correction.

Tout le problème réside dans l’égo des développeurs car personne n’aime se dire (et pire, se faire dire) qu’il a mal codé. Pourtant, avoir développé un code améliorable n’est pas mal coder. Nous avons tous des impératifs (de temps, de charges, de couverture fonctionnelle) qui font qu’on peut être amené à coder vite, ou à mal nettoyer des éléments superflus. Il ne faut pas juger les gens sur ça. Ce qui est mauvais, en revanche, c’est de savoir que le code est mauvais et de ne rien faire pour changer les choses.

On arrive là sur un problème qui n’est plus véritablement un problème technique mais davantage un problème d’éthique du développeur et c’est là que l’égo devrait retrouver sa place.

Web Standard Update pour Visual Studio 2010 : support de HTML5 & CSS3

Il n’y a rien qui vous empêchait, dès hier, de créer des sites Web HTML5 et CSS3 en ASP.NET WebForms ou MVC avec Visual Studio. Des schémas de validation existaient, il suffisait de les télécharger et de les installer. Cependant, il fallait dire au revoir à l’Intellisense et à la prise en charge de certaines balises. Microsoft, sous l’impulsion de Mads Kristensen, vient de faire un gigantesque pas en avant en faveur des standards W3C et c’est une excellente nouvelle !

Logo de Visual Studio surplombant le logo d'HTML5

Logo non-officiel de Web Standard Update, proposé par Scott Hanselman

C’est en réunissant quelques collègues de l’équipe « Plate-Forme et Outils Web » qu’est né la « Rogue Team » à l’origine de ce Web Standard Update pour Visual Studio 2010 qui ajoute à Visual Studio le support d’HTML5, de CSS3 et de nouvelles fonctionnalités JavaScript.

Au menu des fonctionnalités HTML5, on pourra citer : Video, Audio, Input typés, support du Drag & Drop, WAI-ARIA pour l’accessibilité, Microdatas & Schema.org (ce sont les SEO qui vont sauter de joie)…

Côté API navigateurs : Geo-Location et Local Storage.

Pour le support de CSS3, une liste de support tellement longue que je vous invite à la consulter sur le blog de Scott Hanselman, mais sachez que vous pourrez enfin utiliser div:nth-child(2n+1) sans erreur de validation. Même les préfixes -webkit et -moz sont supportés.

Enfin, la meilleure nouvelle est que cette mise à jour n’est pas un coup d’épée dans l’eau, Mads Kristensen ayant d’ores et déjà annoncé son objectif de livrer une nouvelle version chaque trimestre, afin de maintenir Visual Studio à jour.

Alors que la polémique enfle depuis la Professional Developpers Conference 2010 à propos de l’investissement croissant de Microsoft dans HTML5 (et les craintes que cela suscite par rapport à Silverlight 5), nul doute que cette nouvelle annonce va jeter de l’huile sur le feu.

Mais pour les développeurs ASP.NET, quelle bonne nouvelle !

A la recherche du nouveau décompilateur

Si comme moi vous développez en .NET depuis un bout de temps, vous avez probablement entendu parlé de .NET Reflector de Red Gate, cet utilitaire qui décompile vos assembly .NET et vous permet de voir le code C#/VB.NET contenu dans vos DLL. Récemment, .NET Reflector est passé d’un mode de distribution gratuit à payant. Cette situation a incité la communauté à se retrousser les manches et c’est comme ça que sont nées diverses alternatives.

Capture d'écran de IL.Spy

IL.Spy est une alternative à Reflector

En ce moment, je teste IL.Spy, une solution gratuite et open-source, pas aussi développée que Reflector mais qui convient à mes besoins. J’ai également installé dans un coin dotPeek de JetBrains, mais les premiers lancements ne sont pas concluants : la solution est très lente.

Si vous avez d’autres propositions, je suis preneur !

Développeurs Web : 10 conseils ultimes…

Je pointe à nouveau vers une excellente ressource extérieure. Cette fois l’article vient de Rudy, et donne 10 conseils incontournables pour décrocher un job dans une Web Agency qui envoie de la marmotte sur Mars. Bonne lecture.

Le stage, CDD déguisé

Les entreprises ne proposent plus de stages, elles recherchent des stagiaires. Le changement de vocabulaire n’est pas anodin, il reflète la façon dont le stagiaire est intégré dans le fonctionnement de l’entreprise : Le stagiaire est devenu un élément productif.

La suite, très intéressante, ici.

Société recherche stagiaire expérimenté

J’ai reçu aujourd’hui, sur Viadeo, une offre digne de Yattu. Je ne livrerai pas la société émettrice en pâture à vos commentaires acerbes, mais si la RH qui m’a envoyé cette offre passe par là, j’aimerai bien qu’elle lise la suite et se rende compte…

… je me permets de vous envoyer ce mail car votre profil a retenu toute mon attention.

Je suis d’un naturel positif et humaniste. Aussi vais-je déduire que non, ceci ne peut pas être le fruit de « toute votre attention ». Je suis sûr que « toute votre attention » peut faire mieux que ça.

Notre société […] basée à Paris et à Lyon

J’habite Bordeaux, je n’ai pas l’intention de déménager. Mais pas de problème, j’ai bien compris comment fonctionnait EasyJet. Et puis la dernière fois que je suis allé à Lyon, je n’ai pas eu l’occasion d’en profiter. C’est l’occasion ou jamais.

Nous recherchons un stagiaire pour assurer le bon fonctionnement du parc informatique et apprendre à mettre en place des évolutions sur ces technologies

Ca fait un moment que je n’ai plus fait de stage mais peut-être que pour le plaisir d’un salaire réduit et de quelques remarques désobligeantes, je vais remettre le couvert. Et puis c’est logique : qui, mieux qu’un stagiaire, pourrait prendre en main la gestion d’un parc informatique ? C’est tellement plus rassurant (et bien moins cher) que quelqu’un d’expérimenté.

Vos tâches récurrentes sont : la préparation de PC, la création de compte…

Écoutez, je suis épaté, ça correspond parfaitement à mon profil de consultant en développement .NET avec un historique dans la Finance, tout ça. C’en est presque magique.

Votre profil : vous possédez de bonnes connaissances en système et réseaux (vous avez déjà fait des stages)

Il va quand même falloir que je révise un peu. Les diagrammes de couches, les archi réseaux… je n’ai pas fait tout ça depuis l’Ecole d’Ingénieur mais bon, ça devrait revenir sans problème. Et puis si j’avais vraiment déjà fait des stages (comme dans plusieurs), j’aurais peut-être fini par avoir un contrat, non ? Donc finalement c’est pas plus mal.

Vous êtes autonome, rigoureux,« jusqu’au bout » et possédez un bon sens du service

Pas de souci, je n’ai pas de vie. Je commence le boulot à 6h le matin, finis à minuit et entre les deux, je me contente d’aller prendre une douche, de m’alimenter, et de faire quelques courses pour mon maître de stage.

Ne connaissant pas votre projet professionnel …

Ah ? Je n’avais pas remarqué…

Je vous propose d’échanger par téléphone

Hum, comment vous dire… Non.

Un an déjà

Voilà un an que nous sommes revenus vivre à Bordeaux. Nous avions des projets pleins la tête, et beaucoup d’inquiétudes.

Nous libérions notre appartement pour aller vivre chez ma belle-sœur, sans certitude sur la durée de notre séjour. Nous quittions nos emplois respectifs, avec pour Libellule l’incertitude d’en trouver un nouveau et pour moi l’inconnu d’un nouvel employeur.

En ce jour de Noël, nous avons célébré notre premier anniversaire de retour en province. Nous avons tous les deux un emploi et avons acheté une maison et une voiture. Nos rythmes ne sont plus ceux de la région parisienne ce qui nous laisse du temps pour profiter l’un de l’autre, loin du stress. Certes, nos salaires ne sont plus les mêmes mais notre vie est agréable et souvent paisible. J’ai pu y prendre le temps de faire éclore d’autres projets, comme celui de l’auto-entreprise, ou de SocialStorm, avec plus ou moins de succès mais toujours autant de plaisir.

Un chapitre se clôt, un nouveau s’ouvre. En 2011, nous passerons de deux à trois avec tout ce que cela implique de nouveaux défis et de difficultés mais également de petits et grands bonheurs.

J’ai hâte.

Des crèches dans les mairies

Je suis contre la mise en place d’une crèche dans une mairie. Par respect pour les croyants, d’une part , car je trouve que c’est un transfert du monde religieux vers le monde culturel qui enlève à la crèche son symbole chrétien ; par esprit laïc d’autre part, car cela reste un signe issue de la religion qui n’a rien à faire dans un lieu de la République.

Cela n’a rien à voir avec les racines chrétiennes de la France, que je reconnais complètement et qui font, en grande partie, nos valeurs. Ces racines s’expriment dans nos noms de communes, dans nos jours fériés, dans de nombreux aspects de notre culture… et cela suffit très largement.

Le christianisme et les autres religions n’ont pas la même empreinte sur l’Histoire de France mais sont égaux devant la loi. À moins qu’un maire puisse la justifier pour des raisons culturelles (par exemple, dans des villes où la manufacture de santons est légendaire et où la mairie organise des expositions comparant plusieurs types de crèches à travers les âges ou démontrant différents types de savoir-faire), cela n’a pas lieu d’être.

Productivité, périmètre et écoute

La plupart des projets informatiques échouent à cause d’un mauvais management. Il n’y a pas forcément de responsable(s) à désigner, et il n’est pas évident de trouver les éléments à améliorer, qui peuvent varier d’un projet à l’autre voire d’un sprint (en Scrum) à l’autre. Néanmoins, l’expérience montre que certains besoins reviennent régulièrement.

Distinguer productivité et disponibilité

La productivité est le Saint Graal des chefs de projets MOE en quête de réussite. Abattre le plus de projets avec le moins de jour/homme, tel est leur credo. Certains n’hésitent pas à jongler pour déplacer des collaborateurs d’une équipe à une autre, au gré des besoins, demandant à chaque développeur le nombre exact de jours nécessaires pour réaliser une tâche et calculant les plannings au jour près.

Seulement voilà : déplacer des collaborateurs pour remplir des besoins verbalisés ne fonctionne pas. D’abord, parce qu’il est excessivement difficile de prévoir le coût d’un projet au jour près avant d’en avoir atteint environ le tiers. Le cône d’incertitude est trop large, et les estimations varient d’un quart à quatre fois le temps réellement nécessaire. Ensuite, parce que les incertitudes autour des spécifications du projet entrainent des aller-retour avec les commanditaires et que ces aller-retour peuvent entrainer des ré-évaluation du temps nécessaire. Même en itérant des petites tâches avec un modèle agile. Enfin, cela ne fonctionne pas parce qu’un collaborateur n’est pas un poids que l’on déplace sur une balance pour la faire pencher : sa contribution n’est pas égale, d’un projet à un autre. Pire : sur un projet qu’il maitrise peu, un collaborateur peut freiner la dynamique d’une équipe qui n’hésitera pas à l’aider à prendre ses marques en dépit de sa productivité immédiate.

Si vous souhaitez réellement améliorer la productivité de vos collaborateurs, ne modifiez pas la taille de vos équipes. Concentrez-vous plutôt sur deux choses : la motivation et le leadership. Donnez une direction à vos équipes, faites-leur entrevoir une finalité à laquelle ils auront contribué. Une fois qu’il auront une bonne idée de l’objectif et de l’importance de leur participation, donnez-leur une voix à suivre (celle de leur responsable, du technicien le plus expérimenté, du collaborateur le plus passionné) qui sera leur guide. Si un de vos développeurs a besoin d’aide, faites en sorte qu’il se sente libre de le dire et donner lui des opportunités de l’exprimer.

N’hésitez pas, également, à mettre en place une stratégie de montée en compétences communes. Pour cela, favoriser l’échange plutôt que la rédaction de documents et n’hésitez pas à faire basculer un développeur, un jour par semaine, sur la même tâche qu’un autre. Cela vous fera perdre du temps, c’est certain. Mais à termes, la qualité du code produit tout comme la capacité de l’équipe à absorber l’absence d’un membre seront améliorées. Et vos développeurs seront ravis d’avoir eu l’occasion de toucher à l’ensemble des projets, car ils auront une meilleure vision de la solution globale.

Garder le commanditaire à la périphérie du projet

Nous devons comprendre ce que les commanditaires veulent, et quand ils en ont besoin. Cet impératif est d’autant plus fort quand les projets prennent du retard. Il est courant que les commanditaires ne soient pas mis au courant, afin de « ne pas les inquiéter », car le chef de projet pense que le dépassement pourra être rattraper dans une phase postérieure du projet. Mais le plus souvent, ce retard n’est pas rattrapé et ce n’est qu’une fois au pied du mur que le chef de projet décale la date de livraison. Le retard devient alors réellement problématique alors que s’il avait été communiqué plus tôt, il aurait pu être anticipé par le commanditaire.

La raison de ce comportement est simple et compréhensible : la peur de décevoir. La solution est simple aussi : communiquer. Si vous communiquer régulièrement avec vos commanditaires sur les difficultés rencontrées, et l’énergie que vous dégagez à essayer de les résoudre, leur déception en cas d’imprévu sera moindre, car cela ne sera pas une surprise. Mieux, ils seront en mesure de comprendre ce qui, dans leur demande, a pu générer des difficultés. Ils pourront ainsi, sur certains projets dont la date de livraison est cruciale, réfléchir avec vous, en amont, à l’élimination des risques.

L’équilibre est délicat à trouver car un commanditaire trop présent peut nuire à un projet en ajustant trop souvent sa demande ou en analysant les zones ponctuelles d’avancement rapide comme une absence de charge de l’équipe. À vous, chef de projet, de trouver la juste mesure dans votre communication et garder vos commanditaires sous contrôle.

Considérez les retours de vos développeurs

Un chef de projet doit penser plus loin que ses développeurs, mais ce n’est pas une raison pour ne pas les écouter. Dans le développement logiciel, vos collaborateurs sont votre seule ressource : il n’y a rien de plus important que de vérifier qu’ils ont tout ce qu’il leur faut pour faire leur travail. Malheureusement, de nombreux chefs de projet préfèrent se focaliser sur des dates, des réunions ou des échéances, ce qui est aussi une bonne chose car cela permet de pousser le projet en avant, mais parfois le retour des développeurs est négligé. S’en suit des problématiques de productivité, des raccourcis techniques mal pensés, des développements de mauvaise qualité…

Et ne croyez pas que vos développeurs ne vous demandent rien parce qu’ils ne vous demandent rien. Leur silence est en soin une demande. Aucun projet n’est parfait et aucun développeur ne rencontre jamais de problèmes. S’ils ne vous en parlent pas, c’est qu’ils considèrent soit que vous ne pouvez pas les aider, soit qu’ils n’ont pas le niveau pour les résoudre eux-même. Dans la plupart des cas, le problème n’est pas tant technique qu’une blessure à l’égo. Ce silence peut alors devenir le symptôme d’un cercle vicieux où le développeur aura tendance à se replier sur lui-même et ses défauts.

Écoutez vos développeurs. Sachez capturer les plaintes récurrentes et les silences suspects. À vous ensuite de tenter de les résoudre ou au moins d’y apporter une réflexion, une valeur ajoutée, ou une réorganisation du projet qui permettra aux personnes en difficulté de bénéficier des connaissances de développeurs plus expérimentés. Rien de sert de faire durer les choses en les formalisant par des sprint de revue de code ou des processus extrêmement formalisés. Souvent, une discussion Over-The-Shoulder sur une portion de code difficile suffit à débloquer une situation. Arrangez-vous juste pour que cette discussion ait lieu, en permettant à vos développeurs d’exposer leurs problèmes sans pénaliser leur égo.

Bienvenue à / Welcome to Regenerate Thumbnails 2.1.0

Une nouvelle version du plugin Wordpress Regenerate Thumbnails est disponible, avec quelques améliorations issues d’un de mes projets personnels.

A new version of the Regenerate Thumbnails plugin is available, including some improvements from one of my personal projects.

Lors de mon dernier changement de thème de blog, j’ai découvert qu’il était impossible, sans plugin, de générer à nouveau les miniatures des images de sa Media Library. Il y avait bien un plugin, Regenerate Thumbnails, qui permettait cela sur l’ensemble des images mais il ne convenait pas parfaitement à mon besoin. Alors j’ai décidé de l’améliorer en ajoutant une gestion d’erreur, un bouton pour arrêter le processus, quelques informations d’historique, la possibilité de générer à nouveau une seule image à partir de la page Media… Et j’ai proposé mes modifications à l’auteur du plugin, Alex M. aka Viper007Bond, un développeur d’Automattic, l’entreprise connue pour sa participation à Wordpress et sa plateforme de blog Wordpress.com. Alex a décidé d’en intégrer quelques-unes et de s’inspirer des autres pour améliorer un peu plus Regenerate Thumbnails. Essayez-le !


Last time I changed my blog’s theme, I discovered that it was impossible to regenerate Media Library images’ thumbnails without a plugin. There was a plugin called Regenerate Thumbnails which resized all the images but it did not meet my needs. So I decided to improve and enhance it with error handling, a button that will allow you to abort the process, some log information, the possibility to regenerate a single image from the Media page… and I proposed my modifications to the plugin’s author, Alex M. aka Viper007Bond, a developper who works for Automattic, the company well-known for its contributions to Wordpress and its free blogging network Wordpress.com. Alex decided to include some of them and redevelop the others to improve Regenerate Thumbnails even more. Try it !

Facebook n’a rien à voir là-dedans

Il y a en ce moment une affaire qui fait scandale, où une salariée est poursuivie aux Prud’Hommes pour des propos tenus sur Facebook. La tendance est à l’accusion du réseau social, qualifié de danger pour nos libertés. C’est en général vrai.

Mais, un salarié a une obligation légale de discrétion concernant les informations dont la divulgation à des tiers serait préjudiciable à l’entreprise et par extension, à ses clients. Facebook et la mise en danger des libertés individuelles n’ont aucun rapport avec ça.

"Rework, réussir autrement", disponible en français

Une petite note pour signaler que l’ouvrage « Rework » de Jason Fried et David Heinemeier Hansson, est désormais disponible en français aux éditions Maxima. Il est bien évidemment disponible sur le site de Maxima, et dans toutes les bonnes librairies.

Vous apercevrez peut-être, en page 5, une petite gribouille de votre serviteur qui a participé à la relecture de la version française.

[VS2010] Productivity Power Tools

Visual Studio 2010 est assez riche en fonctionnalités à l’origine mais on trouve toujours deux ou trois choses sur lesquelles se plaindre, surtout si on est habitué à utiliser d’autres IDE (comme Eclipse). Heureusement, Visual Studio est extensible, et on trouve déjà de nombreux outils, dont les Productivity Power Tools.

Note : cet article a d’abord été publié sur le blog de Clever Age.

L’extension Productivity Power Tools ajoute à votre environnement trois formidables outils :

Solution Navigator

Solution Navigator est un mariage entre le Solution Explorer et le Class Viewer. Avec, vous pouvez explorer vos fichiers pour faire apparaître vos classes et leurs membres tout en filtrant l’affichage (fichiers ouverts, non-sauvegardés ou édités seulement). Mais la fonctionnalité-clé est sûrement la recherche dynamique, qui permet de trouver rapidement, dans une solution massive, les fichiers, classes ou membres comportant une certaine chaîne de caractère. Le Solution Navigator ne remplacera pas tout de suite votre Solution Explorer car il a encore quelques lacunes dans la gestion des fichiers (déplacement, sélection multiple) mais l’utiliser est très addictif.

Capture de l'écran Solution Navigator

Solution Navigator

Quick Access

Quick Access est l’outil idéal pour apprendre à utiliser Visual Studio ou en tirer le meilleur. Il vous permet, via une interface de recherche dynamique, de trouver et d’exécuter des tâches avec Visual Studio. Plus besoin de fouiller dans les menus à la recherche d’une fonctionnalité : tapez son nom et elle apparaitra. Quick Access facilite ainsi l’ouverture d’une fenêtre d’outils, le lancement d’une compilation, la création d’un projet à partir d’un Template…

Capture de l'écran Quick Access

Quick Access

Fenêtre Add Reference améliorée

Celle nouvelle fenêtre facilite et accélère l’ajout de références à votre projet. Remplaçant la fenêtre d’ajout de références standard, elle se permet se mettre en cache les informations d’Assembly à la première utilisation. Ainsi, lors d’un lancement ultérieur, la fenêtre s’affiche en moins de deux secondes. Indispensable.

Capture de l'écran Add Reference

Add Reference

Autres améliorations

L’extension installe un certain nombre d’outils et d’améliorations comme (liste extraite, traduite et enrichie à partir de l’article de Scott Guthrie, vice-président de la division Développement de Microsoft notamment connu pour sa participation au projet ASP.NET, qu’il a créé avec Mark Anders) :

  • Surlignage d’une Ligne Entière : Facilite le suivi du curseur dans l’éditeur
  • Sélection d’une Ligne Entière : Un triple-clic sur une ligne permet de la sélectionner (comme dans MS Word)
  • Déplacement d’un bloc de code : Utilisez Alt+Haut/Bas pour déplacer un bloc de code dans l’éditeur
  • Usage Consistant des Tabulations et des Espaces : Assure une utilisation consistante des tabulations et des espaces entre vos projets
  • Fermeture Automatiques : Créez automatiquement le complément fermant d’un élément d’ouverture (comme (), , [], <>, «  », et ‘’)
  • Paramètres Colorés : Facilite l’identification des paramètres de méthodes
  • Indicateurs de Colonnes : Ajoute, si vous le voulez, des indicateurs visuels verticaux (de couleurs différentes) facilitant l’alignement du texte
  • Affectations Alignées : Facilite l’alignement de vos affectations de variables dans le code
  • Presse-Papier HTML : Copiez/Collez votre code depuis Visual Studio vers un tampon HTML (utile pour blogger)
  • Ctrl + Clic pour Aller à la Definition : Maintenez Control enfoncé en cliquant sur un type pour aller à sa définition

L’extension inclut également quelques améliorations dans la gestion des onglets par l’IDE :

  • Affichage du Bouton Fermer dans l’Onglet : Affiche un bouton de fermeture dans l’onglet actif (comme c’était le cas dans VS 2008)
  • Onglets Colorés : Vous pouvez désormais affecté une couleur à chaque onglet de votre projet ou déterminer une couleur via une expression régulière
  • Accrochage des Onglets : Vous permet d’accrocher un onglet à l’IDE, afin qu’il soit toujours visible et disponible
  • Onglets Verticaux : Affiche les onglets verticalement, ce qui permet d’en afficher davantage
  • Retrait des Onglets en Fonction de l’Usage : Retire les onglets les moins utiliser lorsque l’ajout de nouveaux onglets implique des contraintes d’espace
  • Tri des Onglets par Projet : Les onglets peuvent être triés en fonction du projet auquel ils appartiennent
  • Tri Alphabétique des Onglets : Les onglets peuvent être triés alphabétiquement

Installation

Pour ajouter cette extension, ouvrez votre Extension Manager sous Visual Studio 2010 puis sélectionnez Productivity Power Tools dans la gallerie (catégorie « Tools »).

Publié dans L’Express

L’article sur « Métronome » de Lorànt Deutsch a attiré l’attention d’Annabel Benhaiem, journaliste de L’Express qui m’a interviewé par téléphone début juin. Suite à ce sympathique échange et à ceux qu’elle a sans doute eu avec d’autres blogueurs et/ou lecteurs, elle a rédigé un article qui a été publié sur LExpress.fr.

**Merci à toutes celles et ceux qui m’ont envoyé des messages pour me féliciter ou me prévenir que [l’article était également en page d’accueil de Yahoo](https://fr.news.yahoo.com/ "Lien vers "Métronome de Lorànt Deutsch, un phénomène de société?" sur Yahoo News") et dans la [version papier de L’Express](http://www.lexpress.fr/assets/16/sommaire_8636.pdf "Lien vers le Sommaire de L").**

Suite à cette publication, j’ai reçu des messages plus ou moins injurieux envers l’ouvrage, et d’autres me demandant de critiquer divers romans ou compilations de notes historiques. Je comprends la démarche de ces personnes (qu’elles apprécient ou non le livre), mais je suis loin d’être un spécialiste. Je suis avant tout un ingénieur et un geek, ainsi le contenu de mon site est davantage plébiscité pour son côté technique et technophile que pour mes petites critiques culturelles…

Phishing CAF, Impôts ou autres…
Ceci n’est pas une pipe

Je me permets aujourd’hui de citer une fameuse légende d’un tableau de René Magritte pour vous parler d’un mail reçu par un collègue il y a peu. Ce mail représente une tentative de hameçonnage (phishing en anglais), dont j’ai déjà donné la définition il y a un moment.

Ce mail n’a bien sûr rien à voir avec la CAF. En cliquant sur le lien fourni, la victime arrive sur une page qui imite le site de la CAF et l’incite à entrer des informations confidentielles. Nul doute que quelqu’un de mal attentionné passera après pour détourner ses prestations sociales…

Capture d'écran de la tentative de phishing

Tentative de Phishing imitant un courrier de la CAF

Soyez vigilants, ce genre de mail est courant et peut imiter un courrier de la CAF comme une lettre des impôts ou tout autre chose. Ce n’est pas parce que le courrier est en français et dispose d’un en-tête ressemblant à la réalité qu’il est ce qu’il dit être.

Phrases Insolites… #20

C’est fou ce qu’on peut entendre quand on tend l’oreille…

Drague Sociale (et hyper macho, mais je suis sûr qu’une fille aurait pu sortir ça pour les mecs)

— C’est quand même triste ces filles qui ne veulent pas présenter leurs copines ou sœur à leur mec, parce qu’elles sont plus jolies.
— T’imagines, la réalité augmentée de demain : tu dragues une fille et apparait en sur-impression la pile de toutes les photos des autres filles célibataires de son cercle social. Comme ça, t’es sûr de pas choper la plus moche !
— T’imagines, pendant que tu la dragues imite le mouvement de parcours d’album sur l’iPhone !

Tous les goûts…

— Je vous ai mis un sirop Anis parce qu’on n’avait plus de Menthe.
— Ah, c’est bizarre, ce n’est pas vraiment ce que nous avions commandé…
— Vous aviez commandé quoi ?
— Pomme et pêche.

Cake

Excuse moi, tu pourrais venir m’aider ? J’ai voulu faire mon cake en disant que je savais faire et puis finalement, bah, je ne sais pas…

Désir d’avenir

Mon fils, je veux que plus tard tu fasses tout ce que tu veux. Vraiment. Tout ce qui te plaira sauf gigolo, marketeux ou salarié d’une organisation non-profit.

"Rework", Jason Fried et David Heinemeier Hansson

Avant de véritablement commencer à lire « Business Model Generation » (dont je ferai une critique plus tard), j’ai pris trois jours pour lire ce livre, prêté par Oncle Tom…

Jaquette du livre

Rework

"Rework" compile une centaine de conseils accessibles à toute personne souhaitant créer ou développer une entreprise. Présenté comme un concentré des bonnes pratiques, il reprend l’essentiel des méthodologies agiles : Scrum évidemment, mais aussi GTD et même Kanban. S’y ajoutent les expériences de ses auteurs chez [37Signals](http://37signals.com/), start-up au succès reconnu, spécialisée dans le développement logiciel et les service associés. Motivant et facile à lire (comptez deux à trois jours en dilettante), le livre renouvelle le plaisir de la lecture en bousculant à chaque page les idées reçues sur le monde de l’entreprise, ce qu’il faut et ne faut pas faire, égratignant au passage le carcan des règles communément établies.

Jason et David ont acquis une certaine notabilité entrepreneuriale, qui leur donne l’aplomb pour enfoncer des portes et casser des codes établis. Mais ce qui a marché pour eux ne marchera pas forcément pour d’autres. Ainsi les références à la culture américaine, notamment à sa vision de l’emploi (loin d’être partagée dans l’hexagone) sont récurrentes et limitent l’identification du lecteur européen.

On se méfiera également des conseils de « Rework » délivrés en l’état, hors d’un contexte. Chaque entreprise est différente et la mise en place d’une méthodologie ne peut pas se faire sans analyse de l’existant, sans recul sur le bien-fondé d’une révolution des processus internes. C’est donc au lecteur de prendre ce recul, d’être patient et de trouver parmi toutes ces nouvelles règles la combinaison la plus adaptée à son activité.

« Rework » est un ouvrage qui pourra ainsi servir de support de réflexion, non de guide. Considéré en tant que tel (colibri ?), il remplira parfaitement son rôle de grain de sable dans les rouages de l’organisation d’entreprise bien pensante.

Voir la fiche Amazon.com

Un média social est un canal

Malgré sa nature sociale (c’est-à-dire qu’il intègre le concept de réseau entre les personnes), le média social n’est qu’un moyen de communication qui permet la transmission d’un message, l’envoi ou la réception de signaux. Y ouvrir un compte n’est pas un signal en soi.

Si vous n’avez pas de message à envoyer et que vous ne souhaitez pas en recevoir, n’y allez pas et surtout, n’y envoyez pas votre entreprise.

Phrases Insolites… #19 : Clients From Hell

C’est fou ce qu’on peut entendre quand on tend l’oreille ! Et quand c’est une oreille de consultant en informatique ou de développeur, c’est encore plus délicieux. Que celui qui n’a jamais entendu ces quelques phrases me jette le premier bug !

Modification utile

Client : Je pense qu’on tient là une piste d’évolution intéressante qu’il faudrait implémenter. Non d’ailleurs, c’est tellement important que c’est limite un problème que ça ne soit pas déjà développé. D’ailleurs on va marquer ça comme anomalie et demander un développement urgent.

[… plusieurs jours plus tard]

Développeur : Voilà, c’est fait. Ça m’a pris du temps, mais le résultat est conforme à vos attentes.
Client : Hum, je pense qu’en fait cette fonctionnalité est inutile, nous ne l’utiliserons donc pas.
Développeur : Je la supprime alors ?
Client : Non, on va la laisser. On ne sait jamais.

Panique

Développeur : La machine est complètement bloquée, que s’est-il passé ?
Client : Je ne sais pas, j’ai juste cliqué.
Développeur : Vous avez juste cliqué ?
Client : Oui enfin, j’ai cliqué, ça n’allait pas assez vite, alors j’ai re-cliqué. Huit fois. Au cas où.

Cheaters sometimes win

Utilisateur : Au moment de la saisie, j’ai validé sans regarder. Vous pouvez corriger l’entrée en base, parce que les informations saisies sont inexactes et ça pourrait faire planter l’application sur certains postes…
Développeur : Et dans vos processus métier, vous ne vérifiez jamais avant de valider vos saisies ?
Utilisateur : Non, pas vraiment. Mais c’est pas grave parce que je connais une faille dans l’application et ça finit par marcher quand même.
Développeur : Et vous n’avez rien dit ? Vous faites ça depuis longtemps ⁈
Utilisateur : Environ 2 ans, pourquoi ?

Secrétariat de luxe

Client : J’aimerais qu’on modifie la documentation. Paragraphe 3, ligne 5, il faudrait écrire ‘les différences’ en bleu. Merci
Consultant : Voilà le document avec la modification effectuée. Permettez-moi tout de même cette question : pourquoi ne pas l’avoir corrigé vous-même ?
Client : Mais nous vous payons pour ça !

Homeland Security

Division Sécurité : Il faut revoir entièrement l’application, elle n’est pas cohérente en terme de sécurité avec le document 45b-3 paragraphe 12 rangé dans le tiroir du bas du meuble à gauche dans le bureau ‘Eloise’, Etage 4, bâtiment B.
Consultant : Ce document m’a-t-il été remis ? Je n’en ai pas le souvenir.
Division Sécurité : Vous n’avez pas le droit de consulter ce document, vous n’êtes pas assez accrédité.

Renvoi de balle

Equipe B : Cette modification a été demandée par l’équipe A. Elle ne doit donc pas nous être affectée. Merci de le signaler à l’équipe A.
Consultant : C’est ce que j’ai fait. Ils m’ont répondu de m’adresser à l’équipe B.
Equipe B : Nous les appelons pour régler ça.
Consultant : Euh, excusez moi mais il s’agit vraiment d’une manipulation simple, c’est l’histoire de 5 minutes, vraiment…
Equipe B : Non mais attendez, vous êtes externe, vous ne comprenez pas comment cela se passe ici. Nous contactons l’équipe A et s’il le faut, le supérieur. Nous allons tirer tout ça au clair, même s’il faut 3 semaines.

Windows Phone 7 : MarketPlace

La situation est tendue pour Microsoft : le Windows Phone Marketplace est ouvert depuis 8 mois mais le nombre d’applications disponibles est loin d’égaler celui de ses concurrents. On apprend dans un article sur le blog de l’équipe de développement de Windows Phone - relayé par XNA-France - les détails de la mise-à-jour de ce Marketplace, destinée à corriger le tir.

Un choix complet de modèles économiques…

La soumission d’application supportera les formats commerciaux connus : gratuit, gratuit avec publicités et payant, avec la possibilité de définir via une API les modalités de test (notamment le sous-ensemble des fonctionnalités concerné). Il suffira de s’affranchir de 99$ de frais annuels pour pouvoir soumettre autant d’applications payantes que voulu mais une limitation à 5 applications gratuites sera mise en place (au delà, le développeur devra s’acquitter de 19.99$ par application). La soumission de mise-à-jour restera gratuite et illimitée. Enfin, afin de faciliter la distribution des applications, il sera désormais possible de publier une application à l’international sans que cela ne compte comme autant de publications que de marchés visés.

Ces nouvelles déclarations s’adressent à la fois aux groupes internationaux, qui n’auront pas à remettre la main à la poche pour la publication de leurs applications partout dans le monde, mais surtout aux développeurs à la fibre commerciale. En effet, en déclarant l’application payante mais en définissant un certain nombre de fonctionnalités comme étant testables gratuitement de manière illimité, ceux-ci rendre une application Freemium. En partant sur ce principe, on peut même imaginer de nouveaux modèles économiques. Un logiciel payant de création pourra par exemple proposer une semaine de test complet avant de limiter son usage au seul export des créations déjà réalisées (afin de ne pas perdre, à la fin du test, la production des jours précédents).

Les utilisateurs pourront régler directement par carte bleue ou via leur facture d’opérateur si un accord été pris entre Microsoft et leur opérateur. Toute la gestion des applications se fera via l’interface développeur. Comme avant, 70 % du C.A. reviendra au développeur, Microsoft et ses partenaires télécoms se partageant les 30 % restant. Le paiement se fera sur une base mensuelle, à partir de 200$ cumulés internationalement.

… mais une validation de contenu toujours obligatoire

Malheureusement, si on trouve davantage de libertés au cœur des possibilités commerciales, il n’en est pas de même concernant la validation des applications avant leur apparitions sur le WP Marketplace. Certaines interdictions se comprennent (comme celle de reproduire du contenu protégé, ou d’encourager la haine), mais d’autres risquent de handicaper la plate-forme.

Il n’y aura ainsi aucun contenu faisant volontairement ou non la promotion de l’alcool, du tabac, des armes et des drogues, aucun contenu adulte (sexe, nudité, en image, texte ou piste audio), aucune application s’apparentant à du piratage (selon qui ?) ou de la violence (la liste des interdits est assez longue : décapitation, morceaux de corps, strangulation, manuels expliquant comment être violent avec un autre être humain… ils sont précis chez Microsoft). Même les injures sont interdites.

De quoi voir de beaux dérapages, à l’instar du MarketPlace d’Apple, avec des interdictions de dictionnaires (contenant forcément des références sexuelles et éventuellement des grossièretés), de jeux (GTA ?) ou de manuels de karaté. Espérons que Microsoft saura être plus fin que la firme de Cupertino…

"Deus Ex : Human Revolution" Trailer

Deus Ex est un excellent jeu, sorti sur PC et Mac en 2000, utilisant de manière novatrice le FPS en y incorporant d’importants éléments de RPG, le tout dans un monde cyber-punk cohérent et autour d’une trame bien ficelée. Dix ans plus tard arrive le troisième opus de la série….

En son temps, Deux Ex fût un véritable succès d’estime mais cela ne se vit pas dans les ventes. Le jeu était très exigeant, donnait beaucoup de liberté au joueur et le grand public n’était pas encore prêt pour ce genre de gameplay. C’est à partir de ces critiques qu’à été élaboré Deux Ex 2, sorti en 2004. Son scénario était fantastique, plein de subtilité et finalement très difficile car il ne mettait pas d’office le joueur dans un camp. D’un joueur à l’autre, les notions de bien et de mal différaient et l’expérience de jeu s’en retrouvait différentes. Malheureusement, pour l’adapter au monde des consoles, le jeu avait été amputé de nombreux aspects RPG et les niveaux étaient à la fois plus petits et plus faciles à appréhender, ce qui déçu la base de fan constituée autour du premier opus. Le titre a été descendu en flammes par les joueurs PC tandis qu’il offrait un amusement sympathique aux joueurs consoles, sans pour autant leur mettre une claque.

Autant dire que le créateur de Thief et de System Shock est attendu au tournant pour ce troisième opus, lui aussi prévu sur PC et consoles…

Deux Ex Human Revolutionn (Deus Ex 3) devrait sortir en 2011. L’univers n’a pas changé et l’on retrouve cette fois-ci un personnage central du nom d’Adam dont les deux bras sont cybernétiques. Je ne sais pas si la trame se déroulera avant Deux Ex, ou dans les vingt ans séparant ce premier opus du second. Manifestement, nous serons encore au contacts de différentes corporations ayant chacune leurs intérêts dans la manipulation de l’humanité…

Le trailer, réalisé par Visual Works (Final Fantasy), présente le jeu et quelques scènes d’action à la façon d’une bande-annonce de film. On en sait donc peu sur le jeu en lui-même, si ce n’est que les premiers screenshots font penser à un mélange d’aventure et d’infiltration façon Splinter Cell. Espérons que Ion Storm ne fera pas la même erreur qu’avec Deus Ex 2 en pensant que le public n’est pas capable d’apprécier un jeu riche et ambitieux. Warren, si tu me lis…

Windows Phone 7 : Tour d’horizon

Windows Phone est un système d’exploitation pour téléphones mobiles présenté par Microsoft lors du MIX 2010 sous le nom Windows Phone 7 Series. S’inspirant des modèles à succès que sont l’iPhoneOS d’Apple et l’Android de Google, Microsoft a fait table rase de son précédent système mobile et souhaite désormais s’imposer comme un acteur majeur du mobile grand public.

Note : cet article a d’abord été publié sur le blog de Nexeo.

Matériel : un cahier des charges très strict

Les constructeurs de terminaux Windows Phone, tels que Samsung ou LG qui ont participé à la réalisation des prototypes présentés au MIX1, voient leur marge d’innovation réduire. En effet, les spécifications des combinés destinés au nouveau système devront respecter certains impératifs : un écran capacitif quatre points WGA d’une résolution de 800 × 480 pixels (une version HVGA de résolution inférieure sera envisagée par la suite), six boutons (« Démarrer », « Retour » et « Recherche (Bing) » auxquels s’ajoutent les désormais traditionnels boutons dédiés à la Photo, au Volume et bien sûr à l’allumage), un processeur ARMv7 Cortex (de 600MHz à 1GHz) ou Scorpion (1GHz), un chipset graphique supportant DirectX 9, 256Mo de RAM, 8Go de mémoire Flash au minimum, un appareil photo 5 mégapixels, un capteur Assisted GPS, un accéléromètre, une boussole, un chipset Wifi, et un module Radio FM. Différentes formes de combinés seront proposées, offrant parfois des fonctionnalités supplémentaires ou améliorées comme un clavier physique ou une webcam en façade.

Capture de l'écran d’accueil de Windows Phone 7 présentant plusieurs tuiles applicatives

Écran d’accueil de Windows Phone 7 présentant plusieurs tuiles applicatives

En imposant un tel cahier des charge, Microsoft s’assure la mise en concurrence des constructeurs sur les prix plutôt que sur les fonctionnalités (limitées par design). À supposer que tous jouent le jeu (après tout, d’importantes opportunités de réalisation de marges existent avec d’autres systèmes comme Android), Microsoft pourrait bien parvenir à faire chuter les prix pour les consommateurs, ce serait une bonne nouvelle dans un marché du SmartPhone assez onéreux pour l’utilisateur (hors subventions des opérateurs de téléphonie mobile).

Métro : le visage de la mobilité made in Microsoft

Windows Mobile 6.5 (rebaptisé Windows Phone Classic), prédécesseur de Windows Phone 7, n’a jamais été reconnu pour son interface. Portage mobile des systèmes d’exploitations Windows, l’interface apportait de nombreuses fonctionnalités mais manquait de convivialité avec ses menus déroulants et ses boutons minuscule qui obligeaient l’utilisateur à sortir un stylet. Tandis que de nombreux professionnels adoptaient ce style discutable, Apple peaufinait l’interface intuitive et tactile de son iPhone montrait que simplicité ne rime pas forcément avec austérité.

Capture de l'écran "Office Hub" (Univers Bureau)

"Office Hub" (Univers Bureau)

Avec Windows Phone 7, finis le Menu Démarrer, les listes interminables d’icônes et les cases à cocher. Microsoft souhaite rattraper son concurrent voire même devenir prescripteur en terme d’interface. Pour cela, l’interface de Windows Mobile a été intégralement supprimée pour céder la place à un projet plus ambitieux nommé Métro. Derrière ce nom évocateur de « modernisme rétro » se cache une interface bien pensée, faisant une grande place aux contenus, aux espaces, aux couleurs primaires et entièrement manipulable au doigt.

Capture de l'écran Application Word pour Windows Phone : saisie d’un commentaire

Application Word pour Windows Phone : saisie d’un commentaire

L’écran d’accueil est facile à lire sans être véritablement novateur dans son contenu. Composé de tuiles représentant les principales fonctionnalités du produit (applications, contacts spécifiques, galerie photo, liste de lecture…), il sert surtout de zone de lecture rapide (des informations pouvant apparaître sur les tuiles, comme les dernières photos de vos contacts) et de point d’entrée vers l’ensemble des modules d’activité du système. Ces modules, appelés Hubs ou Univers, réunissent des données en provenance d’applications ou de services Web de manière à ce qu’elles soient représentées rapidement. Le Hub People réunira ainsi l’ensemble des informations sur vos contacts Facebook, Hotmail, Exchange ou Gmail tandis que le Hub Applications concentrera vos jeux et logiciels récupérés sur le Microsoft Application Store. Pour rassembler ces informations en ensembles cohérents et chargés de sens, Metro fait appel à des paradigmes d’interfaces bien précis comme des larges panoramas ou l’écran se pose comme une fenêtre pouvant se déplacer latéralement ou de haut en bas, des effets de passage d’une page à une autre à la façon d’un jeu de carte ou encore l’usage du défilement différentiel pour créer un effet de profondeur.

L’expérience des Hubs (ou Univers) s’en trouve améliorée et on a vraiment l’impression d’utiliser des méta-applications capables de synthétiser l’information et de la représenter de manière rapide et exploitable sans se soucier de l’origine des données. L’utilisateur a ainsi l’illusion du Cloud2 en parcourant un mélange homogène d’informations pour lesquelles l’expérience utilisateur est exactement la même. L’apprentissage ergonomique des réflexes d’utilisation de l’appareil est donc très rapide, et permet aux utilisateurs d’assimiler la diversité des informations, alors que dans la plupart des systèmes existants aujourd’hui différentes sources de données s’expriment sur différents supports.

Applications : une large ouverture vers le MarketPlace

Le parc d’applications disponibles dans le système regroupe les classiques E-Mail (multi-comptes), Calendrier, SMS/MMS, Téléphone, Contacts, Cartographie et Recherche, avec à chaque fois plusieurs ressemblances : un fort minimalisme, l’appel à une gamme de couleurs très réduite et un ensemble de fonctionnalités simples disponibles immédiatement dans une barre d’icônes en bas de l’écran (navigation dans Internet Explorer, ajout de rendez-vous dans le calendrier…). En faisant glisser cette barre vers le haut apparaissent les options plus complexes. Pour toute tâche relative à la recherche, l’utilisateur se tournera vers le bouton dédié. Contextuelle, la recherche triera vos rendez-vous en mode calendrier ou cherchera dans Bing si vous êtes dans le navigateur ou que vous venez de sélectionner une adresse à géolocaliser. Le navigateur, d’ailleurs, sera une version « 7.5 » d’Internet Explorer. Basée sur le moteur d’IE7, elle offrira la navigation par onglets, le support de Javascript et le zoom par pincement du pouce et de l’index.

Capture de l'écran Application Excel pour Windows Phone : capture du menu contextuel

Application Excel pour Windows Phone : capture du menu contextuel

Le copier-coller et le support de Flash seront absents de Windows Phone 7 à sa sortie. Plus qu’une véritable volonté de ne pas offrir ces fonctionnalités à ses utilisateurs, il semblerait qu’il s’agisse d’un manque de temps au niveau des développements. Cependant Microsoft assure que le système disposera de modules de reconnaissance des éléments interactifs dans les textes : adresses, numéros de téléphone ou images et proposera à chaque fois le comportement adéquat, Adobe annonçant de son côté travailler au support de Flash avec Microsoft. Reste à voir si ces promesses seront tenues et si ces deux absents seront rapidement implémentés, dans un patch du système ou dans une version ultérieure.

Capture de l'écran "Pictures Hub" (Univers Images)

"Pictures Hub" (Univers Images)

Concernant les applications externes et pour la première fois, Microsoft ose l’absence totale de rétro-compatibilité. Qu’on se le dise, les applications développées pour Windows Mobile 6.5 n’auront pas leur place dans Windows Phone 7. Évidemment, cela n’est qu’en partie vrai : on voit mal Microsoft tourner le dos à l’ensemble des partenaires et développeurs ayant travaillé pendant des années à développer des applications en .NET Compact Framework. En réalité, leurs applications ne tourneront pas sur Windows Phone 7 et cela n’est pas plus mal, car elles n’auraient pas du tout été adaptées aux nouveaux paradigmes d’interface de Métro. Leur code métier développé en .NET restera en revanche utilisable dans les programmes .NET en XNA ou Silverlight supportés par Windows Phone. Il n’y aura ainsi que les interfaces à reprendre en choisissant bien son support de développement. XNA s’articule autour du concept de temps réel avec une gestion fine de l’affichage, des rafraichissement et des performances : on le destinera plus facilement aux jeux (XNA est d’ailleurs le langage de développement du XBox Live Arcade). Silverlight facilite la mise en place d’applications respectant le style du système d’exploitation tout en apportant des fonctionnalités riches en termes de médias ou d’animations : on l’utilisera massivement pour les applications à contenus et les services.

Capture de l'écran de l'application Associated Press

Application Associated Press

Si la plupart des applications offertes par le système pourront continuer à tourner en arrière-plan, ce ne sera visiblement pas le cas des applications issues du téléchargement. Le système supportera un gestionnaire d’états, similaire à un gestionnaire de cookies, permettant aux applications de retrouver un contexte lorsque l’utilisateur les ré-ouvrira mais entre les deux, elles ne s’exécuteront pas. Le multi-threading au sein d’une application, quant-à-lui, sera bel et bien supporté en tant qu’élément du Framework .NET. Les notifications dites « push » (comprendre : à l’initiative du serveur applicatif et non du téléphone) devront passer systématiquement par le Microsoft Notification Service et ne nécessiteront pas qu’une application soit ouverte pour être reçues. Leur nombre s’affichera dans une barre en haut de l’écran, de manière non-intrusive tandis que leur lecture passera a priori par une application capable de décoder leur contenu.

Capture de l'écran Univers Microsoft MarketPlace

Univers Microsoft MarketPlace

Toutes les applications devront être récupérées à partir du Windows Phone Marketplace, ce qui provoque déjà chez la plupart des développeurs de grands débats tant la nécessité de déployer des applications ad-hoc pour réaliser des tests est grande. Heureusement, l’environnement de développement Windows Phone représenté par une version spécifique de Visual Studio 2010 propose un émulateur relativement complet. Microsoft aurait reconnu le besoin d’une fonctionnalité de déploiement locale à l’avenir mais confirme son absence dans le système au lancement. Sur le MarketPlace, la politique d’acceptation des applications sera moins restrictive que celle d’Apple et Microsoft a déjà annoncé ne pas empêcher la duplication de fonctionnalités offertes par le système. Rien n’empêchera donc les développeurs de proposer des applications plus pertinentes que celles offertes à l’origine, qu’il s’agisse des clients de communication, de solution de recherche (comme Google) ou de localisation (comme Google Maps), du navigateur ou d’autres fonctionnalités dans la limite des possibilités offertes par les applications externes (dont l’absence d’exécution en tâche de fond).

Capture de l'écran The Harvest, un Hack’n’Slash prometteur pour Windows Phone

The Harvest, un Hack’n’Slash prometteur pour Windows Phone

Mais si le MarketPlace de Microsoft se distingue de celui d’Apple sur ce point, il est en très proche sur d’autres. Ainsi, le partage des revenus sera de 70%-30 % entre les développeurs et Microsoft. Développeurs, qui devront s’acquitter d’une licence annuelle de développement comprenant 5 comptes pour 99$. Le développeur souhaitant proposer des applications gratuites n’aura pas d’autres coûts et pourra ajouter de la publicité. La soumission d’une application payante coûtera en revanche 99$ supplémentaires.

Développements : des portages sur tous les écrans

Le développement sous Windows Phone 7 se réalise via une version spécifique de Visual Studio, en XNA ou en Silverlight mais la plupart des applications seront développées dans ce second langage très orienté interfaces et médias et complètement supporté par les combinés. Il faut ainsi comprendre que les développeurs Silverlight auront très peu de travail pour passer d’une application WPF 3 à une application Silverlight for Web puis à une application Silverlight for Windows Phone. Les développeurs de Seesmic Desktop (un client Twitter pour Windows) ont ainsi confirmé avoir migrer leur application vers Windows Phone en conservant l’ensemble de leur code métier et en très peu de temps.

Capture de l'écran Twin Blades, un jeu XBox Live Arcade porté sur Windows Phone en environ deux semaines

Twin Blades, un jeu XBox Live Arcade porté sur Windows Phone en environ deux semaines

Nous avons réalisé l’expérience en interne en développant une application très simple permettant d’afficher la disponibilité des VCub (vélos en libre service sur Bordeaux). Mise-à-part quelques contraintes sur la sécurité des appels aux Web Service (pour Silverlight Web comparé à WPF et Silverlight for Windows Phone), le code métier est exactement identique sur les trois plate-formes. Des modifications mineures ont dûe être apportées sur la partie XAML (le langage de description de l’interface, construit à partir de balises XML) car son support n’est pas exactement identique. Au final, cette application comportant 4 écrans et développée en une demi-douzaine d’heures a été portée sur les trois plateformes en moins de 30 minutes. Côté XNA, les migrations sont également très rapides et promettent de grands moments de jeu (certaines vidéos de The Harvest ou de Twin Blades montrent déjà le potentiel de la machine), de nombreuses applications existant déjà pour le Zune HD et la XBox 360.

Capture de l'écran Émulateur Windows Phone 7, très fidèle au système

Émulateur Windows Phone 7, très fidèle au système

Mais la compatibilité des plate-formes n’est pas qu’ascendante. Microsoft s’est ainsi engagé à supporter Silverlight pour les développements XBox, permettant aux développeurs d’applications Windows Phone de les voir à moindre frais apparaître sur les écrans de télévision en plus des écrans d’ordinateurs. Microsoft dépense beaucoup d’énergie pour unifier son écosystème de développeurs autour d’expérience utilisateur riches et partagées entre plusieurs matériels, le tout en conservant les avantages de son environnement de développement Visual Studio et du Framework .NET : une très importante communauté arrivée à maturité, de fortes capacités multimédia et des bibliothèques de contrôles RIA riches et innovantes, dont certaines Open-Source.

Conclusion : une stratégie intéressante, mais qui oublie le Web

Windows Phone 7 s’annonce comme un acteur de poids dans le monde du Smartphone, sans en révolutionner les paradigmes. Livré avec des fonctionnalités prometteuses, il sera vite enrichi de nombreuses applications issues des années d’expérience de l’écosystème de développeurs .NET rompus à Silverlight et XNA. Cependant, certaines absences (le copier-coller par exemple) et choix commerciaux (dont les frais pour la soumission d’applications) laissent une impression mitigée, d’autant que dans ce paysage de bonnes intentions et de promesses technologiques, très peu d’informations concernent HTML5 et le support des applications Web. Windows Phone 7 s’ajoute ainsi à la liste des smartphones pour lesquels les développements avancés nécessiteront une implication spécifique et donc une multiplication des coûts de développement, fussent ceux-ci rapides et facilités par la maturité d’un IDE qui a fait ses preuves.

  1. Le MIX est une conférence annuelle de Microsoft à destination des développeurs et créatifs Web durant laquelle l’entreprise dévoile ses dernières technologies ↩

  2. Le Cloud Computing ou Informatique Dématérialisée est un concept utilisant l’ensemble de la puissance, de la mémoire et des services disponibles sur Internet ou sur un autre réseau pour simuler l’existence et la persistance de programmes et de données sur le matériel de l’utilisateur ↩

  3. Windows Presentation Foundation, une couche de .NET utilisée pour le développement d’applications de bureau Windows proche de Silverlight ↩

Phrases Insolites… #18

C’est fou ce qu’on peut entendre quand on tend l’oreille !

Barbe de 3 jours

Tu piques fort aujourd’hui… je peux t’appeler Gratounette ?

Ingénieurs Vs. Commerciaux : Fight !

— Tu fais quoi ce WE ?
— Je vais à une cérémonie de remise des diplômes d’une Ecole de Commerce.
— Ah, c’est bien. C’est important qu’ils rencontrent des gens qui ont un vrai métier.

WithoutFx

— Hagrid dans Harry Potter, ils le grandissent avec des bons angles de caméra, non ?
— Ah non, je pense que c’est numérique. Ils peuvent rajouter un dragon dans une scène, alors ils peuvent bien agrandir un mec.
— Ah, tu penses ? Ben si ça se trouve, Rocco, c’est pareil. Non ?

Bolidage

Je ne comprends pas pourquoi mais le tuning sur Kangoo, c’est pas super développé.

[HTML5] Barre latérale

Ces derniers jours, deux ouvrages alimentent mes temps libres: Dive Into HTML 5 de Mark Pilgrim que je lis directement à cette adresse et Transcender CSS, d’Andy Clarke, acheté chez Amazon.

En commençant à réaliser une ébauche de thème Wordpress tirant partie d’HTML5, je me suis posé quelques questions concernant la barre latérale.

HTML5 apporte son lot de nouvelles balises, dont nav et aside. L’élément nav représente une section de la page qui contient des liens vers d’autres parties du site, y compris dans la page courante. Il sera courant d’y placer les liens de l’en-tête (qui définissent en général la navigation principale) ou du pied de page (qui renvoient à des éléments secondaires ou légaux). L’élément aside représente une section de contenu distinct mais néanmoins relié au contenu englobant. Il peut être utilisé pour des effets typographiques comme les citations incrustées, les barres latérales ou tout autre contenu pouvant être séparé du contenu principal.

Après de telles définitions, le découpage est aisé : au sein d’une balise section définissant le corps du site, la barre latérale sera contenue dans un élément de type aside. Attention cependant, tout ce que contient votre barre latérale n’a pas vocation à être contenu dans un élément nav !

Une capture de la sidebar du blog au moment où j'écris ces ligne, avec des zones numérotées

La barre latérale de boris.schapira.dev

Prenons l’exemple de la barre latérale de ce site au moment où j’écris ces lignes. Les éléments 4 et 7 sont manifestement destinés à accueillir des éléments de navigation mais cela n’est pas le cas des éléments 1, 2 et 6 qui contiennent des sections indépendantes mais informatives sur le site. Plusieurs div feront très bien l’affaire. Les sections 3 et 5, enfin, sont des listes de liens. En tant que listes, elles seront contenues dans des éléments ul, li et évidemment a auxquels auront été ajouté l’attribut rel="external", dédié aux liens externes.

Comme vous le voyez dans cet exemple très simple, HTML5 apporte de nouvelles balises qui vous permettront de définir un meilleur découpage sémantique de vos contenus, facilitant leur identification par les navigateurs et améliorant l’accessibilité de votre site. Vivement demain !

En province

En ce moment, j’ai plein d’envies. Depuis que je suis parti de Paris, en fait. Avec plus de deux heures par jour passées sous terre, la Ville Lumière me rendait surtout aveugle. Depuis mon retour à Bordeaux, je vois à nouveau et je respire.

Du coup, j’ai plein de projets. Au niveau professionnel d’abord, puisque de nouveaux défis se présentent chaque jour et que j’ai l’impression d’avoir plus de temps pour ma veille technologique et mes lectures d’auto-formation (en ce moment, je sautille de Silverlight for Windows Phone 7 à HTML5, quand je ne lis pas des bouquins sur le CSS. C’est très enrichissant).

Au niveau personnel ensuite, puisqu’il va être temps pour me femme et moi de nous trouver une maison ou un appartement et que ça n’est pas une mince affaire à trouver (propriétaires d’un 75m² sur Bordeaux cherchant à vendre, n’hésitez pas à me contacter !). Je prends aussi un peu de temps pour m’amuser et je re-découvre les jeux vidéos sur ma PS3 (une belle console moderne sur laquelle je joue aussi bien à Uncharted2 qu’à… l’Odyssée d’Abe !).

Et puis revenir à Bordeaux, c’est aussi l’occasion de reprendre contact avec les amis perdus de vue. Ça n’est pas évident, après autant d’années d’absence, mais le jeu en vaut la chandelle. J’en profite aussi pour me rapprocher de la famille en allant passer des week-end au frais chez mes beaux-parents ou en m’invitant chez les miens quand j’ai la flemme de préparer le dîner (ce qui est quand même bien pratique, vous en conviendrez).

Bref, je crois que même si mes copains parisiens me manquent, je suis beaucoup plus heureux ici. Et ils sont les bienvenus à la maison quand ils le désirent. On ira faire un pic-nic au Jardin Public avant d’admirer le miroir d’eau en dégustant un bon verre de vin.

Le Paradoxe du Smartphone

Il y a quelques semaines a été annoncé Windows Phone 7 Series, devenu depuis Windows Phone 7. Plus qu’un simple OS, il s’inscrit dans une stratégie plus massive d’établissement d’un écosystème entre développeurs, éditeurs, constructeurs et clients autour d’une place de marché unifiée, comme ses concurrents Apple et Android…

En ce moment, je suis en plein paradoxe. D’un coté, le système me séduit car il parle ma langue (le .NET) et offre des opportunités business alléchantes (notamment avec le développement multi-écrans). De l’autre, je trouve que HTML5 apporte énormément de choses et j’espère qu’il sera massivement adopté, notamment pour le développement d’applications de bureau ou mobiles. Enfin, j’apprécie énormément la liberté offerte par un système comme Android, tant au niveau des développements qu’au niveau business (il y a tout à faire !).

Alors quand je vois Apple qui verrouille son système (aussi agréable fût-il, je ne critique pas cet aspect-là), qui y interdit sauvagement des milliers d’applications (alors que l’application ouvrant l’accès au contenu le plus dangereux reste quand même Safari), qui le coupe des frameworks multi-plateformes qui pourraient y apporter des processus d’industrialisation logicielle (qu’il s’agisse d’Adobe CS5, de MonoTouch, de Titanium ou des autres), qui muselle même les développeurs sur la description de leurs applications et qui continue à en vendre des camions entiers un peu partout dans le monde, je m’interroge sur les véritables raisons qui font que les gens achètent un smartphone. Je pense de plus en plus qu’elles n’ont rien à faire avec la qualité intrinsèque du mobile proposé, mais davantage avec les interactions sociales qu’il va créer, soit parce qu’on aura l’impression de rejoindre une communauté, soit parce qu’on appréciera (consciemment ou non) son côté « signe extérieur de richesse ».

Pas besoin de 150 bons développeurs pour faire acheter des smartphones.

Un seul Steve Jobs suffit.

[PS3] Heavy Rain

Heavy Rain est une exclusivité PS3 réalisée par Quantic Dream, studio à l’origine de Fahrenheit et The Nomad Soul, deux excellents jeux ayant reçu à leur sortie de bonnes critiques sans rencontrer leur public. Heavy Rain ne dérogera pas à la règles. Certains adoreront, d’autres détesteront. Car Heavy Rain n’est pas vraiment un jeu vidéo mais une nouvelle implémentation du concept de loisir interactif.

Scénario

Lorsqu’un tueur en série s’en prend aux enfants d’une petite ville tranquille, quatre personnes se retrouvent plongées dans une enquête destinée à sauver la dernière proie du meurtrier, le jeune Shaun. Tandis que le père de l’enfant cherche à le sauver tout en portant un fardeau trop lourd pour lui, une journaliste, un agent du FBI, un détective privé et la mère d’une des précédentes victimes tentent eux-aussi de retrouver le coupable avant qu’il ne soit trop tard. À partir de cette trame se construit une histoire « élastique » qui, si elle terminera toujours à l’échéance imposée par le tueur, se déroulera différemment pour chaque joueur, avec une conclusion déterminée par les décisions prises en cours de jeu. Dans Heavy Rain, il n’y a pas de Game Over. Le joueur appuie ou non sur le bon bouton au bon moment et cela influence l’histoire dans un sens plutôt que dans un autre. Cette profusion de choix a pour conséquence de placer le joueur dans des situations critiques où ses propres émotions se mêlent à celles des personnages.

Capture et « Jeu » des personnages

Les personnages de Heavy Rain ne sont pas des modèles 3D complètement imaginés par des professionnels mais bien de vrais acteurs modélisés et transformés en personnages virtuels. Si la technique pourrait sembler intéressante à première vue, elle montre ses limites durant les déplacements des personnages, légèrement saccadés lorsqu’il s’agit de dévier d’une direction donnée. En revanche, l’ensemble des gestes effectués pour saisir un objet ou parlé est tout bonnement bluffant de réalisme. Et cela n’est rien en comparaison des visages qui sont de vraies œuvres d’art. Les écrans de chargement séparant chaque chapitres sont d’ailleurs des moments précieux, puisque les développeurs offrent alors aux joueurs l’occasion de regarder ces visages de près et d’apprécier leur réalisme.

Réalisation & Photographie

Ces deux termes, qu’on ne retrouve pas dans tous les jeux, s’appliquent parfaitement à Heavy Rain. Comme le titre du jeu l’indique, l’ensemble de l’action se déroule dans un environnement sans cesse écrasé par une pluie battante qui ternit non seulement les lieux mais aussi les vies. Chaque personnage, incarné par le joueur ou secondaire, se retrouve confronté à ses angoisses et aux aspects les plus glauques de sa vie. Cet aspect angoissant du scénario se retrouve très bien dans la photographie du jeu, terne et ruisselante. Alternant entre scènes figées et split-screen lors des moments critiques, la réalisation audacieuse n’a rien à envier au monde du cinéma.

Interactivité

Jouer à Heavy Rain, c’est accepter de sacrifier une partie de sa vie de joueur. Si la récompense est au rendez-vous, il n’en reste pas moins que le jeu est assez frustrant. Les personnages, si réalistes dans les cinématiques utilisant le moteur du jeu, sont de vrais boulets lorsqu’il s’agit de contourner un canapé pour attraper un paquet de chips. Mais les premières minutes sont les plus douloureuses et le manque d’interactivité, qui donne parfois l’impression d’être revenu à l’époque de Dragon’s Lair, cède vite la place au sentiment profond d’être un acteur de l’intrigue et d’être le seul à pouvoir choisir son déroulement. Mais rassurez-vous, une fois fini, il est possible de recommencer à n’importe quel chapitre pour déterminer les conséquences de choix différents.

"Métronome", Lorànt Deutsch

Il y a quelques années, j’étais allé voir Victor les enfant au pouvoir, avec Lorànt Deutsch. À la fin de la représentation, mon père avait emmené ma grand-mère et mes frère et sœur rencontrer les acteurs, dont Deutsch lui-même. Sa rencontre les avait enchantés et j’ai toujours gardé depuis une certaine sympathie pour l’acteur.

En ramenant le camion à Paris après mon déménagement à Bordeaux, je me suis retrouvé à écouter « C’est quoi ce bordel », une hilarante émission de Laurent Baffie où étaient invités Geneviève de Fontenay, les frères Bogdanoff et Lorànt Deutsch pour parler de Paris et de son histoire.

M’est apparue alors une facette complètement différente du personnage. Deutsch est un passionné d’Histoire, cultivé et drôle. Il expliqua à plusieurs reprises des anecdotes passionnantes sur la capitale en y attachant toujours une pointe d’humour et parfois une dose de nostalgie.

L’investissement dans son best-seller (plus de 300 000 exemplaires !) « Métronome : L’histoire de France au rythme du métro parisien » n’a pas trainé. De station en station, l’auteur nous explique la ville de façon chronologique, même si quelques anecdotes plus modernes viennent parfois bousculer des chroniques du passé. On y apprend beaucoup, on rigole souvent. L’Histoire y apparait, et c’est important dans un ouvrage du genre, légère et finalement, assez contemporaine.

Je voudrais tout de même corriger une assertion qui transpire dans le titre et l’ouvrage en général : l’histoire de France n’est pas l’histoire de Paris ! C’est bien une mentalité de parisien, ça ! :)

P.S.: J’ai conseillé ce livre à quelques personnes dont Teulliac, qui s’est empressé de le dévorer et d’en faire un très bon article (avec le générique des Intrépides, c’est dire). L’article de Teulliac sur Métronome.

Jeux vidéo responsables

Une polémique enfle depuis quelques temps autour d’une scène particulièrement violente du jeu à succès Modern Warfare 2 dans laquelle le joueur, incarnant un soldat, se retrouve au cœur du génocide de la population d’un aéroport, contraint d’exécuter froidement l’ensemble des civils présents pour réussir sa mission.

Beaucoup ramènent l’expérience au même rang qu’un GTA et de dire qu’elle favorise la violence des jeunes. Pourtant, le jeu présente une classification qui devrait normalement alerter les parents un minimum attentifs aux occupations de leurs enfants (mais moi je dis ça…). Avant la scène en question, un message indique qu’il s’agit d’un niveau violent psychologiquement qui peut être passé. Enfin, la scène intervient au cœur d’un scénario dont elle est une conséquence logique, et qui met le joueur dans une situation extrême mais surtout d’une responsabilité écrasante qui découvre ainsi que la violence n’est pas gratuite et qu’elle a moralement un prix.

Je trouve donc, au contraire, très positif de choquer des joueurs habitués à des jeux de tirs où le meurtre est gratuit. Je suis très heureux que l’industrie du jeu vidéo prenne ses responsabilités en montrant et en faisant ressentir aux joueurs cette violence qu’ils balayaient jusqu’à présent d’une rafale de Uzi.

Je viens d’acheter Heavy Rain, un jeu dont j’attends beaucoup dans le registre de la violence psychologique, au même titre qu’un bon thriller. Les premières minutes sont oppressantes à souhait, d’une violence subtile et omniprésente.

P.S. : A noter, comme si ces deux-là étaient faits pour s’entendre, que le producteur d’Heavy Rain est venu apporter son soutien aux développeurs de Modern Warfare 2 à propos de cette fameuse scène.

Emploi, précarité, stages et auto-rêve

Aujourd’hui en France, certains luttent contre la précarité et essaie de s’assurer un quotidien prévisible grâce à un emploi stable. Pas d’emploi ou une période d’essai en cours, c’est l’impossibilité de souscrire un prêt à un taux raisonnable, des difficultés pour louer un appartement, l’incertitude de savoir si on pourra payer les courses du mois prochain. La crainte du chômage rend les gens suspicieux. Et on se prend à rêver de réussite facile, pour sortir des emmerdes.

Alors certains se disent qu’ils pourraient devenir très bons dans leurs domaines de compétences et monter leur propre boite. Mais ils oublient qu’une bonne idée et beaucoup de travail ne suffisent pas à devenir entrepreneur. Ça se réfléchit, ça se prépare et ça demande des connaissances bien spécifiques. Et pendant que certains luttent pour un CDI qui en coûte deux à l’employeur, d’autres prostituent leurs services pour faire vivre leur auto-entreprise.

Mais comment leur en vouloir ? Après des années passées à se faire prendre pour des cons dans des stages qui n’en sont pas, sous-rémunérés et sur-responsabilisés ?

Défonce-toi et tu auras peut-être un CDD ou un CDI après un renouvellement de ton stage de 6 mois. On changera juste l’intitulé du poste pour que tu fasses quand même six mois de période d’essai. Au final, ça ne fait jamais que 18 mois à 340 €/mois avec les responsabilités de quelqu’un qui en gagne 2500. Tu vas voir, ça va être génial.

Il n’y a pas à dire, comme premier contact avec le monde de l’entreprise, ça laisse rêveur. On marche sur la tête.

Une leçon d’Histoire

Mon père est juif, ma mère est catholique. Aucun des deux n’est pratiquant aussi à l’heure du choix me concernant, ils ont préféré ne pas le faire. Du coup, je ne me posais pas vraiment de questions sur la foi, mais plutôt sur l’Histoire de ma famille. Chaque fois que j’abordais mes origines, on me parlait systématiquement d’Israël. Je ne comprenais pas bien les enjeux issus de l’instauration d’un État juif sur les territoires palestiniens mais j’avais saisi que tout ça me dépassait franchement. En grandissant, j’ai eu la chance d’avoir des professeurs d’Histoire-Géo extraordinaires qui m’ont fait connaître la politique (ce qui ne veut pas dire qu’ils politisaient leurs cours, une nuance qu’on oublie souvent), la vie civique et le sens critique. L’un d’entre eux m’a particulièrement marqué.

Alors que nous abordions le conflit Israëlo-Palestinien au travers de la crise pétrolière de 1973 et de la guerre de Yom Kippour, mon besoin d’en savoir plus s’est manifesté par une très grande quantité de questions (parfois redondantes) sur chaque point abordé. Avec le recul, je comprends l’effort qu’a dû faire mon professeur pour ne pas venir m’exploser la tête contre mon bureau (petit clin d’œil à mes amis professeurs qui se retiennent chaque jour)… Au lieu de ça, il m’a demandé de noter mes questions et de venir le voir à la fin du cours.

Tout le monde est sorti et je suis arrivé avec ma feuille. Il m’a regardé droit dans les yeux, d’un regard provoquant quand je lui connaissais bien et m’a dit de sa voix cynique :

Tes questions sont complètement connes.

Son regard m’a glacé le sang tandis que mes oreilles devenaient brûlantes de rage et de honte. Il a enchaîné avec sa gouaille habituelle :

Si je répondais à toutes tes questions, t’en ferais quoi ? Tu apprendrais ce que je te dis comme un benêt ? Pour comprendre quelque chose, il va t’en falloir plus que ça sinon tu vas encore devenir un de ses petits cons qui répètent ce qu’on leur dit de répéter. Dégage, je vais voir ce que je peux faire.

Intimidé, je suis parti sans rien dire et très rapidement. Nous n’en avons plus reparlé. J’étais honteux d’avoir posé des questions qui, avec du recul, me semblaient en effet stupides. De son côté, le professeur ne manifestait aucune intention de partager quelque chose de plus avec moi. Je me faisais tout petit sur ma chaise.

Une douzaine de jour plus tard, nous avons reçu à la maison une grosse enveloppe. Elle contenait des dizaines de photocopies d’articles parus entre 1920 et 1985 sur la(les) religion(s), la politique et l’économie au Proche-Orient, des photocopies de divers livres d’Histoire édités à différentes époques (avec des éléments parfois très différents) et des biographies d’hommes politiques marquants.

Il n’y avait rien d’autre. Aucun mot, aucune adresse au dos de l’enveloppe, aucune consigne, aucune indication de la façon dont lire tout ça. J’ai tout étalé par terre dans ma chambre, j’ai essayé de recouper des choses, j’ai beaucoup lu. Chaque nouvelle pièce soulevait une nouvelle question mais petit-à-petit, et avec le temps (ça m’a bien pris 5 ou 6 jours pour tout lire), des briques de compréhension se sont mises en place et je me suis construit ma vision des choses.

Après plusieurs semaines, je suis allé parler à mon professeur. J’ai juste dit merci pour l’enveloppe, avant d’aller m’asseoir. Je ne savais pas quoi dire de plus. Depuis son bureau, il m’a regardé avec un petit sourire amusé, d’un air qui semblait me dire que je n’avais encore rien compris, mais qu’au moins maintenant j’avais les clés pour le faire.

Windows Phone 7 : où sont les applications ?

Microsoft a présenté hier, lors du Mobile World Congress, son nouveau système d’exploitation pour mobiles nommé Windows Phone 7 Series. Avec son interface prometteuse, ses concepts d’utilisation inédits et sa forte intégration de composants Web en temps réel, l’OS a séduit sans révolutionner. Mais concernant les applications, le flou reste total…

L’interface, doté d’un design carré très original, se manipule via un défilement vertical ou horizontal suivant le contexte. L’écran d’accueil, très personnalisable, présente des vignettes claires reliées à Internet pour une actualisation des données en temps réel. Elles permettent d’activer des fonctionnalités du téléphone comme les « hubs », des endroits où vous accédez à tous vos éléments d’un même type (contacts, médias, applications…). Un effort particulier a été accordé à la lisibilité et à l’ergonomie et on note une forte intégration du contexte dans la navigation qui rappelle, et c’est bien normal, Zune ou Windows Media Player. Une sorte de téléphone intelligent et sensible, qui s’adapte à l’utilisateur en fonction de ses habitudes, de son réseau social et de sa position. Reste à voir ce que cela donnera à l’utilisation.

Ce qu’il manquait à cette grandes messe en l’honneur du nouvel OS, ce sont les informations nécessaires aux développeurs pour commencer à produire des applications. WP7 supportera-t-il Flash (c’est la question à la mode en ce moment) ou Silverlight (ou les deux), exécutera-t-il des applications .NET Compact Framework, permettra-t-il le multitâche ? Je ne sais pas quoi en penser. D’un côté je me dis que Microsoft ne ferait jamais un nouvel OS disposant de moins de fonctionnalités que le précédent (Windows Mobile 6.5.3 qui supporte Flash et le multitâche). De l’autre, Windows Mobile est-il vraiment un exemple à suivre par Microsoft ? Je ne le pense pas.

Des captures d'écran sur Windows Phone 7

Le Hub People devrait réunir toutes les informations de vos contacts

Je suis sceptique. Ce système a un très gros potentiel et je n’imagine pas qu’il puisse s’affranchir d’applications permettant aux gens d’en personnaliser l’utilisation. Mais pour que ces applications soient disponibles rapidement après la sortie des téléphones, encore faudrait-il qu’on puisse commencer à les développer.

1979 : bientôt l’informatique au quotidien

Si vous avez des idées sur comment utiliser ces ordinateurs, vous pouvez prendre contact avec cette mission.
Arlette Chabot

Dans de document trouvé sur l’INA, Arlette Chabot nous présente l’informatique du futur… Mais pour l’instant, nous n’en sommes qu’aux balbutiements. D’ailleurs, un nouveau magazine est en cours de parution pour traiter de ce sujet qui n’intéresse probablement pour l’instant qu’une poignée de geeks. Jean-Pierre Nizard en est l’éditeur, Bernard Savonet le rédacteur en chef et Jean-Luc Verhoye le directeur. Son nom ? L’Ordinateur Individuel bien sûr !